苏姿丰给AMD准备了另一把“增长密钥”
11月初,AMD交出了一份亮眼的三季报,其中数据中心业务单季收入85.46亿美元,同比增长97%,营收占比达到64%。AMD正式进入“数据中心时间”。 支撑AMD“数据中心时间”的两个关键业务线,是Instinct系列GPU和EPYC处理器。 AMD 董事会主席及首席执行官苏姿丰博士在业绩声明中说,Instinct系列
11月初,AMD交出了一份亮眼的三季报,其中数据中心业务单季收入85.46亿美元,同比增长97%,营收占比达到64%。AMD正式进入“数据中心时间”。
支撑AMD“数据中心时间”的两个关键业务线,是Instinct系列GPU和EPYC处理器。
AMD 董事会主席及首席执行官苏姿丰博士在业绩声明中说,Instinct系列GPU和EPYC处理器需求持续强劲,随着Helios整机柜和“Venice”(第六代EPYC)扩产,四季度还会加速。
美国当地时间11月4日的“AMD In Depth”技术日上,来自EPYC等业务线的负责人,详细介绍了今年EPYC产品线的新特性,以及过去八年时间整个服务器CPU芯片业务从0到1,性能逐步进化直至最终帮助AMD进入“数据中心时间”的历程。

AMD官方材料的六代EPYC演进图:2018年Naples到2026年Venice。
根据AMD披露的数据,从2018年的Naples排到今年的Venice,单颗SoC吞吐涨了约20倍。
性能的暴增推动了数据中心业务收入的大涨。“年初服务器CPU份额还在40%出头,现在到了40%中段,每周都有新客户改用EPYC。” AMD 服务器产品副总裁Madhu Rangarajan开场说。
AMD 高级副总裁及计算与企业AI事业部总经理Dan McNamara说,企业和云两边营收同比上一年度翻倍,“第五代Turin是EPYC史上爬坡最快的一代。”
CNBC财报后的分析中指出,靠整机柜设计和服务器CPU上的积累,AMD正成为大型科技公司AI算力供应链里的“第二来源”。
过去,GPU拿走了大部分算力需求的注意力。现在,AMD希望通过一场技术日,来详解AI数据中心中CPU在模型、Agent时代所扮演的角色,以及为什么也是驱动AMD进入“数据中心时间”的引擎。
01 一颗CPU,拆成四个平台
第六代EPYC代号Venice、型号9006系列,共用Zen 6架构,按功耗、内存、IO和缓存拆分成Venice 9006 SP7、Venice 9006 SP8、Venice-X 9006X SP7、Verano 9006 LP,对应性能、企业、HPC等不同平台。
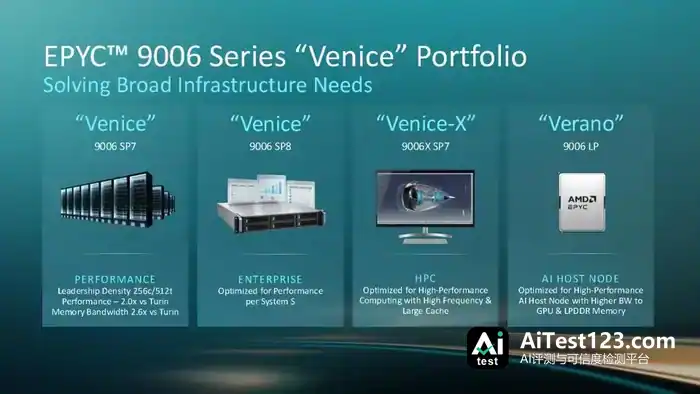
官方材料把第六代EPYC切成四个平台,对应性能、企业、HPC和AI头节点。
最先出货的是Venice SP7,也是这一代的旗舰。采用Zen 6c核心时最多256核512线程,用高频Zen 6核心时最多96核192线程;16通道DDR5,支持MRDIMM 12.8GT/s,官方给出的峰值内存带宽是1.6TB/s,约是第五代614GB/s的2.6倍;单路96条、双路最多128条PCIe Gen 6通道,全部支持CXL 3.1;插槽76×80毫米,功耗档从400W到600W。
SP8面向企业、存储、边缘和电信,核心数覆盖8到128核,内存通道减半到8条但每通道可插两条DIMM,PCIe Gen 6通道反而更多(单路128条、双路最多192条),插槽缩到62.5×80毫米,功耗上限400W,计划2027年上半年出货。
AMD透露,SP7与SP8用了两颗不同的IO die,分别对应两类市场在算力与IO上的需求。做这种差异化的拆分来自客户需求的不同——客户要的是每系统美元性能的平衡,不是峰值算力。
排在2027年下半年的还有两个:Venice-X 9006X SP7、Verano 9006 LP。
Venice-X支持3D V-Cache——把一块额外的 SRAM缓存裸片垂直叠在 CPU 计算裸片上方,两层贴合封装,最多96核、1152MB L3缓存,频率仍到5.3GHz,兼容SP7插槽,主攻EDA、CFD这类吃缓存的技术计算;Verano是专门的AI头节点,改用24通道LPDDR5X和可现场更换的SOCAMM模块,最多192核,核心目标是把CPU到自家GPU的互联带宽拉高。
“你没法用一颗、两颗或者三颗SKU去支撑AI,那样给不到客户真正需要的东西。”Dan McNamara如此解释客户需求差异背景下所做的SKU分拆。
在AMD计算与企业AI高级副总裁Ravi Kuppuswamy看来,智能体流水线可以拆成不同的阶段,多个环节都要CPU支持,对CPU的依赖又存在差异,“智能体AI不是一种负载,也不是单独一颗CPU能服务得了的负载。”
需求差异化在OEM合作伙伴圆桌上体现得更为明显。
技术日第二天,AMD公司副总裁,企业业务事业部Derek Dicker主持的OEM圆桌上,不仅提到了AI预算与传统数据库负载的差异,也强调二者不应该分割成孤立的基础设施池。
“不是所有人都需要法拉利,如果我需要的是校巴,那我就需要校巴,你得想办法让法拉利和校巴配合好。”HPE主流计算副总裁John Carter说。
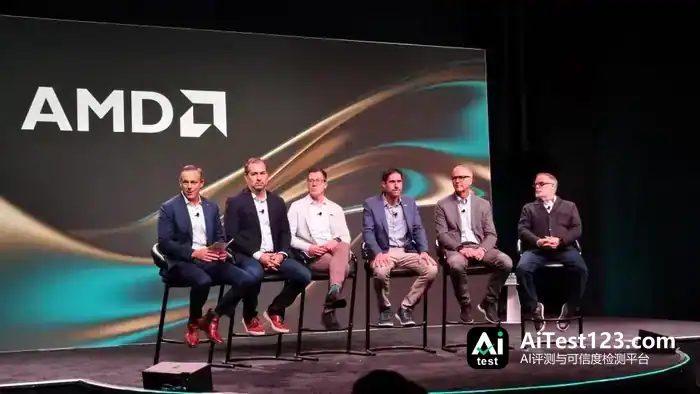
左起依次为AMD公司副总裁,企业业务事业部Derek Dicker、Dell计算基础设施副总裁David Schmidt、HPE主流计算副总裁John Carter、Lenovo基础设施解决方案集团(ISG)产品管理负责人Scott Patty、Supermicro市场营销与网络安全副总裁Mike McNerney、Cisco数据中心产品管理负责人Todd Brennan
Supermicro市场营销与网络安全副总裁Mike McNerney透露:基于现有的平台,公司规划了20个SKU,有人要更多IO接GPU,愿意牺牲内存,有人反过来要最大容量的内存。Lenovo的Scott Patty也表示,同一颗SP7,既能做成100%液冷无风扇的高端HPC机型,也能做成标准2U单路机。
02 Zen 6改了什么
“我不会假装早知道智能体计算会来,但我们一直相信CPU在软件栈里始终会有位置。”AMD高级副总裁、企业院士及首席架构师Mike Clark在演讲开场提到AMD在服务器CPU路线上的押注。
对应这一代EPYC产品线,底层是同一套Zen 6架构。
Mike Clark指出,新一代产品在设计上的约束:频率、IPC(每时钟周期指令数)、面积、功耗四件事互相打架,推高频率会压低每周期能做的活、也会吃掉面积和功耗。这一代的做法是从Zen 5打下的新基础上继续加宽——8宽发射、6个ALU、每周期4次内存操作,操作缓存从6K条指令扩到6.75K个操作,重排序缓冲从448条增到640条,分支预测返回栈从52项增到64项。
可以这么理解,AMD的做法是在维持频率的情况下,让同一个时钟周期内同时开工的指令变得更多了,这也是2nm工艺下晶体管数量提升带来的好处之一。
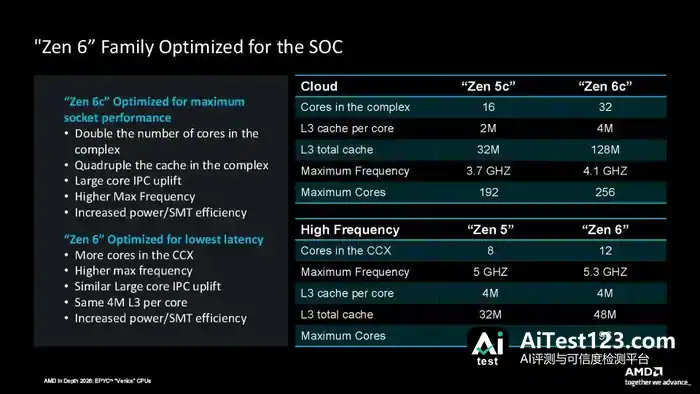
官方对照:Zen 6c为每路吞吐优化,Zen 6为最低延迟优化
Zen 6c的一个CCD从上一代16核翻到32核,L3从32MB增到128MB;主打高频Zen 6的CCD从8核增到12核、48MB L3,两种CCD都用台积电N2工艺。如前文所述,Venice-X之所以拥有1152MB L3,是8个CCD各堆到144MB累加的结果。
频率上,Zen 6c从3.7GHz提到4.1GHz以上,Zen 6从5.0GHz提到5.3GHz;固定频率测试下,企业与云负载IPC约涨20%,AI负载约31%。
不过,Mike Clark自己强调,没有一个数字能覆盖所有负载。
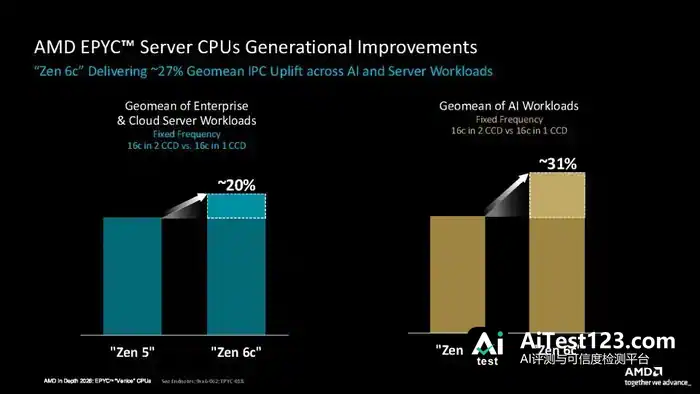
官方固定频率测试:企业与云负载IPC约提升20%,AI负载约31%。
把核心数堆到256颗并不是最难的部分。
AMD负责服务器架构的高级院士及公司副总裁Mahesh Subramony说,他们不希望客户得把256颗核全填满才拿到像样的性能——真实负载里,这些核很少一起跑满,功耗预算得在满载和半空闲之间来回分配。
与此同时,整颗芯片的电也不是全给核心,IO die、内存控制器和片间互联先分走一部分,剩下的才由核心分。
架构设计初期,AMD的预期是600W、256核全部开工时,每个核心大约摊到1.7W,现场公布的大部分性能数字就在这个条件下测得。但真实负载常常只有三成核心在跑,总预算不变,闲着的核不分电,在跑的每个核心就能拿到约3.5W。多出来的电要能立刻换成频率,所以Zen 6c虽然是密度核,频率也得推到4.1GHz以上。
换到400W档,每核预算进一步降到略高于1W。这时只能靠先进制程和先进封装把芯片其余部分的耗电压到最低,把份额尽量留给核心。技术问答里还给过一个估算:片间搬1TB/s带宽大约耗8到10W,若改用普通封装链路铺够同样的带宽,大约会吃掉整体功耗预算的10%。
“功耗就是性能。”Mike Clark在同一场技术问答里说,如果IPC涨20%而功耗涨30%,那就是在倒退。
03 离不开的话题:存储成本
过去一年多,AI服务器对内存芯片的需求挤压了PC内存供应,推高了价格。
Dan McNamara在次日的Keynote上说,“我们和企业客户的十次对话,十次都在谈内存,谈供应也谈成本。”现场演示的PPT中也提到,对主流双路服务器来说,2026年决定成本故事的不是CPU,也不是GPU,是DRAM。
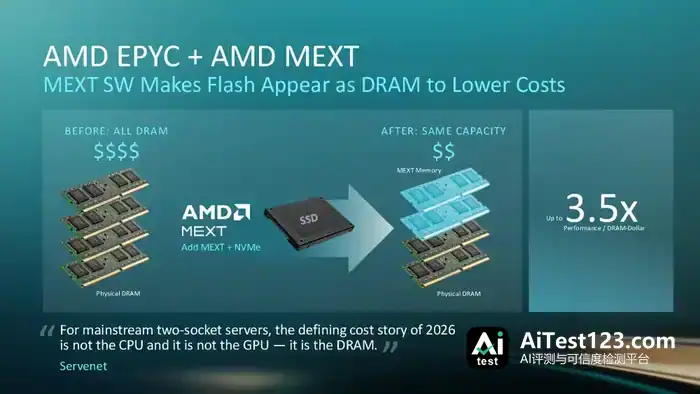
MEXT将大幅压缩服务器对DRAM的依赖
对这个问题,AMD给出了自己的解法:MEXT,一项来自AMD前员工Gary Smerdon创立的公司研发的技术(2026年6月被AMD收购),你可以把MEXT理解为“将Flash虚拟为DRAM”的技术。
Gary Smerdon目前在AMD担任计算与企业AI业务拓展公司副总裁。他在演讲中透露,DRAM每GB成本从1974年的约5000万美元压到2012年的约8美元,最近一年缺货又推回每GB约50到60美元。DRAM保守占服务器成本60%到70%,大内存系统能到80%到90%,然而Azure的论文表示,一半虚拟机从未访问超过一半内存。
面对价格高企的现状,MEXT尝试通过纯软件的方式,降低对DRAM的依赖——Linux驱动把冷页(超过5分钟未访问)透明卸到专用NVMe闪存,一组AI模型预测哪些页快要用到、提前搬回DRAM,应用和操作系统“以为它们一直都在内存里”。代价则在闪存这一侧——每bit成本约是DRAM的1/50、功耗约1/30,延迟却高约500倍,本地50到60微秒,预测窗口得拉到150微秒开外。提前量抢得出来,DRAM砍下去性能只是平缓下滑,不至于撞上内存溢出。
Gary Smerdon表示,MEXT采用了Transformer架构的模型,“别人预测下一个词,我们预测下一页内存。”
被问到和CXL的区别,他说:“差别就是AI——256或512个线程一起取内存时,操作系统根本看不清,我们要做的是在这种噪声里预测。”
官方测试里,5个智能体负载砍掉一半DRAM仍保留99%的全DRAM性能,同一页把并发标为1.9倍;Azure上三节点Spark集群同样砍半也是99%。
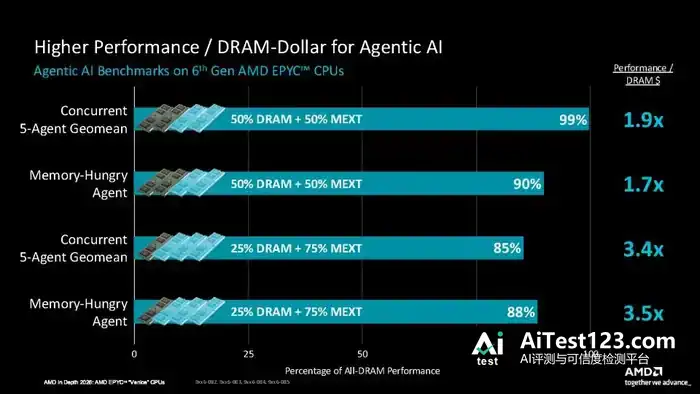
官方测试:砍掉一半DRAM仍保留99%性能,并发标为1.9倍。
Azure HX系列上,1.4TB DRAM四个EDA作业分两轮跑完要9.3小时,换MEXT后6.6小时。AMD先拿自己IT部门试,最初145台服务器减少约490万美元DRAM采购,较全DRAM方案省83%。
这意味着,软件解决方案也在强化EPYC系列服务器的生态牵引力。
“客户能拿到的节省大概在75%甚至更多,而且它是EPYC专属的。”Gary Smerdon说。
04 等待市场积极信号
“市场变化得比我们大多数人职业生涯里的任何时候都快。”AMD高级副总裁及计算与企业AI事业部总经理Dan McNamara在第二天开场提到。
智能体AI起来后CPU用量会爆发,“现在它正在发生”——从几百万人使用应用,变成几十亿个智能体不停地调用同一批应用,其中查数据库、调API、执行工具,这些任务都离不开CPU的支持。
此前,苏姿丰也在多个场合提及,CPU:GPU的配比从1:4变成1:1,甚至CPU需求超过GPU。
技术日现场,AMD再次提及这个观点,并援引IDC的预测称,到2030年投入生产的活跃智能体达25亿个、接近当前80倍;数据中心CPU市场曲线从约260亿美元走到约2200亿美元,年复合增速超过50%。
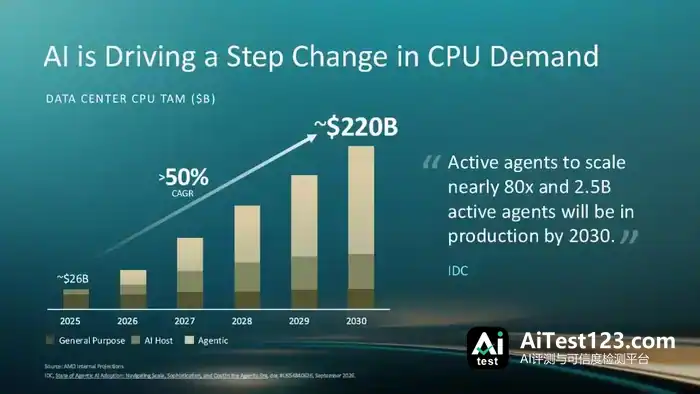
AMD引用的IDC预测:数据中心CPU市场2030年约2200亿美元。
以上都是预测,出货才是AMD的EPYC服务器产品线兑现收入的关键。
现场,微软AI基础设施副总裁Ananth Sankaranarayanan宣布Azure HDv2开启“预览”——基于Venice、超过500核,可以做训练前的数据预处理,也用于搜索和智能体编排。
“人们谈AI会直接跳到训练和推理,那主要在GPU上;但训练开始之前有一步很关键的数据预处理,数据更好,模型才更好。”Ananth Sankaranarayanan说。

微软Azure HDv2数据处理效率是市面上同规格产品的1.8倍
演讲PPT中提到:基于2×256核Venice的Azure HDv2云服务器在1.3TB数据集的Spark ETL数据处理上,性能是“市面最接近的替代方案”的1.8倍。
性能提升带来的投入产出比变化、需求场景的变化,都在推动CPU的换机需求。
AMD企业业务群公司副总裁Derek Dicker在圆桌环节援引IDC今年的调研说,换机主因是安全、性能和可扩展性,能耗成本也在推动部分换机前置。
AMD计算与企业AI高级副总裁Ravi Kuppuswamy也在演讲中强调CPU需求的爬升:“推理现在已经是第一大AI负载,”他说不能给客户一颗CPU隔着墙扔过去,“得给他们一份机架级的蓝图、框架和参考设计。”因此,AMD的服务器机架Helion按液冷、风冷、CPU加GPU同柜三档参考配置向客户交付。
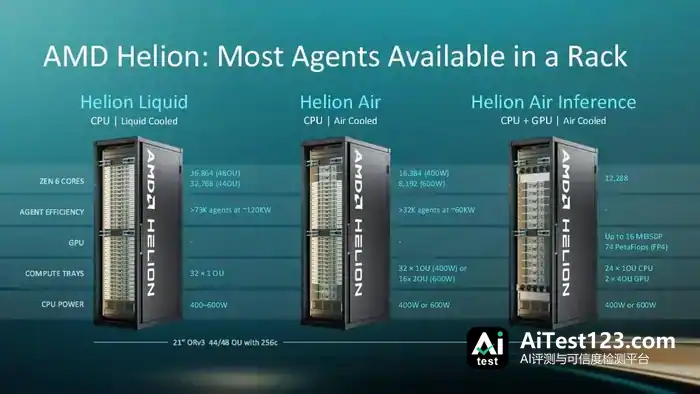
Helion拆成三档:液冷纯CPU、风冷纯CPU、风冷CPU加GPU同柜,对应不同密度和功率
Dan McNamara也强调把这一代EPYC系列定位成“完整的产品组合,不是冲着单一benchmark去的解决方案”,系统级的集成也带来了发布节奏的延续:SP8 2027年上半年,Venice-X与Verano 2027年下半年。
换句话说,即便AMD针对不同的需求和场景提供了四个平台,现阶段出货的只有SP7,MEXT也刚开始以付费许可交付。更多产品线的交付和收入兑现还有一个时间表上的延后。
按照收入确认的节奏,AMD给的四季度指引是约170亿美元,同比增约66%,增幅押在Helios、MI450系列和第六代EPYC,即SP7的扩产上。而来自SP8 、Venice-X与Verano的收入,将在2027年逐步兑现收入。
回到最初我们提到进入“数据中心时间”,这是一个随着不同平台产品产能兑现而循序渐进的过程,它在业绩上的表现更像是脉冲式兑现,短期不会在同一个时间点集中爆发。