AMD Zen 6架构发布:12核CCX、5.3GHz,下一代EPYC Venice同步曝光
AMD第六代EPYC,来了!
AI数据中心刚起步那几年,建设重心几乎都压在GPU上。大模型训练也好,推理也罢,最受关注的计算芯片都是GPU,CPU则更多负责数据准备、任务调度和系统管理。在这种分工下,服务器CPU一度显得无足轻重。
可当AI从大模型训练、推理一步步走向Agentic AI,局面开始变了。一个Agent不再只是接问题、给答案,它得反复查数据库、调API、检索上下文、执行代码、使用外部工具,还要在不同任务之间做协调。这些活儿大多不落在GPU上,却离不开CPU持续参与。
AMD的判断是,数据中心的计算需求会因此被重新改写。
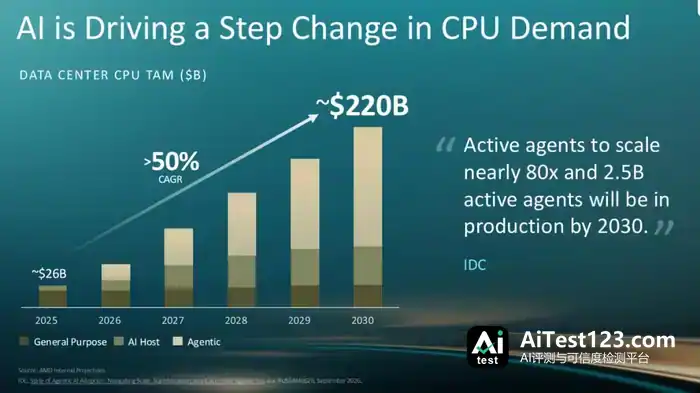
日前在美国拉斯维加斯举行的AMD In Depth活动上,AMD把Agentic AI看作服务器CPU市场下一轮增长的重要驱动力,并预计未来数据中心CPU市场复合年增长率将超过50%,到2030年市场规模有望达到约2200亿美元。AMD引用的预测数据还显示,到2030年投入生产环境的活跃Agent数量将达25亿个,比当前增长近80倍。
AMD给出的计算架构变化同样直观:聊天机器人为主的阶段,CPU与GPU的配置比例约为1:4;到了Agentic AI阶段,这一比例可能向1:1靠拢,而且还有继续上升的余地。说白了,AI数据中心不光要更多GPU,也得靠更多CPU来支撑Agent运行。

面对这种转向,AMD选择用全新的CPU来应对这个即将巨变的时代。这次披露的Zen 6架构,以及第六代EPYC处理器 Venice,正是围绕这一变化做出的产品布局。
AMD Zen 6,两个版本
正如前文所说,在AMD眼中,Agentic AI并非单一的计算任务,不同环节可能产生不同的计算需求。这里面既有CPU密集型任务,也牵涉内存、I/O、安全和加速计算。这也解释了AMD为何反复强调CPU在Agentic AI基础设施里的作用——GPU负责模型推理和加速计算,但Agent要真正把任务做完,还得由CPU负责调度、运行环境管理、数据访问和工具调用。尤其当Agent数量不断攀升时,CPU要处理的并发任务也会随之增加。
于是,针对不同需求,AMD这次拿出了Zen 6和Zen 6c两种核心设计。
据介绍,这两种核心设计并非简单地在核心数量和频率之间做取舍,而是要覆盖不同的计算需求。在AMD看来,Agent Sandbox需要尽可能多的核心和线程,才能同时跑更多Agent;GPU Host节点更看重高频和低延迟,CPU得及时把数据喂给GPU,免得昂贵的加速器因为等数据而闲置。
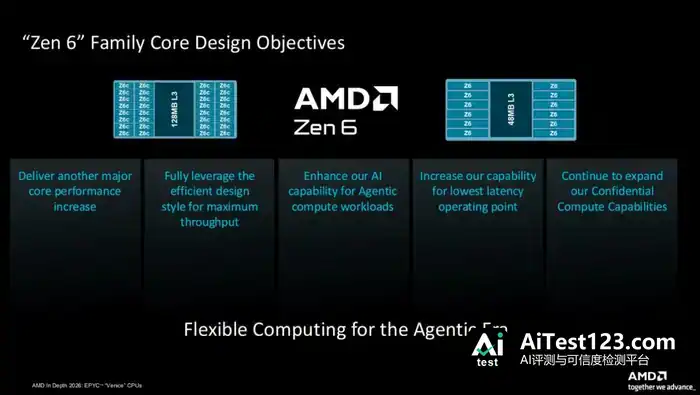
基于上述思路,AMD把Zen 6定位为主要面向对单核性能、频率和响应延迟更敏感的工作负载,介绍中称其“Optimized for lowest latency”。与上一代Zen 5相比,Zen 6的CCX核心数量从8个增加到12个,单个CCD最多集成12个核心,L3缓存总量从32MB增加到48MB,仍保持每核心4MB L3缓存。频率方面,AMD给出的最高频率从Zen 5的5.0GHz提升至5.3GHz。同时,Zen 6还带来较大幅度的IPC提升,以及电源效率和SMT效率方面的改进。
有了这个设计,AMD Zen 6更适合对高频率和低延迟要求较高的场景,比如GPU Host节点。CPU需要及时完成任务调度和数据准备,并向GPU提供数据,避免GPU因等待CPU而出现计算资源闲置。
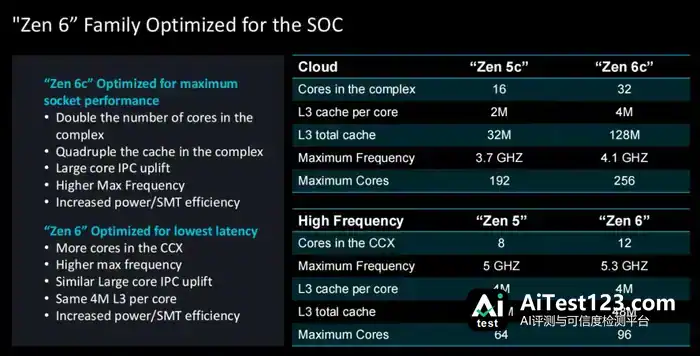
至于Zen 6C,主要面向云计算和大规模并行计算场景,AMD将其定位为“Optimized for maximum socket performance”。如图所示,相比上一代Zen 5C,Zen 6C将单个CCX的核心数量从16个提升至32个,核心数量翻倍;L3缓存总量则从32MB增加到128MB,达到上一代的4倍。按照AMD披露的数据,Zen 6C每核心拥有4MB L3缓存,而Zen 5C为2MB。频率方面,Zen 6C最高频率从Zen 5C的3.7GHz提升至4.1GHz。AMD还强调了大核心IPC性能提升,以及电源效率和SMT效率的改进。
AMD表示,Zen 6C的优势在于能在单颗处理器中集成更多核心,从而提高单路服务器的并行处理能力。对Agent Sandbox、云计算和大规模并发任务来说,这意味着一台服务器能承载更多工作负载,减少服务器数量及相应的部署成本。
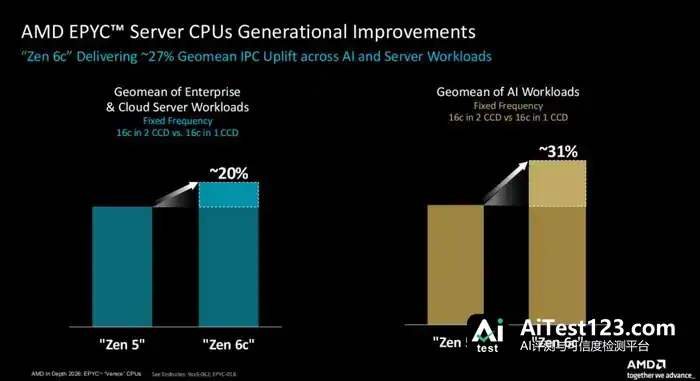
分享中,AMD展示了Zen 6C架构相较Zen 5的IPC性能提升。如下图,AMD采用固定频率测试,以16个核心为基准,对比Zen 5采用两个CCD承载16核、Zen 6C采用单个CCD承载16核的情况。在企业级和云服务器工作负载中,Zen 6C的几何平均IPC提升约20%。在AI工作负载中,同样采用固定频率、16核的对比方式,Zen 6C相较Zen 5的几何平均IPC提升约31%。
把AI与服务器两类负载放在一起算,AMD给出的Zen 6C几何平均IPC提升约为27%。这一定位很明确:核心密度上去了,单核性能却没被牺牲,各类服务器负载下的IPC提升都看得见。
全新EPYC,开启新时代
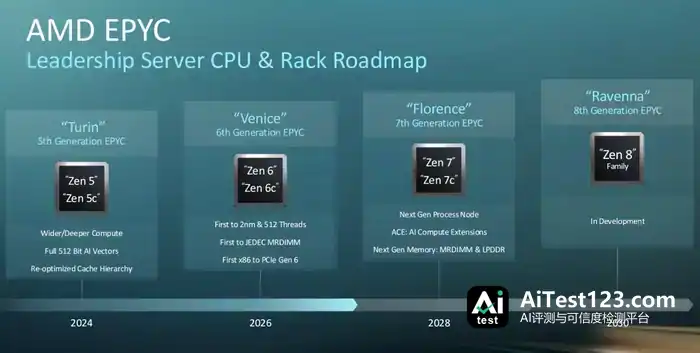
伴随Zen 6的亮相,AMD也深度揭秘了使用台积电2nm工艺打造的第六代EPYC处理器(代号:Venice)。
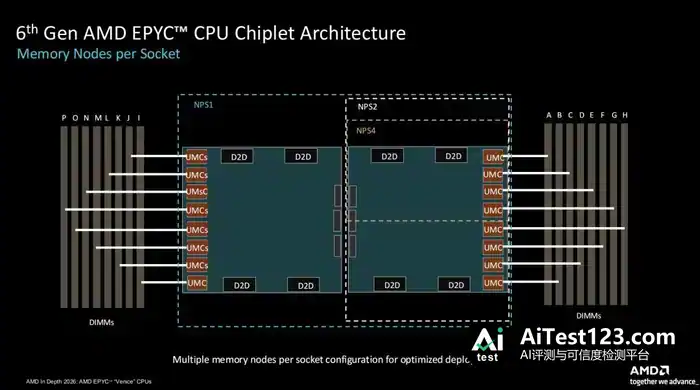
设计层面,AMD在Venice上延续了Chiplet思路,但整个SoC最多可由8个计算芯粒(CCD)加2个I/O芯粒(IOD)构成。芯粒间的连接方式与I/O布局这次做了进一步调整,目的是跟上核心数量增长后对数据传输、内存带宽和外部连接能力的更高要求。分工上,CCD管计算,IOD承担Fabric、内存控制器、PHY、I/O控制及安全等功能。

先看CCD。据AMD介绍,这代产品由台积电2nm工艺打造。前面提到,这代产品实现了自Zen 3以来的首次升级——标准Zen 6 CCD最多可扩展到12个核心,Zen 6c则是32个核心。作为对照,Zen 5和Zen 5c的CCD核心数上限分别是8个和16个。另外,AMD把Zen 6c CCD每个核心的共享L3缓存容量翻了一倍,核心数又翻了一倍,算下来L3缓存容量比Zen 5c实际增加了四倍。
I/O Die方面,Venice上用的是6nm工艺,AMD采用双IOD分离式设计。每个IOD集成8个DDR5内存通道,两个IOD合计16个通道,支持最高12.8GT/s的MRDIMM,单路处理器理论内存带宽最高可达1.6TB/s。每个IOD还带48条64G SerDes和8条16G SerDes,两个IOD加起来是96条64G SerDes和16条16G SerDes。AMD表示,双IOD布局主要是为了应对更多的内存通道、更大的带宽以及更复杂的I/O需求,同时改善QoS和数据流量分配。
芯粒互连也是Venice这次升级的重点。AMD强化了CCD到IOD的数据通路,提升数据响应和写入密集型流量的处理能力,端口数量也增加了,带宽和数据共享能力随之提高。Venice还采用Elevated Fanout Bridges(EFB)实现Die-to-Die通信。AMD称,这种方式能降低芯粒间数据传输的单位能耗,延迟也进一步下降,为处理器核心腾出更多功率空间。平台同时采用第五代Infinity Fabric,支持更快的Fabric P-state切换,以改善能效表现。
架构创新之外,AMD Venice系列还有一个重大转变:不再沿用单一平台策略,而是分别推出采用不同物理接口的SP7和SP8两大平台,并进一步布局9006X(Venice-X)和9006 LP(Verano)两个细分产品系列,以应对不同的需求。
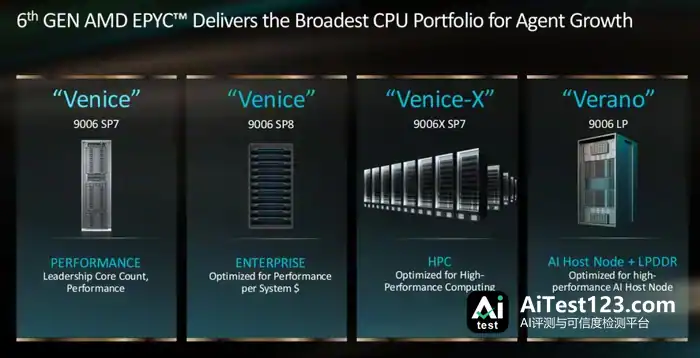
嵌入式9006系列SP7 CPU最高提供256核、512线程,并推出64核至256核的多种SKU,以满足不同应用对性能、功耗和频率的需求。内存方面,该系列配备16个DDR5内存通道,支持最高8000MT/s的RDIMM和最高12800MT/s的MRDIMM。I/O方面,最多提供96条PCIe Gen 6通道,单通道速率达到64GT/s,同时支持CXL 3.1,为高速存储、网络设备、加速器及内存扩展设备提供连接能力。
按照AMD给出的数据,9006系列对上一代EPYC嵌入式9005系列,整体吞吐量最高提升到1.8倍,I/O带宽最高1.5倍,内存带宽最高2.7倍。落地上,AMD把半导体自动测试设备(ATE)、企业存储、网络防火墙列为重点方向。放到半导体测试场景,处理器能接手测试系统的控制与编排,让更多测试并行跑起来;网络安全场景里,它可用作400G/800G防火墙的控制平面,相关吞吐量最高提升1.3倍;企业存储这边,则能加快NVMe设备管理,以及压缩、缓存、RAID这类数据处理任务,ISA-L相关测试性能最高提升1.5倍。
嵌入式设备往往一装就是多年,AMD给EPYC嵌入式9006系列承诺了七年供货周期,固件更新和软件支持也会持续跟上。安全层面,这一系列把AMD信任根(ART)、AMD安全处理器(ASP)和Caliptra等机制集成进来,安全启动、运行时保护、设备身份验证都覆盖到了,还支持用于固件签名的后量子密码技术。
全面出击,披露新路线图
两天分享下来,AMD讲到的芯片信息其实远不止这些。系统、软件层面公司也铺开了布局,目的是把客户服务得更好。比方说,在AMD眼里,Agentic AI基础设施没有一套放之四海皆准的标准机架方案——部署规模、现有数据中心条件、工作负载特点不一样,客户对CPU、GPU怎么配、散热怎么做,需求自然也不同。
为此,AMD通过Helion提供了三种不同的Agentic Rack配置,分别面向超大规模数据中心和企业级市场。
头一种叫Agentic Rack,冲着大型云服务商和超大规模数据中心去,CPU与GPU分开部署,其中CPU机架用直接液冷,为的是抬高机架功率密度和计算部署密度。第二种给的是想借现有基础设施扩展Agentic AI能力的企业客户,CPU机架独立、采用风冷,部署密度比不上液冷方案,可更容易塞进现有的风冷数据中心。第三种是All-in-One,CPU和GPU装进同一机架,同样是风冷,适合那些想在本地跑AI推理、又要求CPU与GPU紧密协同的企业客户。
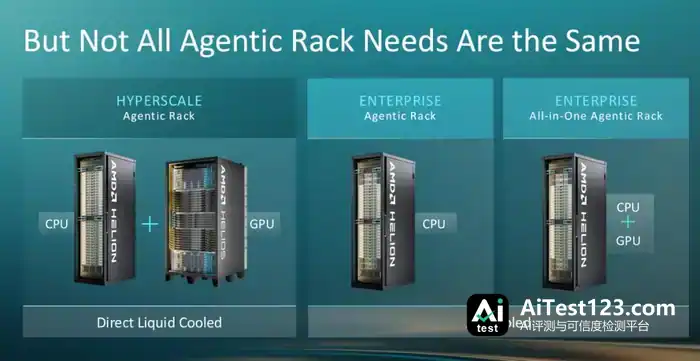
三套方案摆在一起,能看出AMD对Agentic AI基础设施的判断:AI Agent负载越堆越多,数据中心光靠更多GPU不够,还得有大量CPU去承担任务调度、工具调用、沙箱执行、工作流管理这些活。可客户各自的部署条件又不一样,所以AMD没有把Helion框死成某一种机架设计,而是给出开放式参考架构,客户按需调整。
软件层面的投入同样不小。这次大会上,AMD专门谈了AI时代DRAM的供应和成本压力,并介绍了他们如何借助收购MEXT得来的软件技术,帮终端客户解决这一难题。
按照AMD的说法,这套方案的思路是用软件把Flash纳入内存管理体系:访问频率偏低的"冷数据"被迁到Flash里,DRAM则留给活跃数据,对高成本DRAM的依赖随之下降。
Flash访问速度偏慢,可能拖累应用性能。AMD MEXT的对策是靠AI引擎分析内存访问模式、预测数据需求,在数据真正被用到之前就把它从Flash调回DRAM。
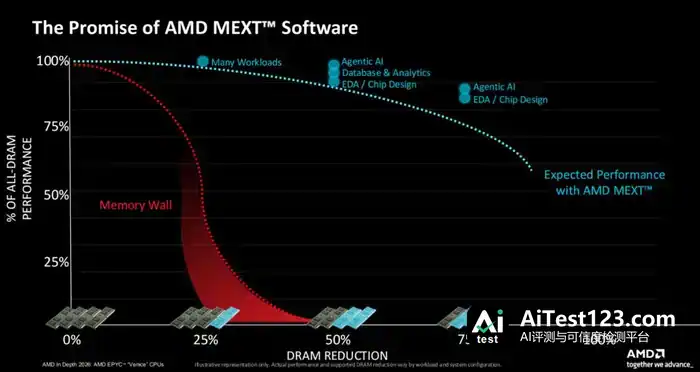
AMD透露,MEXT的解决方案能按不同工作负载把DRAM用量减少20%至75%,有效内存容量最高可扩到原来的3倍,延迟影响低于4%。Flash成本最高可比DRAM低约30倍,数据中心的护存配置成本有望因此明显下降。
AMD进一步给出测算:在145台服务器的初期部署中,用MEXT做内存扩容,相比全部使用DRAM的方案,预计可节省约83%的成本,避免约490万美元的DRAM支出。对AI服务器来说,这提供了另一种扩容思路——不再单纯靠堆DRAM满足容量需求,而是通过软件调度让DRAM与Flash协同工作。

自2018年推出第一代产品以来,AMD在EPYC上的影响力一路增强。Mercury Research八月份发布的一份报告显示,第二季度AMD在服务器处理器市场的占比达到34.5%,一年前这一比例为27.3%。
成绩显著,AMD却没有放慢脚步。下面的路线图展示了他们在Agent CPU新时代再进一步的决心。基于过去多年的积累,AMD做到这一点并非没有可能。