

FireFlash仅用64张B300训练300B智能体:单任务成本比Fable 5低30倍
长程智能体训练太贵?FireFlash用全参数RL在64张B300上跑出了Terminal-Bench 46.2%的成绩,单次任务成本比Fable 5低30倍。核心不在堆算力,而在异步训练、任务筛选和奖励校正这套组合拳。
长程智能体训练为何如此费钱
要是你让AI代理去修一个复杂Bug,或者让它连着好几个钟头在终端里跑命令、写代码,就会发现这活儿不光考验技术,还特别考验钱包。

如今的走向是智能体从「单步问答」转向「长程工作」,它得在终端里连续操作数小时,完成上百轮工具调用。前沿实验室不愁这个,他们有数千张GPU来扩展强化学习(RL)。可大多数团队没这条件:一次训练样本就是一次长达3小时的完整尝试,网络抖动、沙盒崩溃、模型输出乱码,哪个环节出岔子,搭进去的都是成小时的GPU时间。
矛盾就摆在这儿:大家想要更聪明的长程智能体,可现有RL训练的成本高得让人不敢下手。

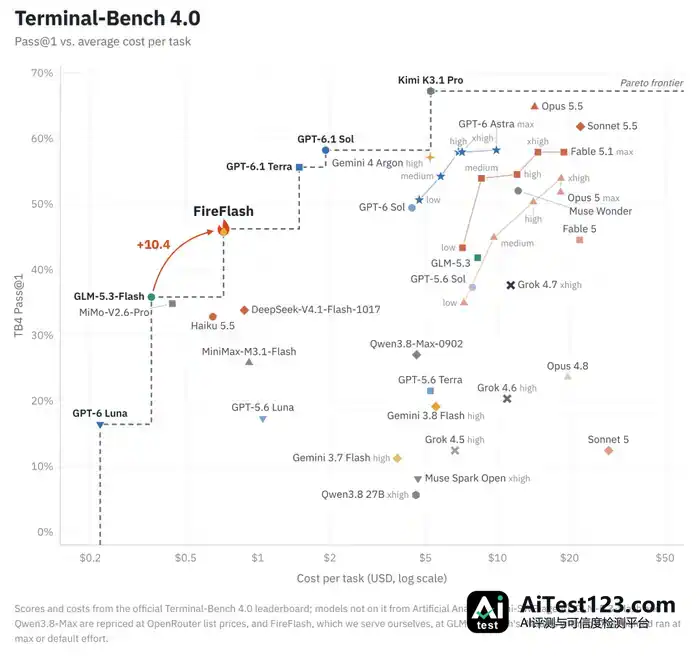
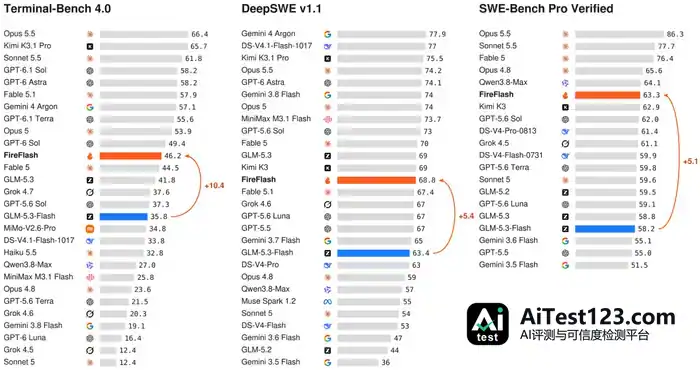
近日,Wenbo Hu、Nanyun Peng等研究者在Agent Economics博客上发布了FireFlash。它基于GLM-5.3-Flash,是全参数强化学习智能体,参数量达到300B级。表现挺有意思:Terminal-Bench 4.0上Pass@1达到46.2%,与 Fable 5、GPT-6 Sol处在同一水平线。关键的一点是,单个任务成本比最高推理强度下的Fable 5低30倍以上。
更出人意料的是,整套训练只用了64张NVIDIA B300,耗时不到5天,团队还把完整的训练配方公开了。这说明百卡级集群同样能跑出前沿级的训练效率,前提是手里得有一套精细的「省钱」策略。

核心思路:GPU别闲着,数据也别废着
FireFlash能成,靠的不是运气,而是把后训练流程里五个关键环节重新做了一遍。团队认为,要在有限算力下站上Pareto前沿(性能与成本的最佳平衡点),三个问题必须解决:
- 基础设施:GPU不能干等最慢的那次尝试。
- 任务筛选:每个rollout(采样)组都得带上学习信号。
- 奖励设计:只给真正的解答打分,堵住模型投机取巧的路。
另外,他们搭了一套编程harness(智能体运行框架),模型优化、训练与评测共用,保证训练环境和测试环境完全一致。
1. 基础设施:完全异步的RL
以往做RL训练,采样(rollout)和训练(training)要么串行,要么耦合得很紧。采样慢了训练就得等,训练慢了采样也得停。放到长程任务里,这种等待就是巨大的浪费。
FireFlash干脆把两者彻底解耦。
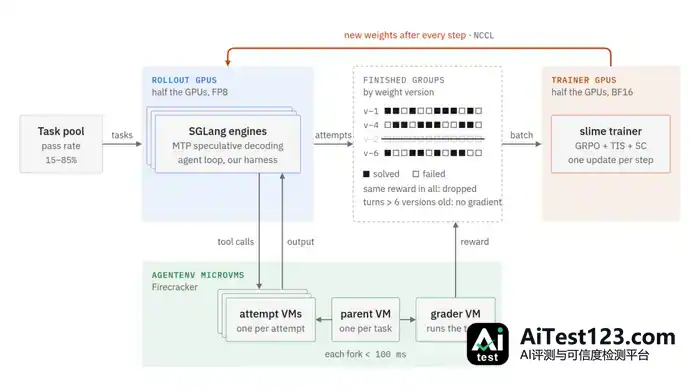
GPU被分成两组,一半跑训练,一半跑采样。训练端用slime框架、以BF16精度运行,采样端用SGLang推理引擎,权重和KV cache都是FP8精度。每个训练步结束,新权重经NCCL同步到rollout引擎,两边互不阻塞。
这里有个大胆的设计:允许拿陈旧的权重去采样。采样一直在跑,某轮尝试可能由落后训练器数步的权重生成,只有权重来自6个以上版本之前时才会被丢弃。研究显示这种策略陈旧带来的偏移很小:训练器与rollout之间的log概率差距,陈旧1个版本时为0.065,陈旧4–6个版本时也只升到0.08。
提速还有别的招。他们用模型原生的多token预测(MTP)头做投机解码,解码速度提升1.38倍。每次rollout和打分都在独立的Firecracker microVM里执行,这种隔离让因基础设施故障损失的rollout组占比从12%降到0.5%。
说白了,就是让采样和训练各自全速跑,闲置GPU的代价比陈旧的rollout更高。
2. 任务筛选:只在模型「拿不准」的地方训练
GRPO(Group Relative Policy Optimization)算法靠同一任务多次尝试之间的相对差异来学习。模型要是总能解出某个任务,或者怎么都解不出,这一组rollout就提供不了任何学习信号,算力纯属白花。
团队的做法很直接:初始通过率在15%–85%之间的任务才保留。
训练开始前,他们用基座模型对每个候选任务做至少4次rollout摸底。摸底条件与训练完全一致——同样的harness、推理强度、上下文窗口、轮数预算和沙盒,因为任务通过率高度依赖这些环境因素。
筛完之后,零信号rollout组的占比从48%降到10.2%。绝大部分算力于是花在模型「有点会,但不完全会」的任务上,学习效率明显提升。
训练数据最后定下来,长程智能体任务占约 52%,软件工程任务占约 48%。长程任务里既有团队自己搭的困难档,也有 MiMo-TB 这类公开任务;软件工程任务覆盖 Python、TypeScript、Go 等语言。
3. 评分器与奖励:评分器先验,再谈防奖励投机
团队回头审查那些一直没被解出的任务,发现接近一半的问题出在题目本身「坏了」,而不是「难」。有的题面自带缺陷,有的测试太脆弱,还有的埋了「受保护文件」的坑。更麻烦的是评分器:光凭输出格式对得上就给分,或者一碰到真实输出就直接崩。
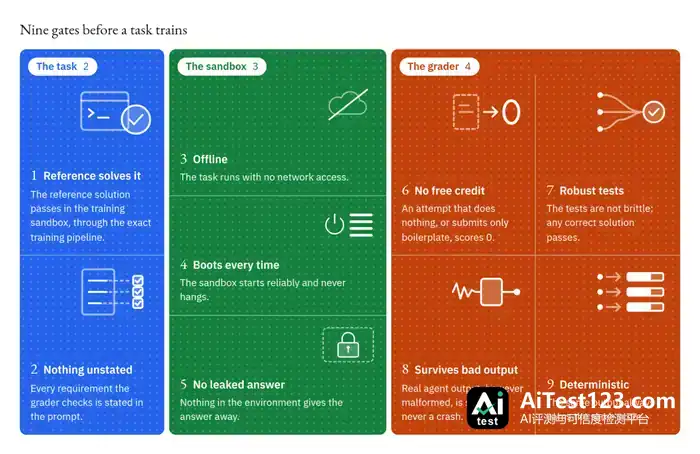
于是,每个新任务要进训练池,都得先过九道验证关口:
- 任务这一层:参考解得能在训练沙盒里跑通;评分器盯的每一项要求,题面里都得写清楚。
- 沙盒这一层:离线跑;每次启动都不能掉链子;环境里不能把答案漏出去。
- 评分器这一层:空白代码或样板代码一律 0 分;测试不能脆弱;畸形输出也得扛得住;同样的输出每次都得给同样的分。
奖励这块,他们加了一项长度奖励。完全解出拿 1.0 分,没做完的按部分分算。解出来的尝试还能再拿最多 0.2 的长度奖励,折算依据是比同组最长解答少用了多少 token。
这项塑形起效了:每次解出消耗的 token 数降到原来的 0.84 倍,评测准确率没掉。模型算是学会了少说废话、多干实事。
4. Harness:训练和评测用同一套
不少智能体项目训练一套环境、评测另一套,结果要么复现不了,要么成绩虚高。FireFlash 的做法是让训练 rollout 和评测试验跑在完全相同的 harness 上。
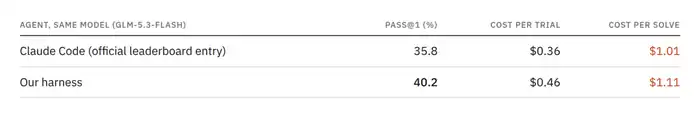
这套 harness 照着 Claude Code 的约定来:Bash、Read、Write、Edit 四个工具,原生工具调用,保留推理历史,再加上下文压缩。两边在代码和提示词上是否一致,他们用自动化单元测试来卡。
光是换上这套 harness、还没做任何 RL,GLM-5.3-Flash 在 Terminal-Bench 4.0 上的成绩就比它官方的 Claude Code 成绩高出 4.4 个点。
长程尝试成本高,harness 另外还做了几项优化:
- 上下文压缩:占用到上下文窗口 85% 就触发,做法是追加分节摘要提示,把前缀缓存保住。
- 输出重定向:命令把标准输出写进文件,只回一个带文件名的截断预览。
- 后台执行:跑得久的命令转后台异步跑,不再超时就掐掉。
几项加起来,单次试验成本降了约三分之一。再配上要求高效工作流的提示词规范,比如原地编辑、一次写完,又省下 16% 的成本。
5. RL 目标:从陈旧样本里学,但不能漂
rollout 用 FP8 精度采样,权重最多落后 6 个版本,跟正在训练的 BF16 策略有细微差别。这些陈旧轨迹团队没扔,而是在训练目标里直接做校正。
核心算法是 GRPO,搭配了下面几项技术:
- 截断重要性采样(TIS):每个 token 按 BF16 训练器概率与 FP8 rollout 概率的比值加权,比值卡在 [0.5, 2.0] 之间,以此限制单个 token 的影响。只有 1%–3% 的 token 会碰到截断边界。
- 分数中心化(SC):每个 token 的策略梯度分数里,减去采样器在这些候选上的期望分数,从而消掉向陈旧 FP8 采样器的漂移。
- 成功偏移:完全解出的按 1.5 计入优势,没解出的尝试按部分分的一半计入。部分分的信号用上了,又不会跟真正解出混为一谈。
- 损失归一化设了下限,目的是防止那种只冒出来寥寥几个 token 的退化 rollout,在单 token 上拿到过大的权重。
经过上述校正,训练过程既不用 KL 惩罚,也不用熵奖励。策略熵在正常训练中从约 0.46 缓慢降到 0.33;一旦它往上走,就是训练失稳的早期预警。
实验结果:站上成本—性能前沿
三个基准测下来,FireFlash 全都压过了基座模型 GLM-5.3-Flash。
- Terminal-Bench 4.0 上提升 10.4 个点,Fable 5 以及满尺寸的同门模型 GLM-5.3 都被甩在后面。
- DeepSWE v1.1 上提升 5.4 个点,高过 Fable 5.1。
- SWE-Bench Pro Verified 上提升 5.1 个点,Kimi K3 和 GPT-5.6 Sol 都没能守住。
成本这一头,FireFlash 落在成本—性能 Pareto 前沿上。按 GLM-5.3-Flash 的公开价格算,它单次试验花 0.72 美元;最高推理强度下的 Fable 5 则要 22.02 美元。前沿上的下一个点是 GPT-6.1 Terra,得分 55.6%,成本 1.49 美元。得分比 FireFlash 高的模型,单次试验成本起码是它的两倍。
结语
FireFlash 说明了一件事:有针对性的后训练,能把开源权重模型改造成能力很强的领域专用智能体,推理成本只用前沿水平的一小部分。
在作者看来,把模型、训练环境、harness 与推理系统放在一起联合优化,是单纯堆规模之外另一条造出强大高效智能体的路。FireFlash 只是这个方向上的第一步,团队下一步要把这套方法从编程和终端任务,推向更复杂、更长程、需要反复执行的工作。
对大多数拿不出千卡集群的团队而言,这套精打细算的 RL 训练配方,参考价值或许比单纯的模型参数更大。











