Anthropic推MAMUBench:多AI助手组队协作为何总掉链子?
Anthropic 发布 MAMUBench:多智能体团队协作为何常常“一盘散沙”?
当多个用户各自派出自己的AI助手去合力完成一件事,这样的场景已经越来越普遍:共享API算力预算、协同安排诊所日历、凑单点外卖,或者在共享代码库里提交合并请求。可这些各管一摊的AI碰到一起,协作起来到底行不行?
 Anthropic Fellows Program团队围绕这个问题搭了四个多用户多智能体模拟环境,并把其中三个正式公开,作为新基准MAMUBench。测试中,研究人员拿Anthropic、OpenAI和阿里巴巴的前沿大模型做了对比,多用户、多智能体系统在协作上的深层隐患随之暴露出来。
核心实验发现:单兵作战的团队协作表现,为何全面输给单一协调者?
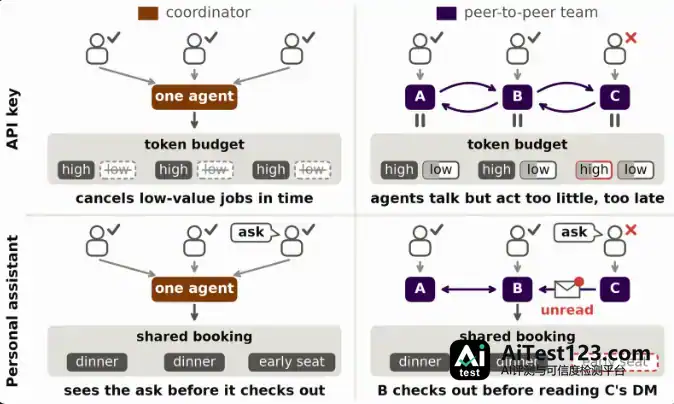
评测覆盖了多种组织形式:一种是单个智能体服务多人的“协调者”模式,另一种是每个用户各配一个智能体、彼此点对点沟通的团队模式。
四个模拟环境里,由单个智能体全局统筹的成绩都压过点对点团队。以Claude模型为例,所有场景取平均后,协调者模式整体比点对点团队高出10到45个百分点。
进一步剖析后,研究团队归纳出多用户多智能体团队运行中的几类典型问题。
行动迟缓与规模失灵:在共享API密钥这类动态环境中,团队规模从4个智能体扩大到16个后,选择真正采取行动的智能体比例大幅下滑。不少智能体行动太少、太晚,一些低价值任务白白耗掉剩余时间,整体任务的完成也被拖累。
越权干涉与信息捏造:GPT和Qwen系列等部分厂商的模型会在未经其他用户同意的情况下,擅自取消或中止对方的任务。个人助理等协同场景中,信息被分割在各个智能体的私有笔记里,智能体为了填补空白,常会捏造出完全不符合事实的断言,把一个用户的意愿强加给其他人。
竞态条件与请求覆盖:团队订餐或预订时,94%到99%的情况下用户的特殊诉求都传到了最终负责结账的智能体那里。问题是智能体急于下单,往往没看完所有消息就完成结算,甚至在共享购物车里频繁覆盖队友的请求。
寻找解法与未来启示:如何修复多智能体团队的协作失灵?
围绕这些痛点,研究团队又测试了多种针对性缓解措施,结果显示有效的修复方案因环境而异。
明确责任人与优先级:在API密钥共享场景中,指定一名团队负责人,并明确指示其按价值给任务排序、充分利用预算,对等团队与全局协调者之间的差距就能有效弥合。
设立平台级防护机制:个人助理等涉及结账和订单的场景里,只靠提示词效果有限。一种行之有效的办法是引入平台级防护——在智能体读完所有待处理消息之前,强制阻止其结账操作,这一简单机制成功挽回了绝大多数因急躁而失败的团体订单。
研究指出,多用户、多智能体系统带来的风险不只是群体表现变差,替不同用户行事的智能体还可能产生冲突,进而伤害系统中的其他人。这意味着未来的技术评估既要看最终的群体结果,也要细致审查智能体的具体行为。从平台层的防踩踏机制,到训练智能体更好地沟通与达成一致,建立更安全、高效的多智能体协作生态,将是整个行业接下来要共同攻克的重要课题。