WorkBuddy与Codex把AI竞争带向任务交付,可靠执行成落地门槛
让AI回答“怎么做一份经营分析”,和让它读取销售表、计算指标、生成图表并交出报告,是两个不同层次的产品要求。WorkBuddy和Codex的实践表明,大模型应用开始承担更多实际操作,用户对产品的判断也从回答是否精彩,延伸到任务是否完成。 大模型应用正在进入任务交付的竞争,可靠执行成为落地门槛。一份可验收的成果,需要模型
让AI说说“经营分析怎么做”,跟让它去读销售表、算指标、画图、最后交出报告,是两种不同层次的产品要求。 WorkBuddy和Codex的实践说明,大模型应用已经开始接手更多实际操作,用户衡量产品的尺子也从回答精不精彩,延伸到了任务有没有做完。
大模型应用正迈入任务交付的竞争阶段,能不能可靠执行,成了落地的一道门槛。一份能验收的成果,既要模型理解目标,也要最新信息、工具操作、业务规则和结果检查一起参与。模型能力在增强,这些环节之间的职责划分也跟着重新调整。
微调、RAG、工作流和Agent之所以持续交叉,原因也在这里:它们各自改善的是模型能力、任务信息和执行过程。要看懂路线的演变,先得看系统怎么把一次回答,组织成一项能完成、能复核、能交付的工作。
01 WorkBuddy和Codex让AI直接处理文件并交付成果
WorkBuddy和 Codex适合放在一起看,是因为它们把任务执行能力带进了用户真实干活的环境。用户给出目标、资料和允许操作的范围,系统去读信息、调工具、生成文件,成果再回到原来的工作流程里。产品要担的职责,也就从给答案延伸到了组织一次实际执行。
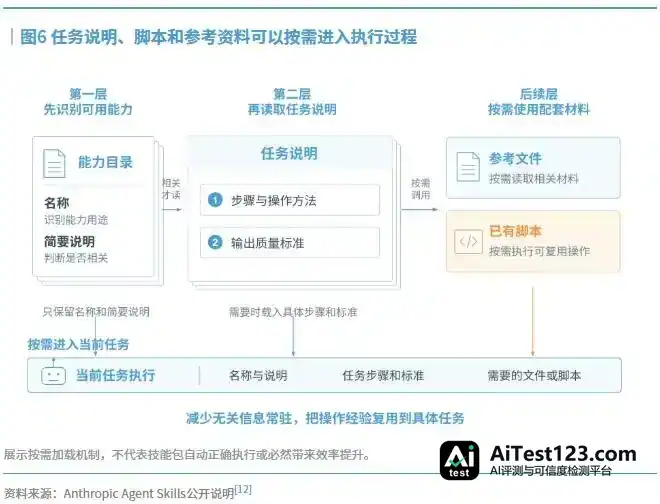
腾讯的WorkBuddy产品页,把本地文件操作、自主规划和成果交付列为核心能力。官方实践文档写得更具体,拿经营分析举例:用户给出Excel或CSV,指定指标和时间范围,产品读取数据、做统计,再生成图表或报告。技能文档还说明,特定任务能力可以用脚本和工作流来扩展。专业知识、已有程序和模型判断,就这样进了同一个任务过程。
Codex的发展,则呈现出从代码任务向更广知识工作延伸的轨迹。2025年发布时,它已经把读写代码、执行命令和运行测试组织成任务;2026年6月,OpenAI披露的知识工作用途又加上了报告、表格、演示文稿和研究分析。到8月,它在平台文章里把执行循环开放为可集成的Harness,让其他应用继续保留自己的业务界面、上下文和工具。
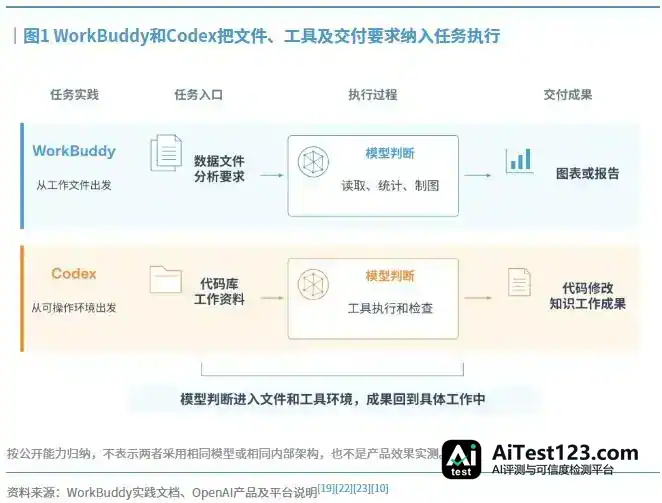
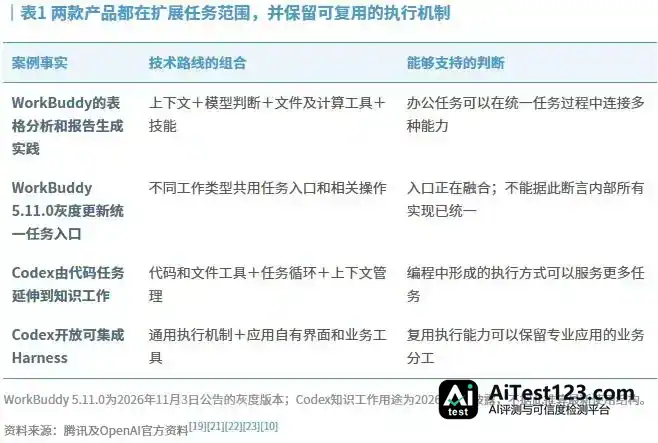
这两个案例说明,专业能力可以由通用模型、任务说明、专业资料、工具和执行控制共同拼出来。WorkBuddy的“领域专家”,或者一项Codex任务,光看名字不能认定它就是独立训练的垂类模型。应用专业化正在多出更多实现方式,模型专业化只是其中一种。
02 通用模型增强正在把应用开发重心推向完整任务
通用模型越能理解指令、处理长文档、调用工具,开发者为每种表达方式单独设计处理逻辑的必要就越小。过去必须靠大量样本训练的部分任务,现在用指令和示例就能完成;过去要手工连接的某些步骤,模型也能根据执行结果自己调整。应用开发因此多了不少选择余地。
这条技术脉络其实很清楚。2018年,GPT早期研究走的是预训练之后按任务微调的路子;2020年的GPT-3,展示了靠上下文里的任务描述和示例完成多类任务的能力。同年,RAG研究把外部检索引入生成过程。到2024年,Berkeley BAIR已经用“复合AI系统”来概括模型、检索器和外部工具共同完成任务的实践。
这几条路线从一开始就互相交叉。RAG不是在微调消失之后才出现的,工作流也不是等到智能体出现才有了价值。把它们排成一条淘汰链,反而会盖住真正的变化:模型承担的通用能力在扩大,应用系统要补齐的东西也随之改变。

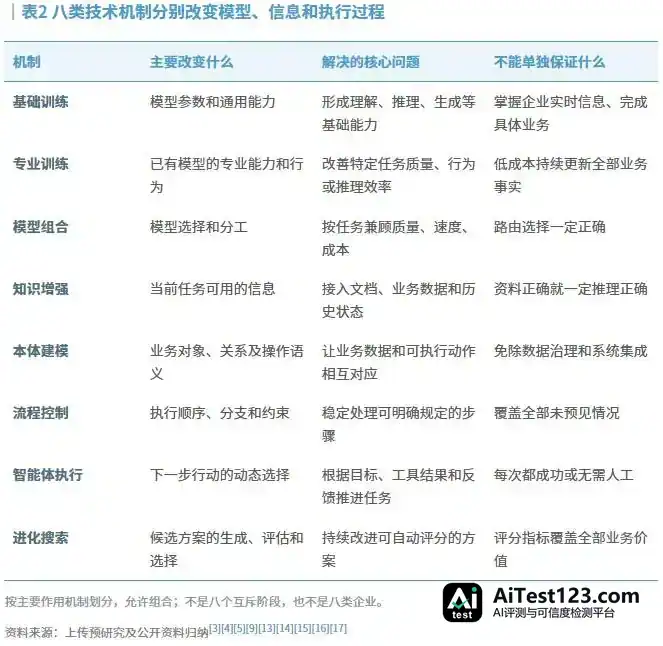
03 企业知识需要持续接入,垂类模型只是专业化的一种方式
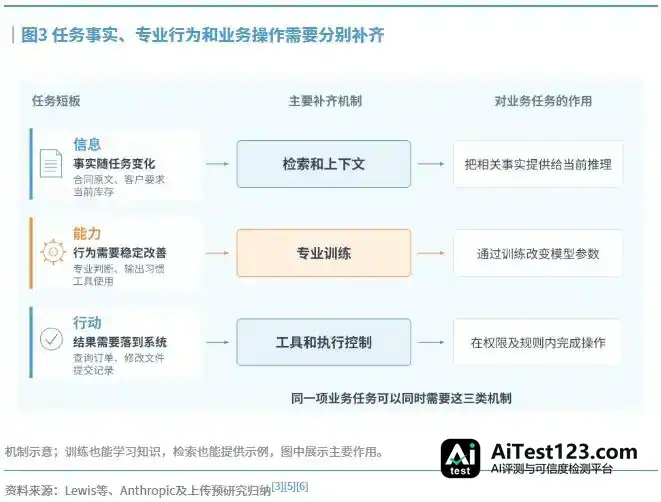
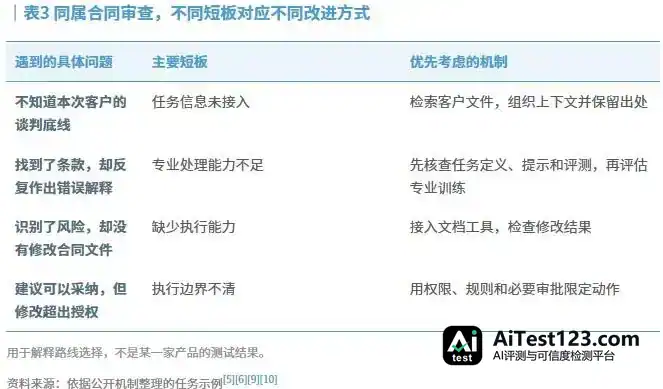
模型参数适合装那些相对稳定、能跨任务复用的能力;而一项任务需要的具体事实,往往一直在变。客户刚上传的合同、当天的库存、某个员工能看的资料,总不能都等下一轮训练后再用。把这些信息在执行时交给模型,通常更新起来更方便,出处和权限也更好保留。
RAG由此解决了知识接入的一类问题。可企业信息不只在文档里,还有数据库记录、业务系统状态和工具返回结果。任务一长,系统还得持续筛资料、留住中间结论、清掉无关信息。上下文工程的对象,于是扩展为模型当下需要的全部信息。Anthropic在2025年的工程文章里,也把信息的选择和维护放在持续执行的过程中讨论。
专业训练解决的是另一类问题:资料齐了,模型仍可能反复用错处理方式,或者稳定达不到专业成果的要求。这时候,训练能改善行为、推理和工具使用。选检索还是选训练,先看短板是缺信息,还是不会稳定完成任务;两种短板都在,就得组合着来。
04 工作流正在容纳Agent,关键业务规则仍需程序控制
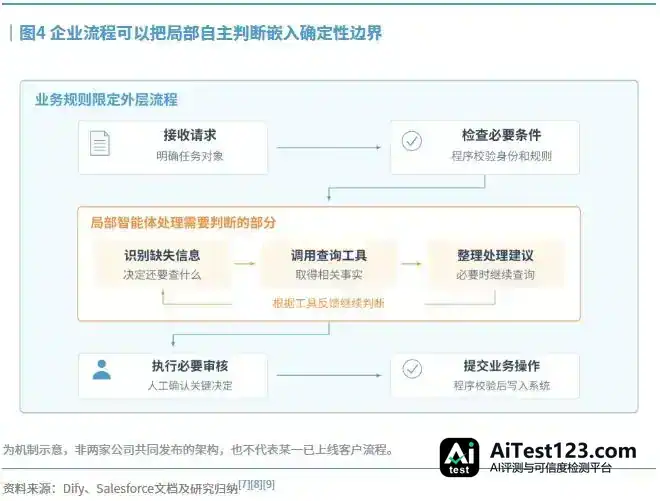
模型能自己查资料、挑工具、调步骤之后,把每一步操作都规定死的工作流就显得笨重了。但企业流程里的步骤分两类:一类随情境变化,需要解释和判断;另一类规则已经明确,每次都得按规定执行。前一类适合多加点模型判断,后一类还是交给程序控制更稳。
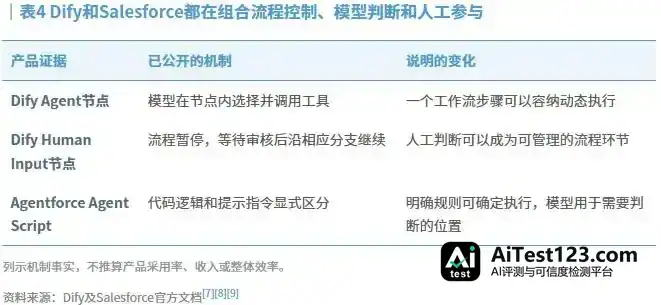
Dify把Agent放进工作流节点,让模型在节点内部反复调用工具;2026年3月,它又通过Human Input节点,把暂停、人工审核和继续执行变成工作流的原生环节。自主判断和人工参与,就这样进了同一套编排。
Salesforce则从另一面说明了同一个问题。其Agentforce技术文档把确定性逻辑和模型推理明确分开:条件判断、动作顺序之类可以写成代码执行,确实需要理解或判断的地方再调模型。企业智能体的演进方向,是把分工边界划得更准;自主程度高低本身,并不能说明产品能力够不够。
05 AI办公的规模化需要稳定执行和可检查的交付结果
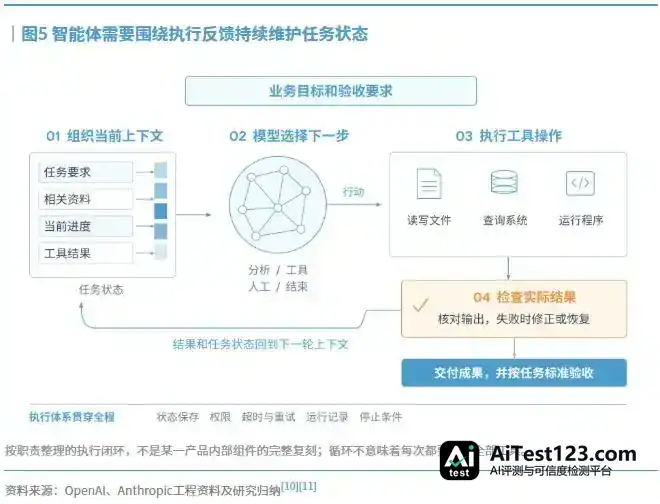
把一个模型放进循环里不停调工具,还不足以做成可靠的任务执行产品。任务可能跑上数十分钟,中间经历多次文件修改、工具失败和上下文更新。系统得清楚已经完成了什么、下一步依据是什么、出错之后从哪里恢复,以及最终成果合不合要求。
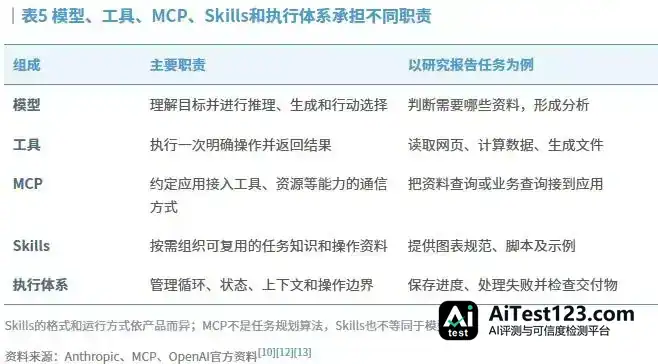
OpenAI在Codex平台文章里,把模型周围负责上下文、工具交互、状态和边界管理的执行体系叫作Harness。Anthropic针对长时任务的工程实践,则靠初始环境设置、进度文件和版本记录,让后续执行能接上前面的工作。这些机制说的其实是同一件事:模型决定下一步的能力,得有执行体系把它变成连续、可检查的工作。
产品一旦开始交付文件、代码和业务记录,运行环境本身也就成了产品能力的一环。文件存在哪儿、执行能不能隔离、任务中断后能否恢复、操作结果怎么核对,这些都会左右用户最终拿到的东西。只盯着模型回答得好不好,这些差别就看漏了。
新出现的组件,也得各自归位。工具管具体操作,MCP是连接工具和资源的一种协议,Skills则把可复用的说明、脚本和参考资料组织起来;真正在任务里调用它们的,是执行体系。
组件越堆越多,可光凭名字,证明不了任务一定做得完。
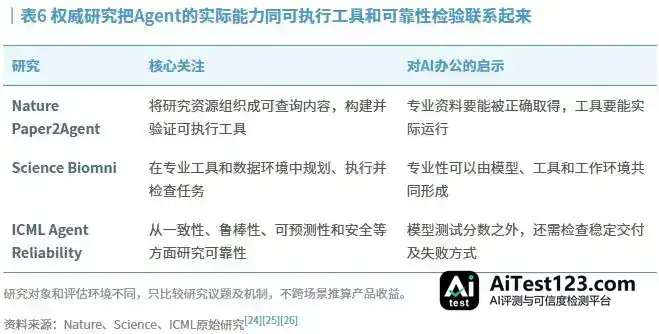
权威研究正朝同一个方向使劲:让Agent可靠地调用工具、把实际操作做完。Nature的Paper2Agent研究把论文和相关资源整理成可查询的资源层,条件允许时还会构建并验证可执行工具;Science的Biomni研究则把专业工具、数据和代码执行放进科研任务的流程里。两者看重的都是能跑起来、能验证的系统。
能力往上走,还得过可靠性这一关。ICML 2026有一项研究评估了15个模型,结论是近期的能力增益只换来较小的可靠性改善;单看正确率,反映不出重复运行、输入变化和失败后果的全貌。
所以一次演示跑通,不等于能稳定交付。任务质量、重复执行的表现、人工复核和总成本,得摆在一起看。