

张一鸣谈字节AI:追平前沿最早2029或2030年,数据短板最紧迫
“最早也要到2029年或2030年” 11月12日,据悉张一鸣近期在一次面向 AI 团队的全员会议上再次谈到 AI 业务。今年 43 岁的他退居幕后,仍把大量时间投入字节 AI 战略的制定。 这场会上,他先给团队吃了颗定心丸,又划出一条很长的时间线:字节有能力与 OpenAI 和 Anthropic 展开竞争,但真正追
“最早也要到2029年或2030年。”
11月12日传来消息,张一鸣前不久在面向AI团队的一次全员会议上,又一次谈起AI业务。他今年43岁,已退居幕后,可大量精力还是花在字节AI战略的制定上。
会上他先让团队安了心,接着给出一条拉得很长的时间线:字节有本事跟OpenAI和 Anthropic同场竞争,可要真正追平前沿技术,“最早也要到2029年或2030年”,自家大模型的目标是国际第一梯队。
这份底气,还有这份清醒,随后被他拆成几个具体问题来讲。
头一个问题是数据。张一鸣直言,跟海外顶尖AI公司比,字节Seed系列模型预训练用的数据集规模“仍然少了”,眼下最该盯住的就是这件事。规模定律还在主导大模型演进,语料的质和量直接卡住模型能力的上限;字节手里有国内丰富的内容生态,可真要去拿全球范围、多语言、高知识密度的训练语料,物理壁垒和版权约束一样绕不开。
路线怎么选,他重申了一条纪律:字节不能靠“蒸馏”,也就是拿更大模型的输出喂自己的模型,而要把心思放在长期目标上。
更早的内部会议上,张一鸣就说过,做模型得坚持长期主义、延迟满足感,别拿别人的输出换一时的榜单名次。字节内部后来用API异常检测、开源模型数据过滤等办法,拦住研发人员私下调用第三方模型输出当训练集。Seed团队正在预训练一款参数规模最高可达10万亿的模型,量级能跟Anthropic最高端的模型相比。
挑了慢路,团队和版本节奏自然快不起来。
Seed团队眼下约有1000名研究人员和工程师,带队的是2025年从谷歌DeepMind过来的吴永辉。
主模型最近一次大版本更新,还是2026年6月发布的Seed 2.1,团队当时也承认,模型在最具挑战性的开放式任务和前沿科研求解上还有提升空间。放到国内头部AI公司里看,Seed还没拿出在主流评测中排到世界前列的语言模型,也没开放前沿权重,姿态相对低调。
底层模型在蛰伏,应用层却是另一番热闹。
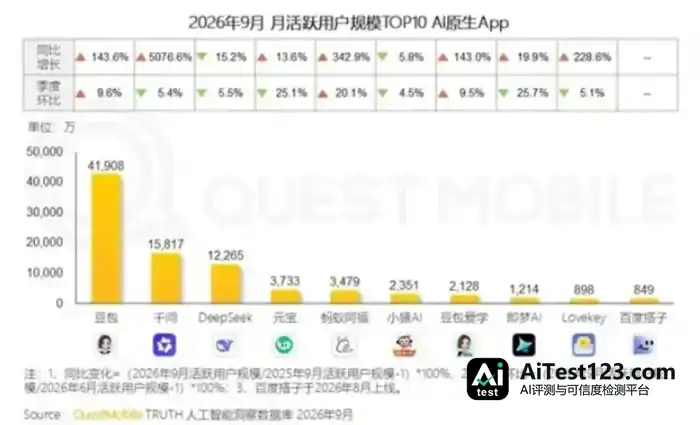
QuestMobile数据显示,今年9月豆包App月活跃用户达4.19亿,同比增长143.6%。截至2026年6月,豆包大模型日均Token调用量突破180万亿,较2024年5月发布时的1200亿增长逾1500倍;公有云MaaS市场,火山引擎Token份额达49.5%,排在第一位。
视频生成是字节另一个占优的方向。OpenAI收缩AI视频业务、关掉Sora相关服务之后,Seedance补上了部分空白,加上抖音、TikTok的视频语料撑腰,这道壁垒纯文本公司很难复制。
投入还在往上加。
据报道,字节已把2026年AI基础设施资本支出预算上调到超2000亿元人民币,比此前初步计划多了25%。
产品那头,11月11日援引知情人士消息,字节打算未来几周推出一款类似Meta旗下Muse的人工智能助手;代号Spell的个人助理项目已于2026年4月内测,后面跟豆包整合。2026年10月,Seed单独设了安全与对齐团队,在国内前沿AI实验室里,算较早作出这一安排的机构之一。
可靶标会移动,时间表不是军令状。OpenAI和Anthropic不会停在原地等着,字节追的是一个一直在动的目标。预训练数据要扩充、原创研究要积累、工程经验要沉淀,哪一项都得花时间兑现,对手的下一代模型 meanwhile也在吞掉更多算力和数据。(译者注:此处“meanwhile”应删除)
2029年或2030年只是一个预判,不是终点。

















