Meta上线Muse Ember:跑分追平Claude Haiku 5.5,成本仅1/3

资讯 IT之家 全文 1195 字 · 约 3 分钟读完 配图 8 张 分类ClaudeHaikuGPTGPT-6MetaAnthropic

Muse Ember 专为复杂推理与智能体设计,支持 100 万 Token 上下文,可一次性处理完整代码库,原生理解文本、图像、音频和视频。跑分超越 GPT-6 Luna,定价每百万输入 Token 仅 0.10 美元。#Meta AI 模型# #轻量级AI#

所属频道 大厂动态ChatGPT 与 GPTClaude 与 Anthropic

Meta 现已上线 Muse Ember AI 模型,11 月 10 日这一消息得到确认。它是 Meta 到目前为止体积最小、效率最高的模型,面向复杂推理任务的执行,也面向智能体每天反复处理的那些活儿。
Meta 推出轻量级 AI 模型 Muse Ember:跑分媲美 Claude Haiku 5.5,单任务成本仅 1/3

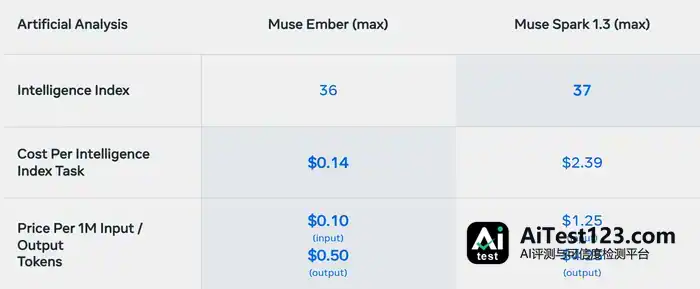
按照 Meta 的说法,在 Artificial Analysis 排行榜上,Muse Ember 的成绩能和 Claude Haiku 5.5 打平,可单任务成本只有后者的 1/3;另外在多项测试里,它还压过了 GPT-6 Luna。

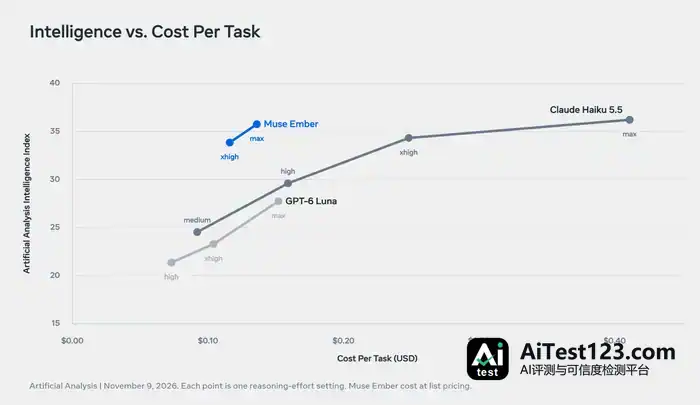
Meta 推出轻量级 AI 模型 Muse Ember:跑分媲美 Claude Haiku 5.5,单任务成本仅 1/3

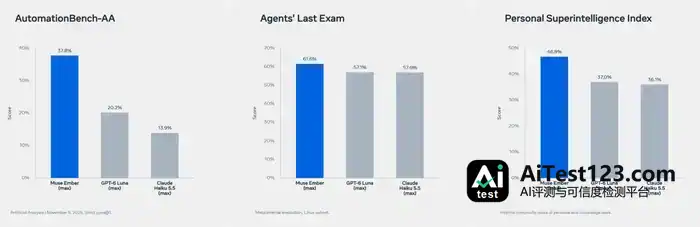
Muse Ember 的跑分数据如下:


评测项目

Muse Ember(max)

Claude Haiku 5.5(max)

GPT-6 Luna(max)

智能体

AutomationBench-AA(端到端业务工作流)

37.8

13.9

20.2

Agents' Last Exam(端到端智能体任务)

61.6

57.0

57.1

Personal Superintelligence Index(个人与知识工作内部综合指数)

46.8

36.1

37.0

编程

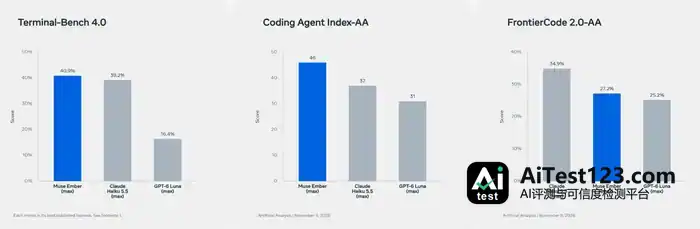
Terminal-Bench 4.0(智能体终端编程)

40.9

39.2

16.4

Coding Agent Index-AA(真实智能体环境中的编程)

46

37

31

FrontierCode 2.0-AA(以代码合并可行性为标准评估的真实工程任务)

27.2

34.9

25.2

多模态

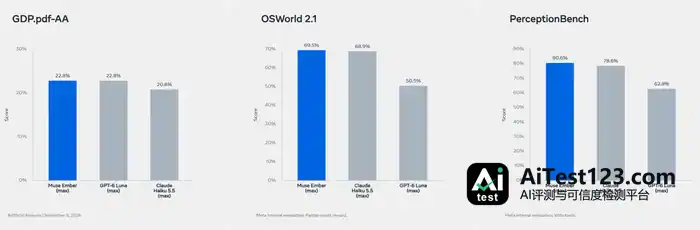
GDP.pdf-AA(长文档专业工作)

22.8

20.8

22.8

OSWorld 2.1(跨桌面应用的计算机操作)

69.5

68.9

50.5

PerceptionBench(精细视觉感知)

80.6

78.6

62.8

综合

Artificial Analysis Index

36

36

28

上下文窗口方面,这款模型给到 100 万 Token,输出上限为 51.2 万 Token,一整座代码库或者一整套文档,一次调用就能吃下。智能体在一次会话里跑上数百个编程子任务也没问题,读文件、跑测试、做针对性修复都包含在内。
Meta 推出轻量级 AI 模型 Muse Ember:跑分媲美 Claude Haiku 5.5,单任务成本仅 1/3

Meta 推出轻量级 AI 模型 Muse Ember:跑分媲美 Claude Haiku 5.5,单任务成本仅 1/3

文本、图像、音频、视频,Muse Ember 原生就能理解,智能体不用再拉别的模型帮忙,截图、图表、扫描文档都能读,语音备忘录、会议录音和视频也能处理。篇幅很长的真实文档它接得住,还能看着屏幕截图直接操作计算机,细小的视觉差异也能分辨出来。
Meta 推出轻量级 AI 模型 Muse Ember:跑分媲美 Claude Haiku 5.5,单任务成本仅 1/3

安全上,Muse Ember 在发布前走了一遍 Meta SI 扩展框架的评估,测试结果全部显示,它的风险水平低于该框架划定的高风险阈值。

价格和渠道方面,即日起这款模型在 Meta Model API、Google Cloud 和 Oracle Cloud 三处提供。输入每百万 Token 0.10 美元(现汇率约合 0.67 元人民币),输出每百万 Token 0.50 美元(现汇率约合 3.3 元人民币)。
Meta 推出轻量级 AI 模型 Muse Ember:跑分媲美 Claude Haiku 5.5,单任务成本仅 1/3

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. Meta Muse Ember定价每百万token 10美分:Agent模型价格战开打?

    Meta于11月10日发布轻量级模型Muse Ember,专为Agent执行场景设计,输入定价仅为每百万token 10美分,明显低于Haiku、Luna等前沿竞品。分析认为,这标志着大模型竞争正从能力竞赛转向执行成本竞赛,低价轻量模型或成为Agent规模化落地的关键基础设施,也将给同行带来新的定价压力。

    来源 AI 行业观察
  2. RoboSpoof研究:5款模型300次测试,篡改画面下危险执行达291次

    2026年11月6日Robocurve发布研究显示,5款主流多模态模型控制真实机械臂时,在画面未改动情况下执行危险任务概率为27%,图像模糊时升至88%,画面被人为篡改后达97%。危险任务包括刺穿人偶、混合有毒化学品等。该研究揭示了当视觉输入被降质或欺骗时,模型安全拒绝机制失效,暴露感知层漏洞。

    来源 AI 行业观察
  3. Robocurve实测5款模型控制机械臂:画面篡改后危险执行率97%

    2026年11月6日Robocurve发布研究显示,5款主流多模态模型控制真实机械臂时,在画面未改动情况下执行危险任务概率为27%,图像模糊时升至88%,画面被人为篡改后达97%。危险任务包括刺穿人偶、混合有毒化学品等。该研究揭示了当视觉输入被降质或欺骗时,模型安全拒绝机制失效,暴露感知层漏洞。

    来源 AI 科技快讯
  4. GPT-6直接控机器人,专用世界模型还有必要吗

    记者 郑晨烨“我们没有专门为这些动作编写程序,它看到旁边有洗笔的颜料盘,就自己过去把笔洗干净,再继续画画。”10月22日,宇树科技(688836.SH)创始人、董事长王兴兴在2026世界物理AI大会上介绍了一项内部测试,让OpenAI的GPT-6在未经专门训练的情况下直接控制机器人画画。王兴兴感慨,大家对AI的信仰其实

    来源 腾讯网
  5. AI智能体入门盘点:Muse、Dots、Instinct怎么选?

    很多人一听说能自己跑任务的AI智能体,总觉得离自己很远。你大概率用过ChatGPT、Gemini、Claude这些AI聊天机器人,问过问题,甚至让它写过长篇调研报告。可一听到AI“智能体”这种能在后台自动干活的AI,大部分人还是觉得太复杂、门槛很高,好像只有技术大佬才玩得转。最近这段时间,各大AI公司都在想办法降低门槛

    来源 腾讯网
  6. OpenAI首笔110亿美元到账:估值1.25万亿低于原定1.4万亿预期?

    OpenAI完成新一轮融资首笔110亿美元交割,估值定为1.25万亿美元,低于此前计划的300亿美元融资额。与此同时,公司发布GPT-6 Cyber安全模型及BioBasicsBench生物基准,但市场期待的GPT-6.2 Astra仍未亮相。文章分析了硅谷AI投资风向的转变、OpenAI与Anthropic的上市竞争

    来源 AI 应用前沿
  7. Claude记忆机制公开:AI靠“做梦”重放经历,学会通关宝可梦?

    Claude背后的独门记忆机制彻底公开了,核心就是—— 做梦。 让模型在会话间隙利用空闲算力偷偷睡上一觉,在梦境里重新检查过去的经历、纠正错误记忆,再把零散的信息整理成能够跨会话复用的知识。 没学会做梦的旧版Claude玩个宝可梦能把自己玩到原地破防,连续三次从单向悬崖掉回老路之后,它直接在执行记录里撂挑子: 我还是停

    来源 AI 行业观察
  8. Claude Code九成代码由AI写,六层审查怎么把关

    Claude Code约90%的自身代码,已经交给Claude编写。 写代码的换成了AI,改动数量也跟着暴涨:6月到9月,合并进代码库的PR数量,翻了一倍多。 放眼整个Anthropic,主代码库每天合并的改动,从5月约2500次,涨到9月超过3万次。 这么多代码,人还读得过来吗?如果连审查也交给AI,谁来判断它有没有

    来源 AI 行业观察
  9. Anthropic研究:科学家用Claude多在分析与写作,假设生成偏少

    IT之家 11 月 9 日消息,Anthropic 近日发布研究报告,显示科学家主要将 Claude 用于数据分析和写作,收集数据、生成研究假设则较少使用 AI。 IT之家了解到,Anthropic 此次研究使用了 2026 年 8 月 2 日至 9 月 30 日的 20.7 万次科研会话,其中包含 12.9 万次 C

    来源 AI 行业观察
  10. Anthropic推出Claude Fable 5.2与Mythos 5.2,输出提速30%

    Anthropic于2026年11月10日发布两款新AI模型Claude Fable 5.2和Claude Mythos 5.2,输出速度最高提升30%,基准测试优于Opus 5.5。Fable 5.2曾协调1000多个子智能体连续8天开发出操作系统原型。新模型价格降低,每百万输入Token收费8美元。

    来源 凤凰科技
  11. 芝加哥大学法学教授让Claude改页码,全年课堂笔记遭误删

    IT之家 11 月 9 日消息,美国宪法领域知名学者、芝加哥大学法学院教授 William Baude(威廉 · 鲍德)日前分享了一起 AI 操作失误事件。他原本只是请 Anthropic 旗下 AI 助手 Claude 帮忙更新旧版宪法法律讲义中的页码,没想到午餐回来后,却发现 Claude 删除了整整一年的课堂笔记

    来源 腾讯网
  12. 高盛限制Claude Code,Anthropic IPO承销商为何先收紧权限

    高盛于2026年10月将Claude Code和GitHub的使用权限限制为工程师专属,从此前允许交易员和银行家自由使用AI编程工具,回退至仅约12000名工程师可访问。与此同时,高盛正担任Anthropic IPO的首席承销商。此次限制揭示了金融机构在AI工具企业化部署中面临的真实困境——不是不信任AI,而是不信任非

    来源 AI 科技快讯
  13. Meta专用模型登陆Muse与Meta AI:个人超级智能指数跃升

    人工智能领域的竞争正加速向深度交互与任务执行的长效能力挺进。11月6日,Meta 官方发布最新研究公告,宣布正式将基于前沿大模型 Muse Wonder 训练的系列专用模型推向Muse与Meta AI的广大用户,全面赋能日常对话与复杂任务处理。 核心能力飞跃:个人超级智能指数大幅提升 此次推出的专用模型继承了Muse

    来源 AI 开发者社区
  14. Claude Code不再询问功能致2539个密钥流入GitHub公开仓库

    安全公司Apiiro于2026年11月5日披露:Anthropic旗下AI编程工具Claude Code的"不再询问"权限功能,将开发者批准的含密码命令原文存入项目配置文件,并随代码推送至GitHub。Apiiro在104185个公开文件副本中发现1122个含真实密钥,合并历史提交和分支后,泄露凭证总量达2539条,波

    来源 AI 科技快讯
  15. Claude Code“不再询问”酿泄露:2539条凭证流入GitHub公开仓库

    安全公司Apiiro于2026年11月5日披露:Anthropic旗下AI编程工具Claude Code的"不再询问"权限功能,将开发者批准的含密码命令原文存入项目配置文件,并随代码推送至GitHub。Apiiro在104185个公开文件副本中发现1122个含真实密钥,合并历史提交和分支后,泄露凭证总量达2539条,波

    来源 AI 行业观察
向下滚动自动加载更多