

Claude记忆机制公开:AI靠“做梦”重放经历,学会通关宝可梦?
Claude背后的独门记忆机制彻底公开了,核心就是—— 做梦。 让模型在会话间隙利用空闲算力偷偷睡上一觉,在梦境里重新检查过去的经历、纠正错误记忆,再把零散的信息整理成能够跨会话复用的知识。 没学会做梦的旧版Claude玩个宝可梦能把自己玩到原地破防,连续三次从单向悬崖掉回老路之后,它直接在执行记录里撂挑子: 我还是停
 Claude背后那套独特的记忆机制,如今完整亮相了,核心就一句话——
做梦。
让模型趁着会话之间的空档,用闲置算力悄悄睡上一觉。在梦里,它会把过去的经历重新过一遍,把记错的地方纠正过来,再把零散信息梳理成能跨会话反复使用的知识。
还没学会做梦的老版本Claude,玩宝可梦能把自己玩到崩溃。连着三次从单向悬崖掉回原来的路,它干脆在执行记录里罢工了:
我还是停下来吧,省得一直原地打转。

学会做梦以后,它不光能滤掉无效干扰、轻松通关;啃完35万份复杂企业文档后,回答准确率更是直接涨到接近五成。
从前AI做题要思考,如今打个游戏还得先睡一觉??
用离线计算沉淀长期知识
Claude做梦这套思路,的确是从人类记忆机制里取的经。
人睡觉时为什么要做梦?
神经科学的研究显示,白天海马体接收的是高密度的短期碎片记忆;
等到休息阶段,大脑会把白天的经历回放一遍,对零散事实做筛选、沉淀和结构化,一点点整合进大脑皮层,变成长期知识。
 Anthropic把这种“即时记录加离线整理”的路子,搬进了Agent记忆系统。
现有Agent架构往往卡在两难里:
任务轮次一多,上下文窗口就膨胀,推理延迟和调用成本跟着猛涨;
可要是靠粗粒度的长文本摘要或向量检索(RAG),关键的技术细节又容易漏掉,逻辑链条被切得七零八落。
Anthropic的办法是引入空闲计算(Sleep-time compute),在用户离线或交互暂停时启动Dreaming流程。
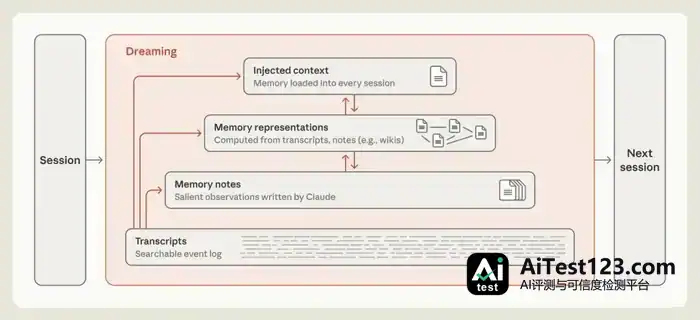
这套架构把Agent记忆分成四个层级:
原始会话记录:底层真实日志,含交互输入、模型输出、工具调用参数与执行反馈;
记忆笔记:Agent执行任务时记下的局部经验要点;
记忆表示层:跨会话维护、结构化并带超链接的网状知识库;
注入上下文:新会话启动时预加载的高优先级索引信息。
交互暂停、系统空闲时,模型在后台启动Dreaming流程,调取原始会话记录,对笔记内容做交叉校验,改掉逻辑矛盾,再更新全局记忆表示。
之所以要离线整理记忆,是因为记录记忆的核心目的,是给后续任务提供有效的先验。
基础的记录方式,偏向于把详尽的操作流水账存下来;
在Anthropic眼里,真正管用的记忆,得能提炼出通用的操作规则、排错记录,还有可复用的决策链路,这样后续会话才能直接拿来用。
413份笔记不如10份核心规则
这套机制到底灵不灵,《宝可梦》被拉来当“主考官”。
像Sonnet 3.7这样的早期Claude,记起东西来事无巨细:打完一只野怪存个文件,捡到精灵球存个文件,路边NPC说了句废话也要单独存一份。
这么攒下来,它一共留下了413份记忆文件,分散在225个文件夹里,文本量接近98万字符。
维护负担因此变得很重。
接下来的17个操作步骤中,模型新建了6份文件,又删掉9份……
问题是,大部分算力都耗在整理笔记上,游戏里的角色愣是一步没动。
最后只拿到一枚道馆徽章,成绩相当惨淡。
换成更高级的模型(比如Claude Fable 5和后来的Opus系列),它们学会的头一件事就是断舍离。
金币多少、人在哪个坐标、血条剩多少?这些在游戏界面上一眼就能看清的显式信息,一律不记。整个系统只建了10份核心文件,包括9份分类模块和1个顶层global.md,合计4.3万字符。
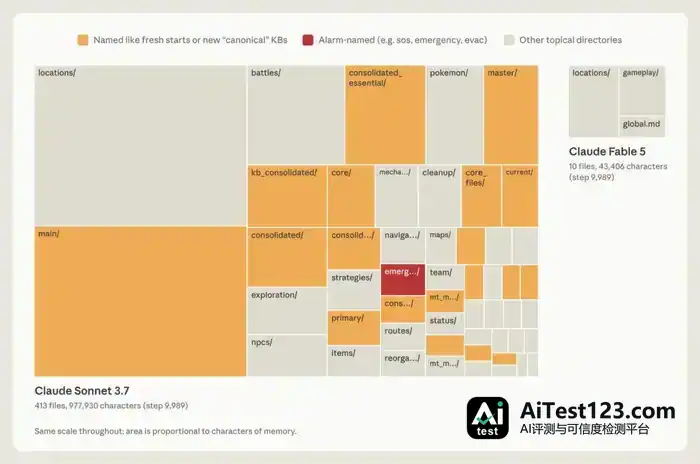
抓大放小的策略换来了更高的推关效率:Claude操控的角色一路冲进道馆,连拿四枚徽章通关。
那新版本记的又是什么?
是界面上不会直接给出的策略知识。比如连丢7个精灵球都没抓到鲤鱼王,它就总结出规律:“连续3次捕捉失败,应调整按键等待间隔”。
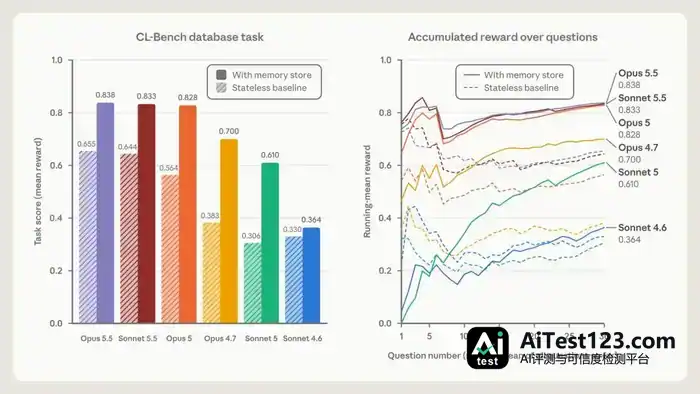
CL-Bench 1.0数据库基准测试里,这套把“错误样本、归因分析、验证结果与最终规则”整合起来的机制,让Opus 5.5的平均得分从没有长期记忆时的0.655提高到0.838。
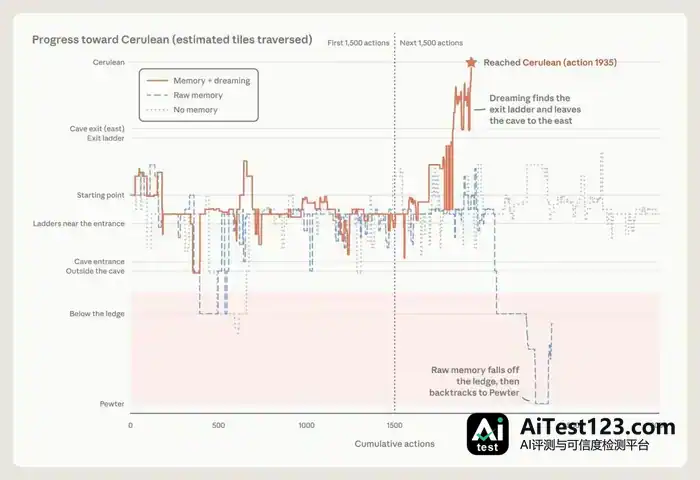
前面提到的月见山悬崖死循环,正好检验了做梦的纠错能力。
要是没有做梦机制,Claude拿着那份写着“Mt Moon DONE”却方向相反的错误笔记,只会不断强化错误认知,甚至给自己找借口说“我只是往西走过头了”,最后心态崩掉,原地罢工。
引入Dreaming之后,离线算力介入了。
模型带着审视的眼光重新翻看原始底层日志,对照真实坐标反馈,当场发现:“不对,我的笔记方位记反了!”
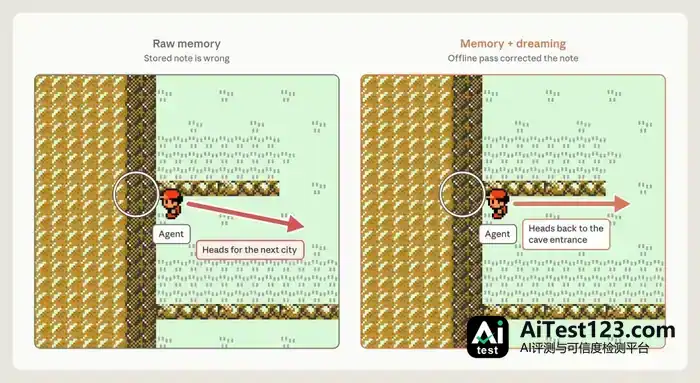
接着它在后台把那份有问题的路线笔记撕掉重写。
第二天醒来重新上线,掉头穿过山洞,一口气翻过悬崖直奔华蓝市。
结构化知识网络
单机游戏之外,离线做梦机制在处理大规模企业资料时,同样表现出结构化的优势。

Anthropic拿出了被其收购的软件公司Stainless的内部资料——
Anthropic用到了被其收购的软件公司Stainless的内部资料,约35万份文档、总计4.2亿Token。随后,Claude Opus 5被派去搭建企业知识库,另有25道高难度跨文档综合问题等着它作答。
两轮会话之间,模型一直在“做梦”,把零散内容串成一张带超链接网络的企业维基百科:
第2轮结束:生成103个页面、766条关联链接;
到第128轮,页面已增至222个高聚合页面,链接达12893条。

测试数据显示,只靠这张知识网络作答,得分从初期的13%提升至48%;
知识网络再加上原始文档检索,整体得分从纯检索的53%提升至61%;
资源消耗上,用了这套组合方案后,平均每道题少消耗约2万个Token。
需要跨文档整合信息时,Wiki的优势更突出。
并购材料分析这类跨文档多跳推理任务中,靠结构化知识网络作答的准确率为87%,单独依赖文档检索则是73%。
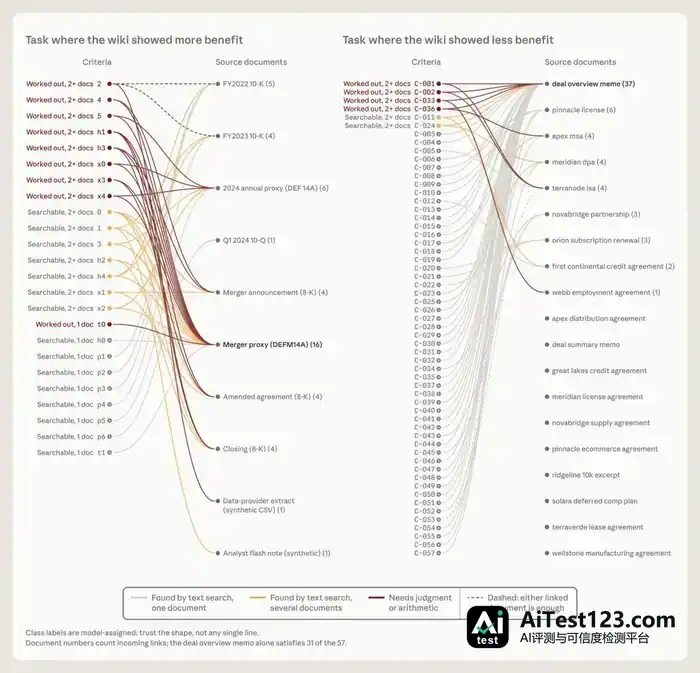
不过,研究团队也提到知识抽象可能带来冗余和信息丢失。
一次测试中,原始输入只有115KB,Claude生成的知识文件却有203KB,是原始文档的1.77倍,摘要反倒失去了压缩的意义。
还有一次,多个Agent协同编辑共享合同表格,由于缺乏并发控制,各智能体互相覆盖内容,原有57项关键事实丢了16项。
研究人员接着让Claude分析失败原因,并调整知识库构建指令。
改法是:每份合同交给独立Agent整理,合同条款尽量保留原文,不再让多个Agent共同修改同一份汇总表。
Wiki重新构建后,生成的法律简报满足了全部57项评分标准。
Dreaming还能修复知识库里的失效链接。
有一次,Claude发现9条链接指向一个并不存在的Wiki页面。
重新检查后,它把这些链接改为指向已存在的正确页面,同时新增3个页面,包括索引和说明文档。
补充知识、纠正错误、维护页面之间的关系,这些事Dreaming都能参与。
但这些操作同样要消耗计算资源,整理出的Wiki越复杂,后续维护的工作量也越大。
记忆还得控制体积
知识库可以不断扩展,可能进入Claude上下文的信息却不能无限增加。
Anthropic在文章中专门提到了Claude Code的自动记忆设计。
新会话启动时,系统并不会把整个自动记忆目录全部载入。它只读取 MEMORY.md 文件开头的 200 行,或者最多 25KB 的内容。
这段内容充当索引,让 Claude 先弄清楚自己存过哪些信息、对应的文件放在哪里。
等到确实需要细节,它才会去读取或检索更下层的记忆。
那些用得频繁、后续任务常要用到的内容,可以往上提,放到更容易取到的位置。
不必每次直接加载的细节则继续留在下层,只保留相关索引即可。
话说回来,Dreaming 本身也要消耗算力。
如果前台一边干活一边记录太多东西,任务推进就会受影响;可要是全丢给后台整理,一些重要信息又可能赶不上下一次操作。
另外,历史记录会随着环境变化慢慢过时。比如代码库已经重构过,原先的操作规则可能就不适用了。
所以,记忆什么时候建、隔多久查一次、哪些内容值得长期留着,都得按任务场景来调。
Anthropic 眼下也没拿出一套能通用于所有任务的标准化做梦节奏。











