

Claude Code九成代码AI写,六层审查怎么兜底?
九成代码AI写,谁来审?Claude Code亮出6道关卡!
 Claude Code里约90%的代码,如今由Claude自己产出。写代码的换了主角,改动量随之猛涨:6月到9月,合并进代码库的PR数量翻了一倍还不止。
放大到 Anthropic整体,主代码库每天合并的改动,5月约2500次,9月已超过3万次。
代码堆到这个量级,人还读得过来吗?要是连审查都甩给AI,它出了错又由谁来兜?
10月15日,Claude Code团队把内部代码审查流程摊开讲了一回。按他们的说法,PR数量翻倍的同时,需要回滚的PR占比反而相对下降超过40%。
撑住这个结果的,是六层检查,外加一套发现快、回滚也快的兜底机制。
团队判断,到了这个体量,逐行人审已经不现实。审查本身没被砍掉,只是读代码的大部分活儿,交给了机器。
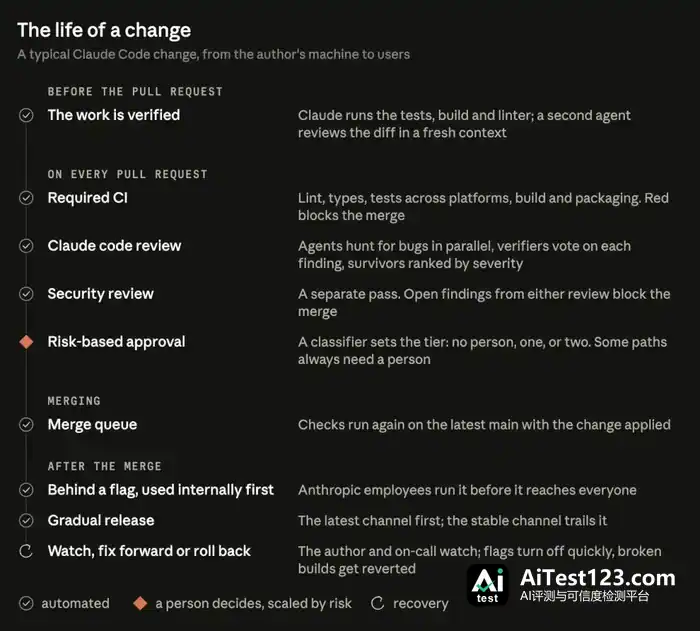
AI写出的代码要上线,先得跑测试、过AI审查和安全审查,再按风险大小决定要不要人点头。
在Claude Code团队眼里,「有没有人读过这段代码」问得不够准。该问的是:这次改动可能出什么错,出错时该由哪道检查拦住?
AI先交出验证结果,人工审查排在后面
一次改动要连过六道检查,末尾还架着一张安全网。
第一关设在创建合并请求(PR)之前。Claude得跑完测试、完成构建;碰到界面相关的改动,还要截图和设计稿对照。
随后另派一个子智能体,用全新上下文审查代码差异。它没参与写代码,任务就是挑毛病。
官方把要求说得很死:Claude必须把执行的命令和输出摆出来,只回一句「测试全部通过」不作数。
普通开发者也能照这个路子来:给AI派任务时,顺手把验收标准讲清楚。
第二关才轮到PR上的AI审查。几个智能体并行找bug,另一组再投票核验,票数够了,问题才会贴到PR上。
至于只牵扯代码风格、诊断提示或代码清理的意见,压根不会发到PR,直接过滤掉。
今年3月这套审查刚落地时,内部PR里能拿到实质性审查意见的比例从16%涨到了54%。
第三关叫安全审查。
团队内部有个硬规矩:代码审查和安全审查提出的问题只要没关掉,PR就进不去,修好或者写清理由关掉,二选一。
第四关是持续集成检查,代码规范、类型检查、各平台测试、构建打包都算在内。
哪怕只是改一个普通的命令行工具,交到人手里之前也得先跑过几十项检查。
老是冒出来的问题,会被收进下一轮的检查依据。
CLAUDE.md管项目约定,REVIEW.md管审查器该盯哪里、哪些能跳过——这一轮踩到的坑,就成了下一轮的参照。
同一条意见被提到第三遍,就得写进规则。
第五关是人工审批,也是最要紧的一关,下一节展开说。
第六关管合并和发布。
前面几关都过了,改动还得进合并队列排队。
排到它的时候,系统会把它挪到主分支最新版本上,所有检查重跑一遍。
这一步防的是单个改动都没毛病、凑到一起却出岔子。
合并完,新功能也不会立刻推给全部用户。
它先藏在功能开关后面,只对Anthropic内部员工开放。这帮人天天高强度地用,往往比外部用户更早碰到问题。
功能开关相当于一个总闸,不用改代码、不用重新发版,就能决定功能开还是关。
最后还有兜底。
一旦出事,先把总闸拉下来。
团队每周轮班值守,每次事故复盘都要问一句:这事本来该在哪一关被拦住?
审查并没有消失,它变成了贯穿开发、合并、发布的一层又一层检查。
零人审批的边界在哪里
前四关全绿之后,第五关按风险分级,决定这次改动要几个人点头。
文档、文案、仅内部可见的功能,以及藏在开关后面的新增改动,都算低风险,自动审查和安全检查过了就能免掉人工审批。
普通的产品改动,以及缓存、自动更新器、系统提示词这类敏感区域,需要一个人批准。
那些风险最高的代码,再加上少数被单独点名的路径,得过两道人工审批。
这么看,低风险改动岂不是已经进入「无人驾驶」状态了?事情没这么简单。
档位由改动本身来定:先有一个分类器读代码、判定风险高低,再由第二个分类器判断这次要不要额外加一道人工审批。
凡是被代码所有者标成敏感路径的地方,以及全部CI工作流文件,都必须有人来看。
轻量审批这条通道也设了门槛:只向仓库「可信作者」名单里的人开放,名单之外的人想走这条路,得另找一个人点头。
带着AI写代码的那个人,本身就被算作一名审查者,也得像自己一行行敲出来那样,对这次改动担起责任。
零人审批,并不意味着没人负责。功能该不该做、架构合不合理,这些要由人来定;现有检查能不能盖住这次的风险,同样得人来判断。
正因如此,Claude Code团队立了一条规矩:你合进去的代码,日后出了问题,通常也由你来收尾。
在按下批准之前,审查者要把话说清楚——这些检查到底验证了什么,还有哪些风险没被覆盖。说不清楚就先别急着点通过,把该补的审查补上。
AI审查也会失灵
自动化审查有时候会把自己绕进去。有个CLI项目的PR,一晚上来来回回跑了五十多轮审查和修复,最后是作者手动喊停的。
一个小毛病,人一秒钟就能放过,AI却不会,它会老老实实去改;改完又是一次提交,提交又触发一轮审查。
团队用git blame回查后发现,审查器反复标出来的问题里,约59%在首轮审查之前就已经存在于老代码中。它很少揪出新bug,只是每一轮多翻出几个旧的。
之后他们改了四条规则:满三轮还没过,就提醒作者先退一步、重新想方案;前几轮过后,只审新加进来的改动;
同类问题一次说清;已经提过的问题不再重复。
效果很快就出来了。只经过一轮审查和修复就通过的内部PR占比,从65%升到78%;需要五轮及以上的,从8.9%降到1.5%;平均审查次数,从2.08降到1.32。

复审规则调过之后,只走一轮审查和修复就放行的比例由65%涨到78%,平均审查次数则从2.08次降到1.32次。
审查这件事,一半功夫花在挑毛病上,另一半花在判断什么时候该停手。
多叠几层审查,就能保证万无一失吗?
Anthropic自己就拿出过一个反面例子。
3月26日,Claude Code上线了一项优化:会话闲置超过一小时,就清理一次旧的推理记录。
问题出在一个bug上:它使得对话恢复之后,每一轮都触发清理,Claude因此记不住东西、反复说同样的话,调用工具时也不正常。这个bug一直到4月10日才被修好。
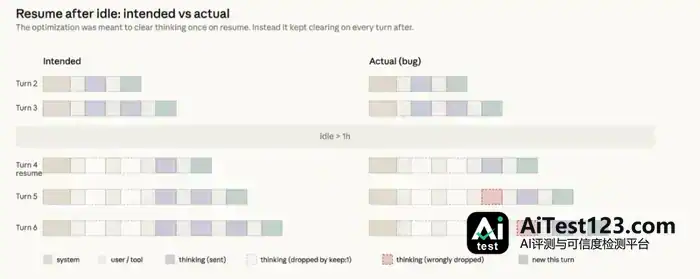
按设计,闲置之后只该清一次旧推理,实际却每轮都在清;红框标出的就是被误删的内容。
官方在4月23日的复盘里承认:
这个改动穿过了多轮人工和自动审查,单元测试、端到端测试、内部试用全没拦住,光确认根因就花了一周多。
复盘里还有转折。
团队用Code Review重审了出事的PR,在给足相关仓库上下文时,Opus 4.7找到了这个bug,Opus 4.6没找到。
这次回测说明,模型能力和上下文完整性,都会影响检出结果。于是他们让审查能引入更多仓库。
现在,每一起事故都会变成一道考题。
团队把PR收集起来,由熟悉代码的工程师逐个确认其中的bug,整理成一套考题。
审查器每天对着这套考题跑分。每次调整提示词、工具或模型,也要用它检验效果:成绩没有提高,这次调整就不采用。
团队也没把话说满。
改动上线后,仍要靠开发者、值班人员结合数据看板发现异常。
根据回滚率等指标自动收紧审批的「熔断」机制,还没有建好。工程师们希望先补上这道保险,再让更多改动走零人审批。
审查难免漏检,发现和补救也要跟上。
Claude Code团队里有人是这么说的:慢下来确实出错会少,可这主要是因为做的事也变少了。于是他们宁可把精力放在更快发现问题和更快修复上。
一个人用AI写代码,要验收什么
AI审查只给意见,拍板的还是你。
所以,别急着追求「不用看」,而是先让AI每次交付都回答三个问题。
第一,怎么验证的?
具体跑了哪些检查、结果如何、还有哪些情况没覆盖到,这些都要交代清楚。
Claude Code的创造者Boris Cherny讲过,给Claude一个能验证自己的手段,或许是最要紧的事。他估算,这么做能让最终结果的质量提升到原来的2至3倍。
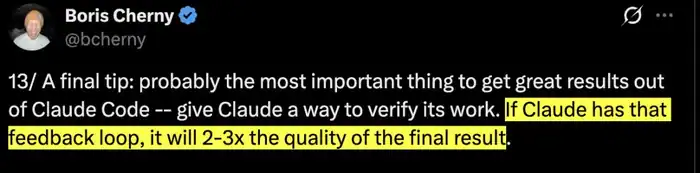
他的建议是让Claude自己验证工作、形成反馈循环;按他的估计,最终结果质量可达原来的2—3倍。
第二点,会影响哪里?
改动会牵涉到哪些用户、哪些数据、哪些权限,得先弄明白。
比如让AI给汇报工具加个共享功能,那就要问清楚:链接谁点得开,点开后又能看到哪些内容。
第三点,出了错怎么撤回来?新功能能不能一键关掉,能不能退回到上一版。
动手之前先把当前版本提交存档,每次改动尽量做小。先保证撤得回来,再谈少审几遍。
这三个问题之外,还有三个习惯值得养成。
其一,换一个「脑子」来复审。
写代码的那个会话,最容易对自己埋下的bug视而不见。
可以开一个新会话,也可以让子智能体带着全新上下文去复审;本地的/code-review和/security-review命令同样能直接跑。
其二,把改动分个档。
改文案、调样式这类,检查过了、实际效果也确认了再合并;碰上登录、付款、删除数据,就得人工细查关键逻辑,再补上针对性测试。
一开始先严一点,等验证和回滚流程都跑顺了,再慢慢减少低风险改动的人工审查。
其三,三轮还不过,就换个思路。
AI改了三轮仍在原地打转,别急着催第四轮,先回头看看方案本身是不是就有问题。
最要紧的一点:AI说「通过」,并不等于你已经完成验收。
代码是你让它写的,上线之后的结果,也得由你来担。
Claude Code团队想要达到的目标,是多数PR至多一人介入,同时把回滚率和事故率守住。
人的注意力,应该更多放在判断风险、确认检查够不够充分,以及出错之后怎么补救上。
人可以不读每一行代码,但每一次上线,都得有人负责。
参考资料:
https://claude.dev/blog/solving-code-review-at-anthropic/?utm_source=chatgpt.com
https://www.anthropic.com/research/april-23-postmortem?utm_source=chatgpt.com
https://x.com/bcherny/status/2007179861115511237











