Claude能力年增翻倍:METR称80%增量由AI研发贡献
Anthropic 研究员:我感觉自己有了一批博士后和研究生。
AI 帮人研发下一代 AI,这件事如今有了具体数字。
11 月 5 日,第三方评估机构 METR 发布了一份关于  Anthropic 的调查报告,结论是:这家公司过去一年取得的基准能力进步,大致相当于此前两年的进步。
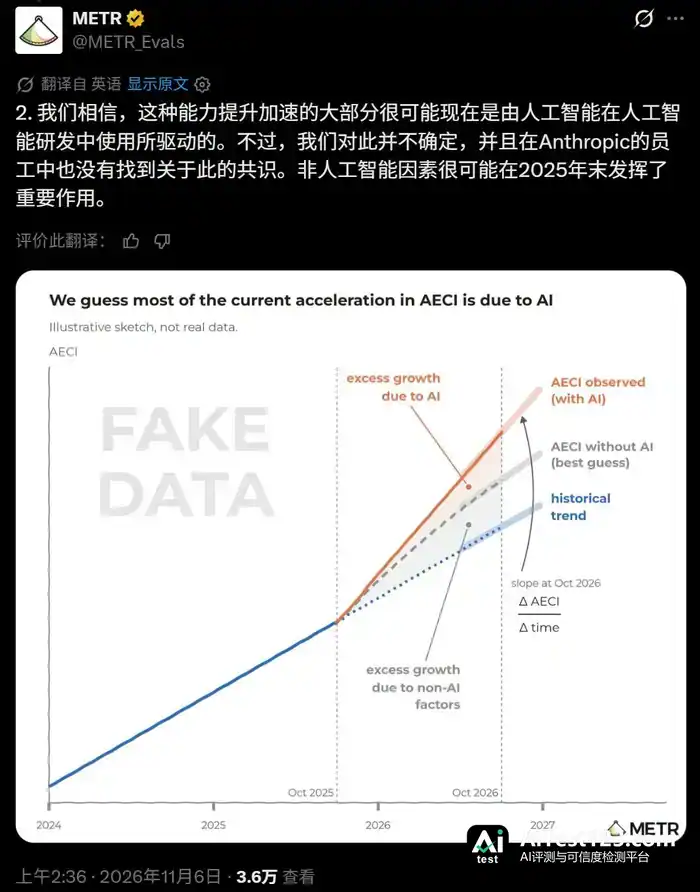
从 8 月 12 日到 10 月 29 日,该机构花了约 11 周时间进入 Anthropic 内部,查看模型成绩、训练算力、研发效率等资料,并访谈了研究人员。
他们的分析用的是 Anthropic 版综合能力指标 AECI。数据显示,2025 年 10 月以后,大模型在这一指标上的进步速度约为此前的 1.9 倍,95% 置信区间为 1.5—2.8 倍。
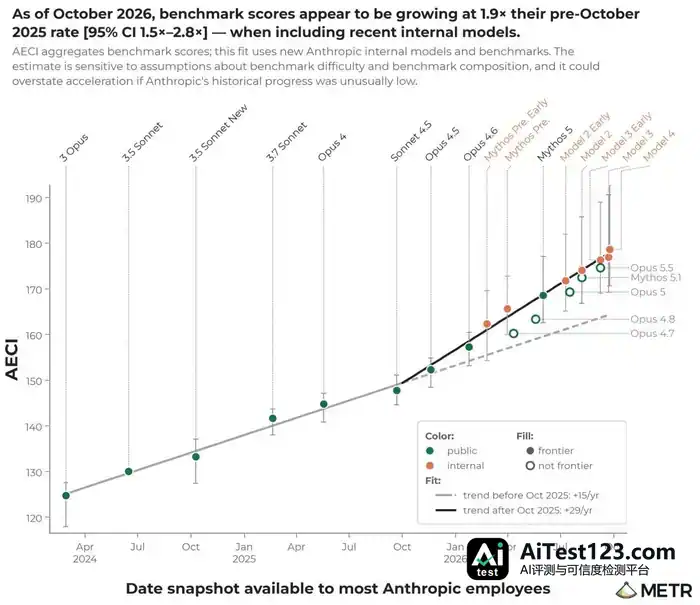
从 2025 年 10 月 7 日起,这个分数由约 15 分 / 年升到约 29 分 / 年,一年走完了此前约两年的路,量级大致相当于  Claude 2.1 到 Sonnet 4.5。Anthropic 自己的风险报告此前假设 Mythos Preview 只是单次跃升,之后会回到原来的趋势,结果新模型出现后,新的斜率仍在延续。
放到全行业看,前沿模型的加速只有 1.4 倍。
更关键的一点是,METR 相当确信这种加速并非来自训练算力规模增长的速度。AI 能力进步的主要推手,是 AI 自己。
访谈中反复出现的一个现象是:研究人员终于能试更多想法了。
以前一个实验可能要花一两天才能实现,时间和计算成本绕不过去,不少想法没来得及验证就被搁下。现在研究人员可以把多个想法交给 Agent,看哪些值得继续追。
有位研究人员形容,自己眼下主要受限于想法和算力,代码已不再是瓶颈。还有人觉得用了 Claude 之后,像是有博士后和研究生一起推项目。实验和实现变便宜了,研究人员更愿意尝试,许多原本被认为不值得投入精力的小实验,如今也有机会长成新的研究方向。
METR 的报告还揭开了部分此前外界看不到的内部进展。分析纳入了三个 Anthropic 尚未公开的模型,分别以 Model 2、Model 3、Model 4 代称,它们在今年 7 月至 10 月间完成训练。
目前最强的是 Model 4(有人猜它是 Claude 6),它在很多常见基准上的分数已超过 90%。10 月份 Anthropic 员工在内部对它做了主观估计,投票认为其平均对自己工作的提效达到约 12 倍。
这些模型尚未对外发布,也未必会做成公开产品,可它们的存在本身就在提醒一件事:光盯着发布会和公开榜单,未必能看清 AI 大厂内部到底在发生什么。2025 年初约为 1 倍,Opus 4.5 约为 2.5 倍,Mythos 5 约为 5 倍,Model 4 则跳到 12 倍,按指数拟合是每年 3.9 倍。
METR 估计,截至今年 10 月,当前 AI 研究加速中约 80% 来自 AI。剩下 20% 的非 AI 因素,细节 Anthropic 不让透露。
那么,AI 已经能独立研发自己的下一代了吗?
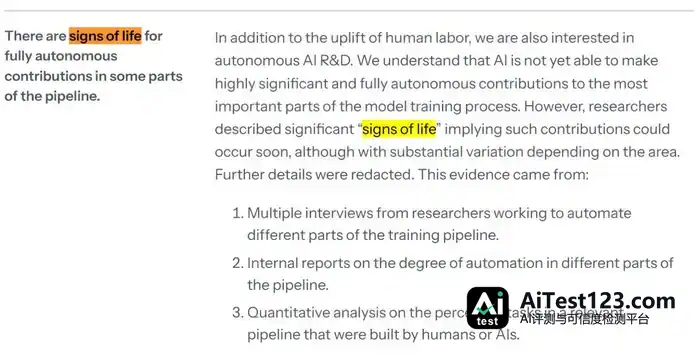
距离让 AI 自主研发下一代模型的完整递归自我改进(RSI),目前仍有差距。Anthropic 的研究员自己认为,在模型训练最重要的部分,AI 尚未作出高度重要且完全自主的贡献,眼下主要收益仍来自 AI 辅助人类研发。

不过 Anthropic 研究员已把 AI 的大量自主贡献描述为「生命迹象」(signs of life),还做过量化分析,统计各环节中 AI 与人类完成任务的占比,但数据被 Anthropic 删掉了。
只要更强的模型能帮研究人员更快开发下一代,这个反馈过程就可能持续增强。RSI 的路能走多远,取决于尚未自动化的环节,以及算力等资源能否跟上。
对近未来的预测,METR 没有看到未来 12 个月会明显阻断快速进步的瓶颈;但他们也坦言,随着信息增加,自己曾多次改变判断,目前信心有限。
另外,Anthropic 虽然让第三方机构 METR 进入内部调查,但目前给出的 100 页报告经过了大幅删减。最有说服力的证据,大多被 Anthropic 自己删掉了。

同日发布的配套审查,还暴露出双方对风险的说法并不一致:Anthropic 此前把某项领先指标说成进步速度「不到两倍」,METR 依据其内部数据算出约 1.97 倍,觉得说成「约两倍」才更准确。两倍加速这件事,牵涉 Anthropic 的早期预警阈值。
METR 的判断是,不能排除截至 7 月 15 日已经越过相关阈值的可能性,不过多数相关研究人员还是倾向于认为当时没越过。双方也都认为,当时相关模型的直接灾难性风险较低。
模型参与研发的速度越快,人们能不能及时看清变化、公司能不能把不确定性充分披露出来,就成了下一代 AI 到来之前绕不开的问题。
参考内容:
https://metr.org/blog/2026-11-05-anthropic-ai-rd-acceleration-assessment/#executive-summary
https://x.com/METR_Evals/status/2118412183860351084