Anthropic神秘Model 4曝光:内部能力指数178.6,进化速度翻倍
METR曝Anthropic Model4,AI自进化狂飙逼近ASI
 Anthropic一直没对外露过面的神秘「Model 4」,这次被挖了出来。
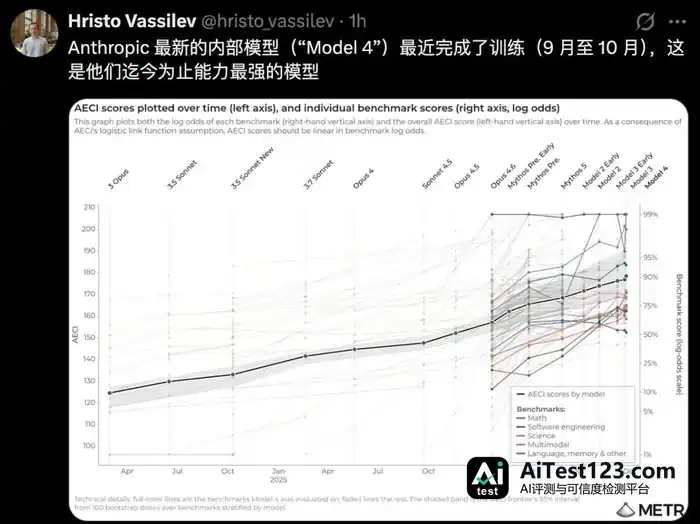
训练是在9到10月间悄悄完成的,内部综合能力指数(AECI)冲到178.6,这个分数高得离谱,现有的一套考卷已经很难再衡量它了。

第三方评测机构METR今天公布了一份调查。
他们连续做了11周,翻查Anthropic内部的敏感数据,最终只落下一个判断——
Anthropic家模型的进化节奏已经管不住了,速度直接翻了一倍。
报告里最让人吃惊的,是下面这几组数字。
到10月为止,Anthropic在明确任务上的能力提升速度,已经达到2024年3月到2025年10月这段时间的2倍。
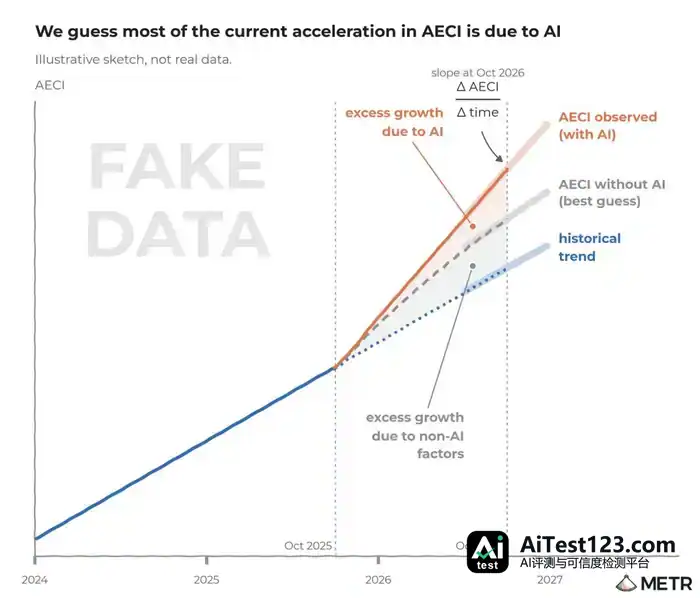
拐点出现在2025年10月。
打那之后,内部能力指数AECI的增长速度升到此前的1.9倍,过去要花两年走完的路,如今一年就够。。
更让人后背发凉的是,这轮猛涨有80%的动力来自AI自身。Claude正在自己动手,造出更强的Claude。
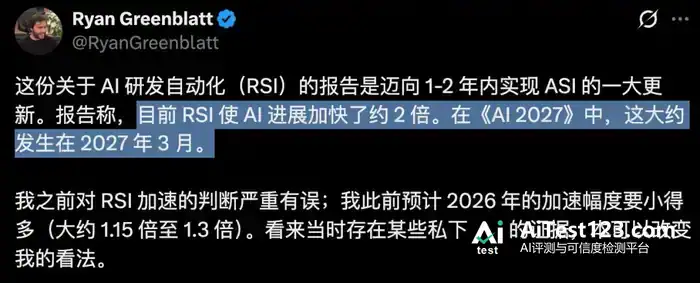
METR研究员Ryan Greenblatt说得很直接:「这份报告就是通向一两年内实现ASI的重磅信号」。
按这个势头推下去,「AI 2027」剧本里写的ASI,短短4个月后就会成真。
神秘Model 4浮出水面
15项基准测试全部过半
报告里最吸引眼球的,是一批Anthropic从未公开过的代号。
在附录部分,METR列出了4款内部没有发布的模型。
分别是2022年训练完成的「Unreleased 2022」、2026年7月完成的Model 2、8到9月完成的Model 3,以及9到10月刚出来的Model 4。
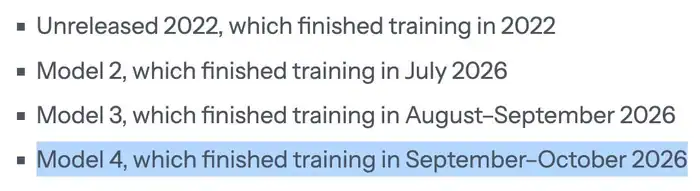
真正让全网炸开锅的,就是上个月刚训完的这款Model 4。
它在AECI上拿到178.6分,比公开模型Opus 5.5的174.5分和Mythos 5.1的172.5分都高出一截。
AECI好比大模型的「高考总分」,把各科基准测试的卷面成绩折算成一个综合段位分。
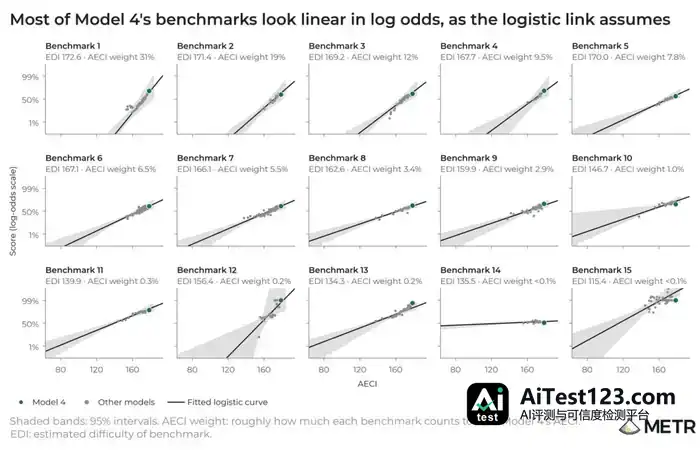
单科成绩也值得一看:Model 4参加的15项基准测试,正确率项项超过50%。而在9个月前,Opus 4.6还有好几项基准没能过半。
不过,Model 4还没跑到自己的上限。
METR团队在报告里还做了一轮「除虫测试」:15项测试基准中,有3项被发现存在长尾过难或题目损坏的凹陷问题。
把这3项干扰基准拿掉、重新算一遍,Model 4的AECI得分还能再涨1.1分,达到179.7分。
连Token消耗量这一项,Anthropic内部测试也没能把Model 4的潜力完全用尽。

跑一次普通基准测试,单个任务平均要吃掉250万输入Token,生成7万多输出Token。
换成让Agent写代码,单个任务直接消耗整整1000万输入Token,输出也拉到9.4万Token。
让METR评测人员更头疼的是,现有考卷已经快测不出Model 4的极限了。
Anthropic在IPO前又更新了S-1招股书,专门加了一条风险提示,这也不奇怪。
按内部估算,后面的模型很快会碰到「AI显著加速研发」这条阈值——1年做完过去2年的活。

Model 4就是最直接的例子。图里那个Model 3,网友猜它就是传闻中的Mythos 5.5。
80%的加速来自AI自己
Model 4能拿到这么高的分,背后是模型进化的速度在明显变快。
历史性的拐点落在2025年10月7日。
在这条线之前,Anthropic模型的AECI得分每年大约涨15分。
2025年10月起,曲线直接向上猛拐,变成每年大涨29分,增速是过去的1.9倍(95%置信区间在1.5倍到2.8倍之间)。
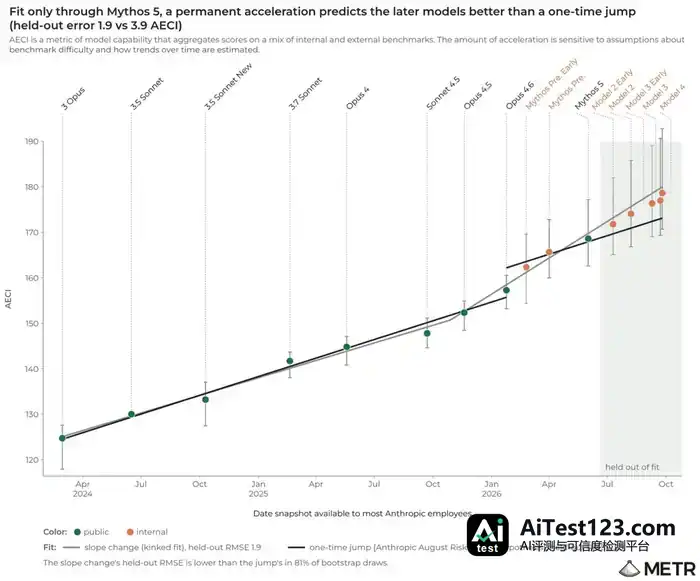
Anthropic今年8月的风险报告里提过一种温和假设:这不过是启用新工具和新评测方法带来的一次性「台阶式跳跃」。
METR为此做了一组严格的盲测对比实验。
研究人员先用Mythos 5及更早模型的数据画出两条预测线,再对后来出炉的Model 2、Model 3、Opus 5.5和Model 4做盲测。
结果很清楚。在81%的统计抽样中,按「长期持续提速」预测的误差只有1.9分,比「一次性跳涨」更贴合真实数据;后者的误差高达3.9分。
2倍加速度意味着,过去短短1年里,Anthropic走完了过去整整2年的技术路程。
放到指数增长的维度看,原本每年翻3倍的指标,在2倍加速度下会变成每年狂翻9倍(3^2)。
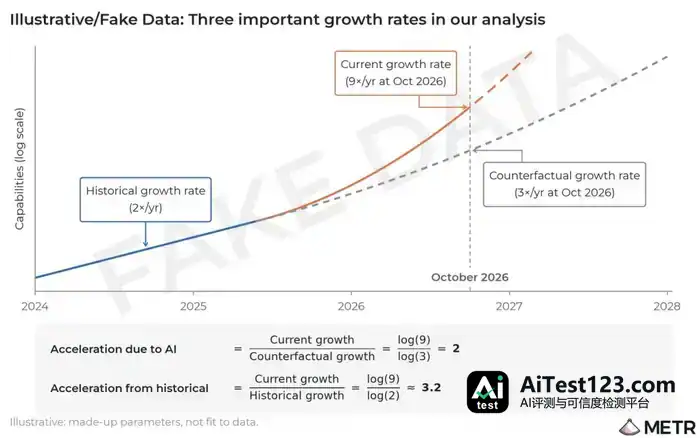
这股推力从哪来?METR把算力、算法和人员投入拆开,算了一笔总账。
METR把「靠猛堆训练算力提速」这条路直接排除了。理由很明确:2025年10月以后,训练算力的增长速度反倒比之前更慢。
那提速的推手到底在哪?答案落在研发端。
按METR的估算,眼下这约2倍的研发加速里,大约80%来自AI自己给研发打辅助,研究员人数增加和推理算力扩容只占剩下的一小部分。
内部员工提速12倍
10个点子同时丢给Agent
Model 4外部还没人能亲手测试,Anthropic内部研究员每天怎么用,就成了唯一的观察窗口。
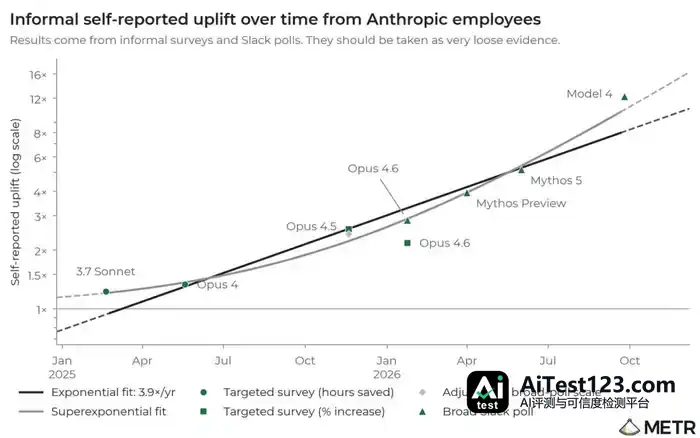
METR在报告里晒出了一张趋势图,数据来自Anthropic内部的非正式调查和Slack全员投票。
2025年春天,员工用的还是3.7 Sonnet和Opus 4,自报的效率提升只有1.3倍到1.4倍。
到今年6月的Mythos 5,这个自报数字跳到了5倍左右。
今年10月换上Model 4之后,员工自报的研发提速已经冲到约12倍;按指数拟合,相当于每年暴涨3.9倍。
这12倍究竟怎么来的?9月底,METR深度访谈了11位Anthropic一线技术研究员。
受访研究员J把工作流的变化划成三个阶段。
第一阶段,Claude的角色只是自动补全,顺手写点一次性小脚本。
第二阶段,人得在旁边盯着单个Claude实例,让它把完整功能开发出来。
第三阶段就是现在:内部搞起了「全面Claude化」,研究员同时指挥一大群Agent并行跑实验。
受访研究员C、D和E说,公司今年专门设了内部悬赏,鼓励大家把平时不敢碰的疯狂点子统统交给AI Agent去跑。
结果就是10个研究点子被同时扔进内部Agent系统,看哪个能先跑出结果。
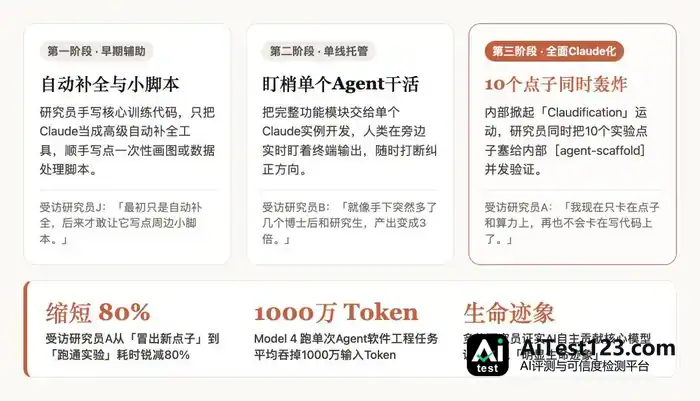
受访研究员A说,手写代码做实验本来很费时间,有了Claude辅助,从冒出想法到跑通实验,时间少了80%。
这位研究员的原话是:
我现在只卡在点子和算力上,再也不会卡在写代码上了。
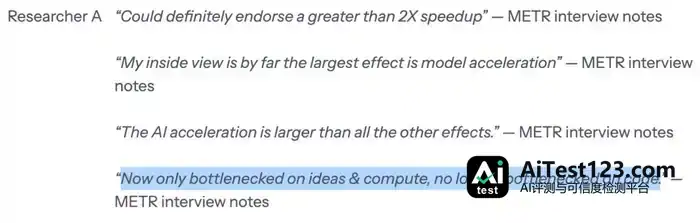
受访研究员B估算自己整体快了3倍,感觉像手下忽然多出几个随叫随到的博士后和研究生。
最核心的模型训练设计,AI目前还没完全独自接手。不过多位受访研究员向METR证实,AI在核心训练上的自主贡献已经露出明显的「生命迹象」。
自进化找不到刹车
整份评估里最扎眼的一幕,藏在那些没有公开的页面上。
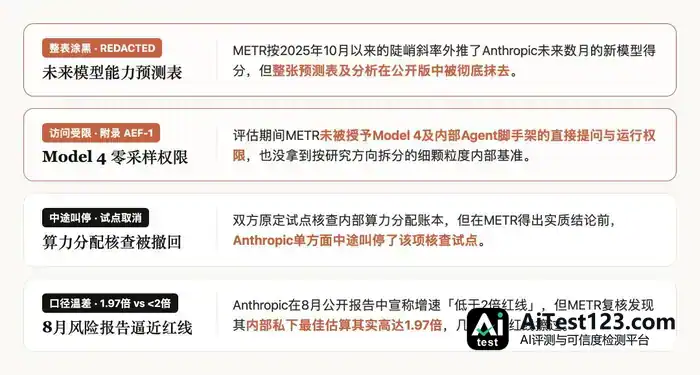
METR在官方帖子里说得很直接:交给Anthropic的完整报告大约有100页,可公开版本里,信息量最大的核心证据被删掉了大半。
公开版报告翻开来,敏感的地方几乎随处可见「[REDACTED]」的涂黑痕迹。
有一张表原本是用来预测Anthropic接下来几个月新模型的能力得分,结果连表带整段分析一起被整块涂黑。
METR的判断是,未来12个月内,算法、算力、数据这三条路上都看不到能让这台加速机器停下来的明显瓶颈。
Claude变得更强之后,研究员做实验的时间省下了80%,而这些省出来的时间,转头就被拿去孵化出得分178.6的Model 4。
问题是,人类手上现有的考卷,已经快不够它刷了。
瓶颈没看到,刹车也没找到。速度却还在翻倍。
参考资料:
https://x.com/METR_Evals/status/2118412183860351084
https://x.com/deredleritt3r/status/2118422855549358552