中国开源模型拿走美国企业89%支出,Kimi一家占61%
门罗风投报告显示,美国企业89%的开源大模型支出流向中国公司。尽管开源价格下降,但用量激增推动其成为主流。DeepSeek和Kimi在调用量与支出上占据主导,反映美国企业对中国开源AI的高度依赖及投入增长。
美国企业在开源大模型上的开销,将近九成都进了中国公司的口袋。
这笔账由硅谷风投门罗风投(Menlo Ventures)在11月3日发布的《2026年企业 AI 现状报告》里算得清清楚楚。调研覆盖近 400 名美国企业 AI 业务负责人,报告给出的数字很扎眼:美国企业投在开源大模型上的钱,89%付给了中国模型。
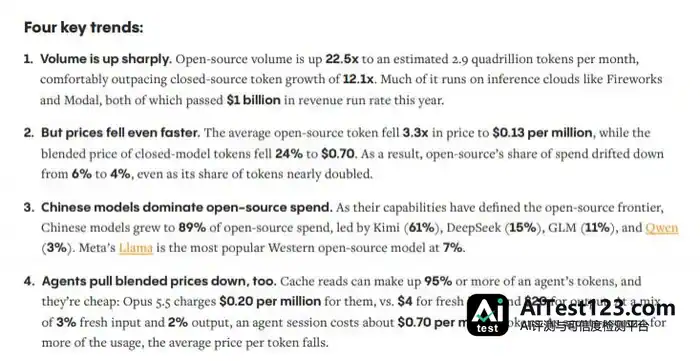
具体到各家,月之暗面的Kimi一家就拿下 61%, DeepSeek拿到 15%,智谱的 GLM 有 11%,阿里通义千问占了 3%。西方模型里份额最高的是 Meta Llama,也才 7%。
钱往中国流,并不是因为中国模型便宜到近乎白送,关键在于它们抬高了开源这一档的能力上限。
门罗风投在报告中的原话是:"随着中国模型定义了开源前沿,它们占到了开源支出的 89%"。过去一年,开源模型的平均 token 价格确实降了三分之二,从每百万 0.45 美元跌到 0.13 美元;用量同期涨了 22.5 倍,月 token 量冲到 2.9 千万亿。
价格砍掉大半、数量翻了二十多倍,落到结果上,开源占平台 token 总量的 19%,在企业模型支出里却只占 4%。
便宜,用量还猛。
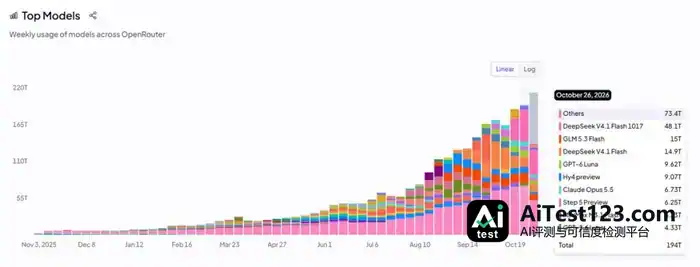
全球 AI 模型聚合平台 OpenRouter 公布了最新一周(10 月 26 日至 11 月 1 日)的排行:DeepSeek以 29.8% 的文本请求份额位居所有作者之首,环比上升 7%;OpenAI 以 18.8% 退到第二,Google 下滑最明显,从 14.4% 继续走低。Z.ai(智谱)以 11.9% 位列第四,通义千问以 5.6% 排在第六。

这一周,中国大模型的 token 调用量已连续第 27 周高于美国模型;单看模型,周调用量前五名中有四席是中国模型。
位列第一的DeepSeek,近期动作频频。
10月17日,线上主力模型被它升级为DeepSeek-V4.1-Flash-1017,API 的调用方式与价格均未调整,网页端和 APP 端则同步换到了新版本。再往前一个月,9月10日发布的 V4.1 Flash 属于这套新模型结构里尺寸最小的一档,原生支持多模态视觉理解,官方说法是"能力上限更高、推理速度更快、吞吐更大"。
在 OpenRouter 上,DeepSeekV4.1 Flash 近 30 天共消耗 114 万亿 token,比上一周期多了 95%;10月17日上线的 1017 版本更猛,单日 token 量已接近 6 万亿。
变化不只在模型层面。DeepSeek桌面智能体 Harness 于 8月13日发布,9月29日桌面端正式上线,官方最新给出的数据是日活 154 万、日均 token 用量 92 万亿。11月3日,DeepSeek网页和 API 出现过约 1 小时的部分中断,当天恢复。
有个反差挺明显:门罗风投统计的 "企业真金白银支出" 维度里,Kimi以 61% 的份额超过DeepSeek的 15%;可到了 OpenRouter 按实际请求量排的使用榜,DeepSeek 反超 Kimi排在最前,成了开发者调用最多的中国模型。
支出向 Kimi钱往一处集中,调用也往DeepSeek集中,掏钱的其实是同一批美国企业——既在为开源模型付费,也在给中国模型写代码。
这笔账还没算完。
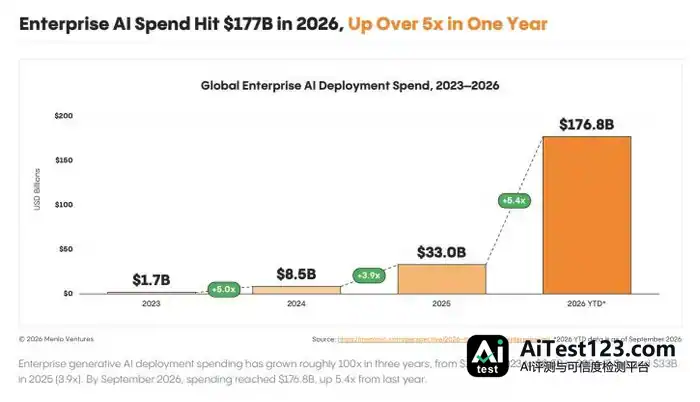
门罗风投的数据还显示,2026年美国企业 AI 部署支出已从去年的 330 亿美元涨到 1768 亿美元,一年翻了 5.4 倍;新增预算里有 55% 是净新增,并非从传统软件或人力预算中挪过来的。