硅谷华人团队开源Comma:单入口调度多Agent并行,解决上下文瓶颈

资讯 AI 应用前沿 全文 2798 字 · 约 7 分钟读完 配图 16 张 分类DeepSeek深度求索开源智能体Deepseek

DeepSeek提出Super-agent概念引发关注,而硅谷华人团队AFK AI早在半年前就推出了类似架构的产品Comma并开源。Comma采用“单Router+多Worker”模式,用户只需在一个对话窗口下达指令,系统即可自动调度多个独立上下文的Agent并行处理代码、文档等任务。它支持跨应用协作(如微信、Line

所属频道 智能体与 Agent开源生态

人类注意力正成为AI的瓶颈

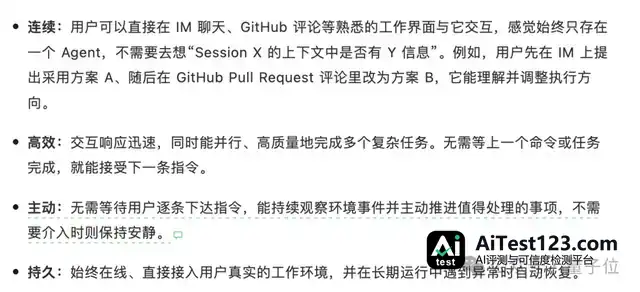
最近DeepSeek抛出的Super-agent理念,在技术圈搅起了不小的动静。其核心观点很直接:AI的并发能力早已把人类注意力的上限甩在身后。一个人同时盯三五个对话窗口就到顶了,AI却能同时跑成千上万个任务。人看不过来怎么办?让Agent去管Agent。
文章配图

这个思路听着顺理成章。不过很多人未必知道,在硅谷,华人团队AFK AI今年年初就把这套架构落成了产品,而且已经开源,产品名就叫Comma。
文章配图

两家团队做的并非简单功能重叠,而是各自对同一个底层困境给出了解法:单Session(会话)的限制怎么打破,让AI真正接管复杂工作流,而不是让人在无数聊天窗口之间来回折腾。
文章配图

单Router+多Worker:把“拉群”交给AI

文章配图

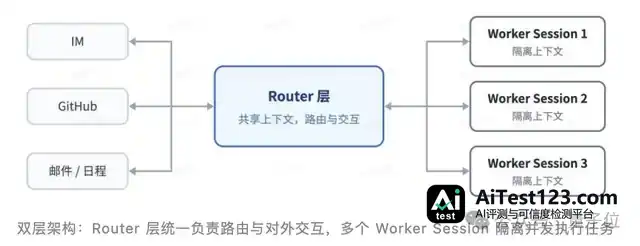
Comma的核心架构,概括起来就是“单Router+多Worker”。

文章配图

按传统用法,任务一换,往往就得新开一个聊天窗口,重新贴背景资料、设定角色。写代码、做周报、查资料三件事同时压过来,就得开三个窗口来回切,还得提防上下文搞混。
文章配图

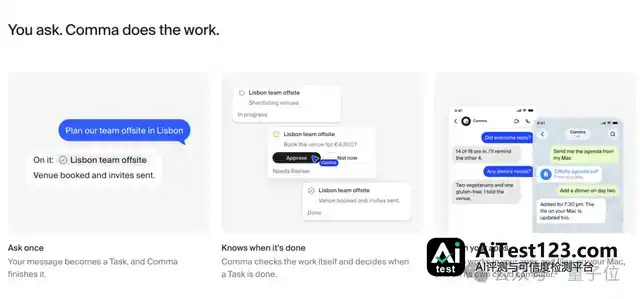
Comma换了个做法:用户只面对一个长期存在的“主对话”(Router)。一堆任务扔进去,Router先理解意图,再把具体活儿分派给后台多个独立的Worker。每个Worker各有各的上下文,互不干扰,并行干活。
文章配图

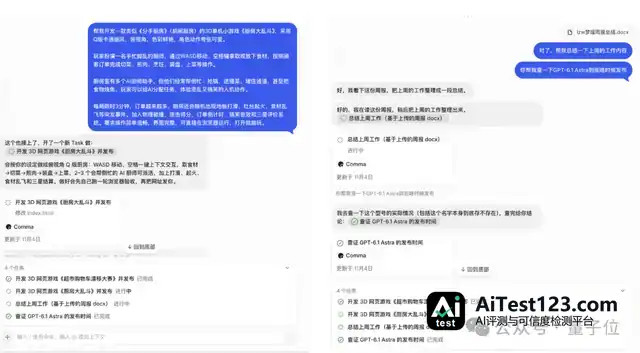
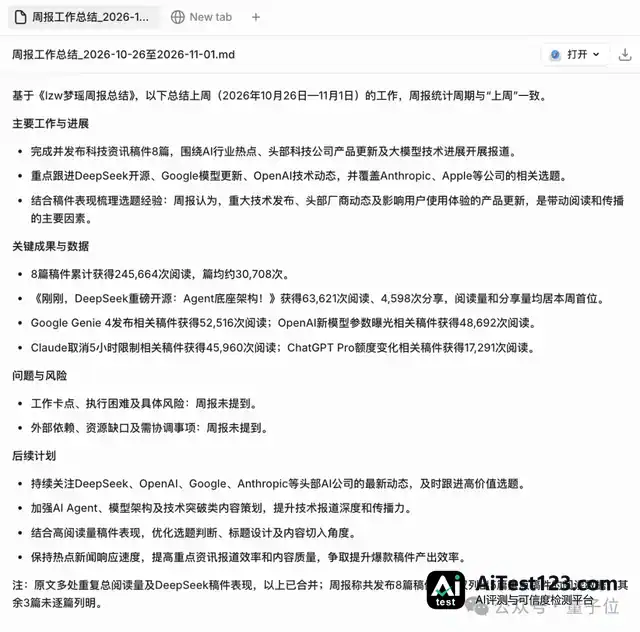
我实际测了一遍。手头当时有三件事:做一个类似《分手厨房》的简易网页游戏练手;整理本周工作复盘;梳理近期几个大模型的发布要点。
文章配图

换成普通AI工具,我得开三个标签页。在Comma里,我只在一个对话框把这三个需求一股脑发了出去。
文章配图

后台随即起了三个不同的Worker。十分钟后,游戏代码出来了,WASD移动、倒计时、抢锅机制还原得都不错;周报复盘把重点列得条理清晰;模型资讯也整理完了。全程我没中途切窗口,也没反复解释背景,只负责最后验收成果。
文章配图

体验上的变化在于,人跟AI的交互从“盯过程”转成了“管结果”。人类有限的注意力被释放出来,不再耗在任务调度和上下文维护上。
文章配图

跨环境协作:不只是在聊天框里干活

文章配图

Agent若只困在网页聊天框里,能发挥的作用终究有限。微信、Slack、GitHub、Linear,真实的工作流散落在这些工具之间。
文章配图

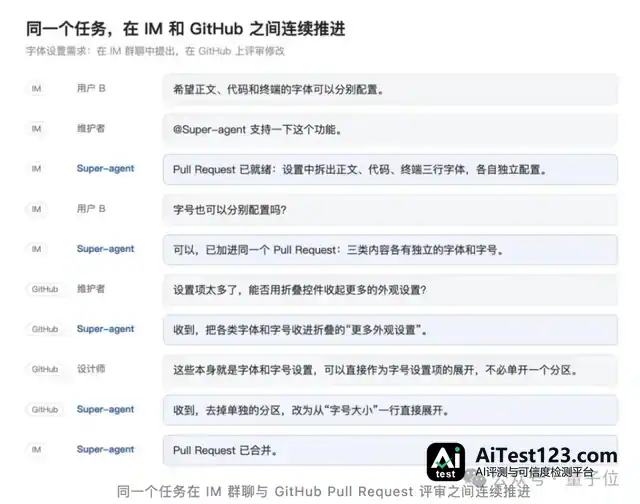
DeepSeek在Super-agent构想里提过“跨信道交互”,指的是Agent能盯群聊、能自动提PR。Comma靠自研的分布式运行框架Salix把这件事做了出来。
文章配图

微信、Signal、iMessage、Linear等第三方应用,Comma都能接进去。在微信里给Comma Bot发条指令,让它去Linear建个Issue,或者盯某个GitHub仓库的动静,都可以。
文章配图

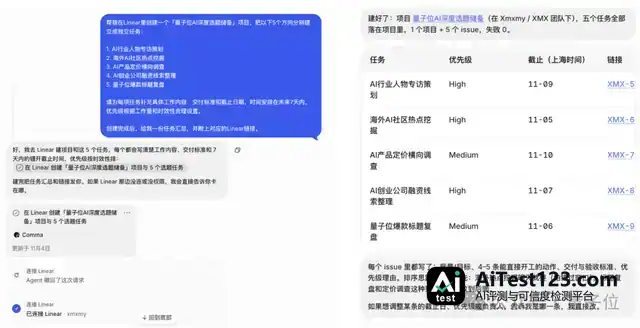
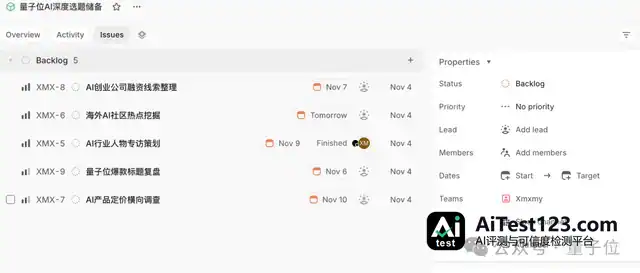
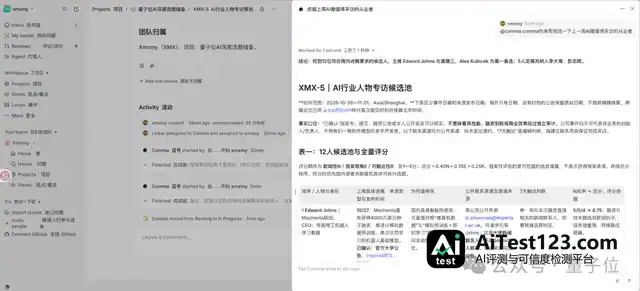
我试着把Comma接到Linear上。在Comma对话框里敲进项目需求,再切到Linear,Issue已经建好,还拆成了具体子任务。双向流动才是关键:我在Linear里改了任务状态,Comma同样能感知,主对话里随即同步进展。

这种跨环境“接力”,让Agent不再被锁在单一App里当孤岛。企业场景下,Comma还提供安全自部署和BYOK(自带密钥),用权限控制限定Agent访问本地工作环境的范围,数据不出域。

主动与持久:像贾维斯一样永远在线

“主动”和“持久”是Super-agent的另外两个特征,Comma在这两点上同样落了地。

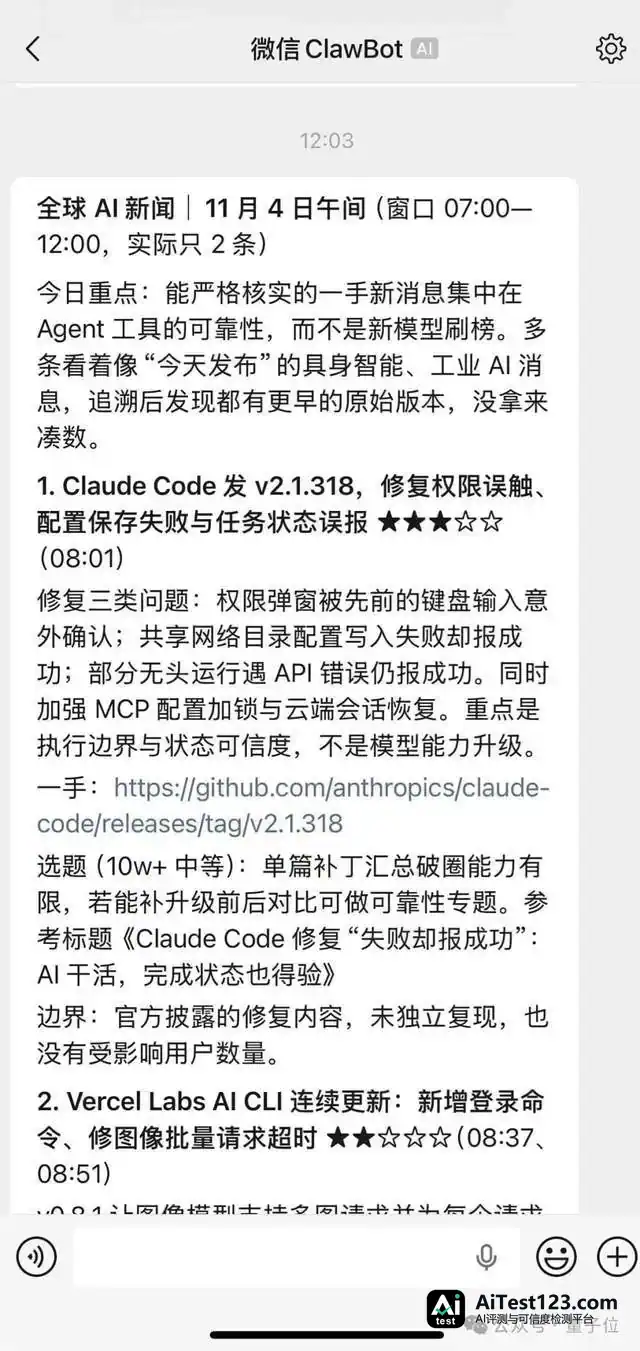
“持久”说的是用户不必时刻开着客户端。Comma支持24小时值守,大模型没有实时运行,系统照样在后台监听事件,该唤醒Agent时再唤醒。比如设一个长期任务:每天中午12点和晚上9点,自动搜最新AI新闻,整理成选题推到我的微信。

时间一到,消息自己送到,摘要和信源都在里面。不用每天追着问“今天有什么新闻”,Agent会把结果主动送上门。

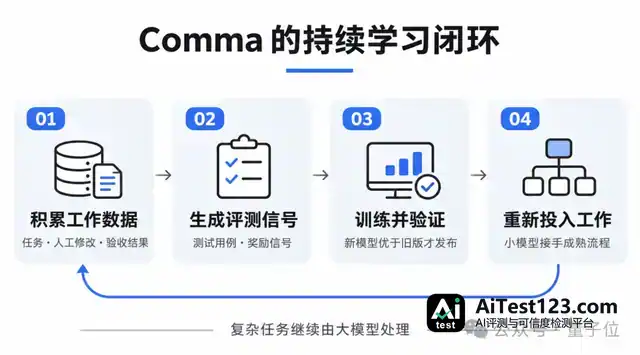
“主动”背后靠的是记忆系统。Comma把长期状态存在模型上下文之外,海量历史细节不会挤占主对话窗口。更进一步,它还有持续学习机制。

Agent的任务结果、人工修改、验收反馈,Comma都会记下来。这些数据变成训练信号,用来迭代专属小模型。新模型得在内部测试里赢过旧版本才能上岗。早期版本可能把退款请求误判成Bug,人工纠正之后,新版本就能正确认成账单问题。

这么一来,Agent用得越久经验越多,成熟的工作流逐步接手,复杂任务仍旧交给大模型。用团队的话说,就是“越干越聪明”。

从Bridge到Comma:半年的架构演进

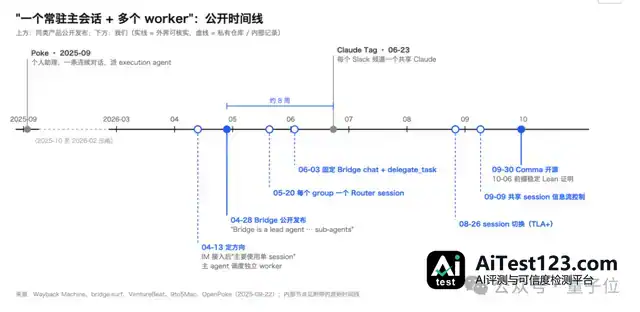
Comma不是一天做出来的。翻一遍AFK AI的时间线,演进路径很清楚。

2026年4月28日,团队公开了Comma的前身Bridge,Lead Agent(主Agent)与Subagents(子Agent)的架构当时已经提出。5月,定下“每个群组一个Router Session”的原则。6月,固定主对话与任务委派机制上线。

Comma把主对话机制完善好没多久,Anthropic就推出了理念相近的Claude Tag,允许Slack频道共享同一个Claude实例。行业头部玩家也在往同一个方向摸。

之后几个月,Comma先后推进Session切换能力、共享Session的信息流控制,9月30日正式开源,同时公开了基于Lean形式化验证的安全机制。

从单一主会话到多Worker协作,再到跨Session管理和安全控制,最初的架构设想变成可运行的产品,Comma花了近半年。

结语:Agent Harness的关键转向

DeepSeek和AFK AI想到了一块,这说明行业对Agent Harness(智能体编排)的期待正在转向。

早先大家盯的是任务吞吐量,即AI生成文本或代码能有多快。如今焦点挪到了责任承接和复杂事务管理上。用户要的不是打字更快的机器,而是一个能长期陪着、自主协调、跨平台干活的数字助理。

Comma的价值在于,它证明这套架构工程上可行,而且已经进入真实使用阶段。不是PPT上的概念演示,上下文诅咒、跨应用断点、记忆丢失这些具体痛点,它都碰到了。

局限当然也有。复杂逻辑的判断仍旧依赖大模型,小模型迭代需要足够多的反馈数据。但它给出了一个清晰样本:未来的Personal Agent该是永远在线、记忆连续、能主动管任务的系统,而不是一个个孤立的聊天窗口。

开发者能拿Comma的开源代码和Salix框架当参考实现。普通用户看到的是另一种可能:不用再手动切窗口、反复粘贴背景,人机协同的效率边界会被重新划一遍。

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. DeepSeek日活破百万,Agility上市与人形机器人商业化冷思考

    2026年11月AI圈动静不小:DeepSeek Harness日活达154万,Inkling 2 Small在ARC-AGI测试中拿到高分并计划开源。硬件方面,Agility Robotics成为美国首家人形机器人上市公司,但商业模式仍受质疑;中国移动千亿投入算力基建。与此同时,科技巨头的数据中心扩建在美国多地遭遇社

    来源 AI 应用前沿
  2. DeepSeek与GLM免费模型黑客能力逼近OpenAI,安全界为何警觉?

    据WIRED报道,一项模拟网络入侵实验显示,中国免费开放的AI模型DeepSeek与GLM在网络攻击技能上已逼近OpenAI最先进的网络安全模型,而后者并未公开。这一结果引发业界对开源模型“双刃剑”效应的担忧:能力越易获取,攻防之间的门槛就越模糊。

    来源 AI 行业观察
  3. 奇富科技开源ModelEvo 2.0:自动建模Agent新增自主搜索与经验复用

    【TechWeb】11月6日消息,尽日,奇富科技正式开源自动建模Agent ModelEvo 2.0。新版本面向结构化与表格数据,在标准化建模流程的基础上,进一步实现自主搜索、可信评估与跨任务经验积累复用。用户明确业务目标、提供建模样本与验证方案后,Agent可在给定预算内分析数据、规划实验并持续优化,对通过确认与交付

    来源 AI 行业观察
  4. DeepSeek Harness插件系统被吐槽 负责人承诺升级:一切都会好起来

    然而一切接插件的生态也导致了另一个严重的问题,那就是插件与DSH的兼容性,DSH官方源码页面上一直在提示会有破坏性更新,搞过DSH插件的开发者都很头痛这个问题,DSH版本一升级,插件不只是能不能用的问题,甚至可能搞得DSH崩溃,启动不了,这会影响工作。

    来源 凤凰科技
  5. 154万人玩出花,DeepSeek Harness长出3.5万插件

    出品 | 网易智能 作者 | 小扣 编辑 | 王凤枝 DeepSeek最近在鼓励用户给自己的AI加点新功能:工作里缺什么趁手工具,或者纯粹为了好玩、想把惦记已久的小点子变成真东西,都可以试着让AI帮忙做出来。 据团队披露,截至11月4日,在使用官方API的用户中,Harness日活跃用户已达154万;第三方插件约3.5

    来源 AI 行业观察
  6. 梁文锋与西蒙斯:从量化到DeepSeek的思想线索

    千亿量化之神,给梁文锋留下了哪些精神遗产?整理|《中国企业家》记者 孙欣见习编辑|李原头图来源|视觉中国2021年2月,一本名为《征服市场的人:西蒙斯传》的书在中国出版。为它写推荐序的人,是当时只在私募圈小有名气的幻方量化创始人梁文锋。没人想到,四年后,他会以DeepSeek创始人的身份震动世界——而他所撰写的题为《创

    来源 腾讯网
  7. 腾讯云ADP升级:企业级Agent如何对经营结果负责

    当 AI 从个人办公助手走向企业核心业务,单纯的工具搭建已无法满足需求。腾讯云 ADP 通过全生命周期升级与 FDE 交付方法论,解决跨系统打通、权限治理及规模化落地难题,让 Service Agent 真正嵌入业务流程,对华润信托、伊利等企业的实际经营指标负责。

    来源 AI 应用前沿
  8. Thinking Machines 二代模型用上 Kimi 数据,400亿估值背后藏了什么

    OpenAI前CTO创立的Thinking Machines Lab发布Inkling 2 Small,技术博客坦承采样自月之暗面Kimi K3。这款594B参数模型在长程任务上表现强劲,但编程能力仍落后于DeepSeek和Kimi旗舰版。文章解析其“为微调而生”的商业逻辑,以及中国开源模型如何成为硅谷巨头的数据源。

    来源 AI 应用前沿
  9. Ripple-65B Preview发布:65B稠密模型智能体编程超越更大规模对手

    IT之家 11 月 6 日消息,由前谷歌研究员创立的人工智能实验室 Ricursive Intelligence 当地时间本月 4 日发布了 Ripple-65B Preview,宣称其在美国开放权重模型中拥有最为出色的智能体编程表现。 Ricursive Intelligence 此前的工作专注于 AI 驱动的芯片设

    来源 AI 行业观察
  10. Harness Adapters:用安全强化学习提升智能体开发效率

    Hugging Face 团队发布了 Harness Adapters,这是一种基于 LoRA 的轻量级适配器,通过强化学习(RL)在 pi、opencode 和 hermes 等智能体框架中训练。核心创新在于引入 safeagents 代理,实时拦截并阻断模型试图“作弊”的工具调用,确保训练安全。实验显示,该方案能在

    来源 AI 应用前沿
  11. 申通快递联手千问办公:Agent能力下沉全国网点

    【TechWeb】11月6日消息,申通快递与千问办公正式达成战略合作。双方将围绕快递核心场景打造 AI 办公体系,以Agent能力支撑申通快递全国网点的增长战略落地,推动AI从总部管理向末端网点规模化输出,加速物流服务智能化升级。申通快递总裁韩永彦与千问办公CEO陈宇森等共同见证签约。 申通快递作为中国头部快递企业,拥

    来源 AI 行业观察
  12. DeepSeek与GLM免费开放,黑客能力逼近OpenAI未公开模型

    据WIRED报道,一项模拟网络入侵实验显示,中国免费开放的AI模型DeepSeek与GLM在网络攻击技能上已逼近OpenAI最先进的网络安全模型,而后者并未公开。这一结果引发业界对开源模型“双刃剑”效应的担忧:能力越易获取,攻防之间的门槛就越模糊。

    来源 AI 科技快讯
  13. 美国企业开源模型支出89%流向中国:Kimi占61%,DeepSeek占15%

    美国企业花在开源大模型上的钱,近九成都流进了中国公司的口袋。 11月3日,硅谷风投门罗风投(Menlo Ventures)发布的《2026年企业 AI 现状报告》把这笔账算得很明白。基于对近 400 名美国企业 AI 业务负责人的调研,报告给出一个刺眼的数字:美国企业花在开源大模型上的支出,89%付给了中国模型。 拆开

    来源 AI 行业观察
向下滚动自动加载更多