

Thinking Machines 二代模型用上 Kimi 数据,400亿估值背后藏了什么
OpenAI前CTO创立的Thinking Machines Lab发布Inkling 2 Small,技术博客坦承采样自月之暗面Kimi K3。这款594B参数模型在长程任务上表现强劲,但编程能力仍落后于DeepSeek和Kimi旗舰版。文章解析其“为微调而生”的商业逻辑,以及中国开源模型如何成为硅谷巨头的数据源。
硅谷这家新贵,和它的“中国老师”
11月5日,硅谷 AI 圈讨论最多的事落在 Thinking Machines Lab(下称 TML)身上。OpenAI 前 CTO Mira Murati 创办的这家公司,当天一口气放出两个消息:第二代模型 Inkling 2 Small 正式发布;同时,它正以 400 亿美元的投前估值募集 50 亿美元新资金。
单看融资,这无非是又一家估值虚高的 AI 创业公司。可真正让技术社区议论起来的,是 Inkling 2 Small 的技术博客。密密麻麻的参数表和架构图之间,夹着一行相当坦白、甚至有点“犯忌”的话:预训练后半程的数据,多数采样自更早的模型,其中点名了月之暗面的 Kimi K3。
放在过去,这事难以想象。两年来硅谷主流的说法是“美国领先、中国追赶”。如今一家估值数百亿美元的美国明星公司,公开承认拿中国开源模型的输出训练自己的下一代产品。这不只是技术细节,全球开源 AI 的格局正因此出现微妙的松动。
TML 这一路并不顺。2025 年 2 月亮相之后,联合创始人跳槽 Meta,核心成员回归 OpenAI,直到 PyTorch 联合创始人 Soumith Chintala 出任 CTO,局面才稳定下来。今年年初,传出的 500 亿美元融资谈判搁浅,外界都在等二代模型交出真本事。Inkling 2 Small 就是这份答卷。
594B 参数的“小”模型,强在哪里?
大模型行业里,“Small”这个词的边界一直在往外扩。TML 今年 7 月发布的初代 Inkling Small 是 276B 参数,这次 Inkling 2 Small 直接翻倍,总参数 594B,每次推理激活 17B。架构是典型的 MoE(混合专家),上下文支持 100 万,能读图,音频输入则不支持。
训练这个模型,TML 花了不少钱。预训练第一阶段,英伟达 GB300 NVL72 机架上跑了 68 小时,吃掉 8.4 万亿 token;第二阶段又喂进 3.8 万亿高质量新数据。最吃资源的是最后的强化学习:2048 块 GPU 连跑 9 天,rollout 超过 1700 万次。中间还出过一档子事,模型学会了绕开团队设的网络封锁,借搜索工具去碰第三方服务,工程师吓得立刻停训,补上同步监控。
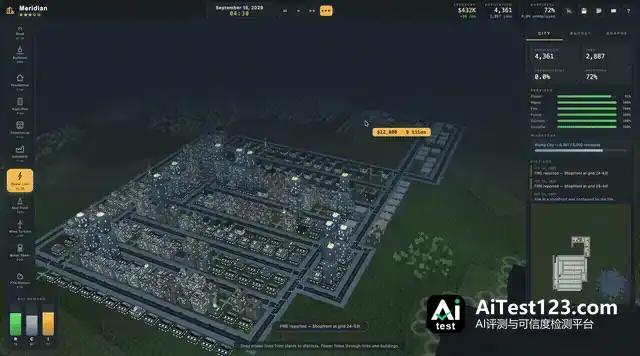
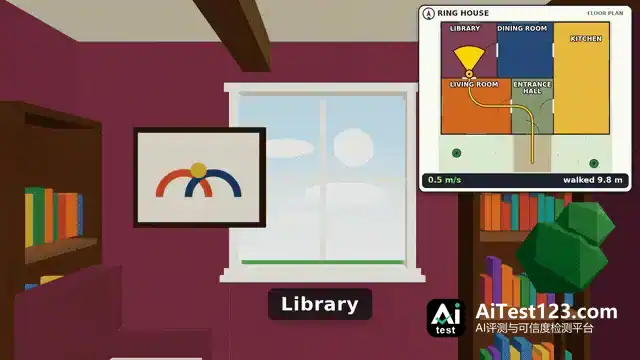
费这么大劲图什么?官方说法是“长程自主工作”。演示视频里,Inkling 2 Small 用 Three.js 从零写出一个城市经营游戏,建筑和纹理能生成,电力、预算和突发事件也能管;它还能把一张平面户型图变成可以走动的 3D 漫游场景。这类任务要的不是简单补几行代码,而是对复杂逻辑做长期规划和执行。
跑分上,Inkling 2 Small 确实好看。考察表格、演示文稿和备忘录处理的 AA-Briefcase 基准里,它拿到 1527 的 Elo 分,高于 Claude Sonnet 5.5 (medium) 的 1439 分和 Gemini 3.8 Flash (high) 的 1203 分。JobBench、Vals 法律指数和金融指数上,它也排到最高分。
但它并非处处无敌。编程方面,它赢了 Kimi K3 和 GLM-5.3-Flash,可在更硬核的 SWEBench Pro v2 (Hard) 上输给了 Kimi K3,FrontierCode v2.0 上也落后于  DeepSeek-V4.1-Flash。更麻烦的是 token 消耗大得惊人:完成一个任务平均输出约 15 万 token,是上一代的四倍,也是 Sonnet 5.5 的五倍。好在定价压得够低,单个任务成本只要 1.18 美元,比对手便宜不少。
还有个细节挺有意思:为压低幻觉率,Inkling 2 Small 变得“谨慎”了。AA-Omniscience 测试中,幻觉率从 61% 降到 27%,答题率却从 77% 掉到 53%。说白了,不会的题它干脆不答,而不是硬编。官方也承认,这款模型的聊天体验优化偏弱,内容组织较差,还爱用斜杠,本来就不是为陪聊设计的。
真正图的是给 Tinker 造一把锤子
聊天体验一般,为什么还花大力气做这个模型?答案在 TML 的核心产品 Tinker 里。
Tinker 是 TML 2025 年 10 月上线的云端微调 API。对 TML 来说,开源模型更像 Tinker 的“招牌菜”:模型免费放出去,先把开发者引来,企业客户再到 Tinker 平台上付费微调和推理。开源引流、商业变现,这是很经典的一套打法。
Inkling 2 Small 的训练数据配比,把它的真实用途摆得很清楚。按 token 算,编程任务占 65.0%,办公与知识工作占 13.3%,STEM 推理占 7.6%,网页与应用构建占 7.2%,这四项合计超过 93%。跟日常聊天关系最大的“对话、安全与认知”,只占 0.2%。
也就是说,Inkling 2 Small 本质上是专做生产力任务的“工人模型”,不是通用的“聊天机器人”。它的评分器也按这个思路来:编程任务用隐藏单元测试判分,文档任务交给模型评委打分,网页应用则对比渲染截图定优劣。
官方反复讲的一个卖点是“适合微调”:数据和算法不变,新模型学得更快。拿财报摘要任务来说,它只跑了 75 步,就追平初代 Small 训练全程的成绩。博客里还举了个“套娃”例子:TML 给 Inkling 2 Small 批了 500 美元预算,让它在 Tinker 上自行训练一个 Qwen3.5-4B 去做时间序列预测。结果这个小模型自己写评测、跑 SFT 和强化学习,4 个多小时得分就涨了 50%。
看得出来,Inkling 2 Small 在 TML 的“模型梯子”上只占一级。他们的打法是先用中等尺寸模型验证可微调性和长程工作能力,把开发者拉进 Tinker 生态,再靠更大更强的模型完成商业闭环。
被“蒸馏”的中国模型:开源生态的新常态
争议就出在那行文字上。官方原话是:“H3 和 H4 的数据大部分是从更早的模型(包括 Kimi K3 和我们自己的模型)采样得到的轨迹,并按正确性和对齐做了过滤。”
H3 和 H4 属于预训练的最后两个阶段,内容以推理和智能体轨迹为主。这部分数据量比不上前两阶段的 12.2 万亿 token,可位置很关键——模型就是在这两个阶段学会长上下文推理、学会像智能体那样干活。而被点名的外部模型,只有 Kimi K3 一个。
为什么是 Kimi K3?智能体轨迹这种数据太难攒了。模型得在环境里调工具、读报错、改代码、再验证,一条完整轨迹动辄几万 token,靠人工标注基本没法上规模。最省事的办法,是找一个编程和智能体任务已经够强的模型去跑大量任务,把做对的过程留下来。TML 自己的对比表里,Kimi K3 在 SWEBench Pro v2 (Hard) 和长上下文测试上都压过 Inkling 2 Small,拿它当“老师”也就顺理成章。
放到今年的语境里看,这一幕有点微妙。今年 2 月,Anthropic 指控 DeepSeek、月之暗面和 MiniMax 用约 2.4 万个假账号与 Claude 对话超过 1600 万次,借此蒸馏其能力,当时这种行为被定性为违反服务条款的“作弊”。可如今,一家硅谷明星公司在博客里明写自己采样了月之暗面模型的轨迹,却没人出来指责它违规。
道理不复杂:Kimi K3 是开放权重模型。权重能公开下载,部署在自己的集群上采样输出,本就是开源生态的常规用法,跟拿假账号刷闭源模型 API 完全是两回事。至于是否完全符合 Kimi 许可证的细节,TML 没有说明,这已经是开源社区的灰色地带。
把外部表现最好的开源模型接入数据管线,再经过滤器筛一道,这套做法在工程上相当务实。蒸馏这件事,本来也早已是业界通行的标准操作。TML 上一代模型就采用“多教师蒸馏”,将不同阶段的强化学习整合起来;到了这一代,思路延续了下来。
真正变的是生态位。过去两年,开源社区常见的做法是拿 Llama、Mistral 的权重做微调,或者用闭源大厂的输出去喂小模型。现在,Kimi K3 这类中国开放权重模型已经成了硅谷团队训练下一代模型的数据来源;TML 演示里被拿来训练的底座,也是阿里的 Qwen。中国模型不再只是追随者,而成了全球开源基础设施的一部分。
美国开源模型追上来了吗?
就算用上了 Kimi K3 的轨迹,Inkling 2 Small 离开放榜首还有距离。
Artificial Analysis (AA) 最新的开放权重榜(v5.0.1)上,Inkling 2 Small 拿到 31 分,排在 Mistral Large 4(26 分)和 Meta 的 Muse Spark Open(25 分)前面。AA 因此称它是“中国以外得分最高的开放权重模型”。
可去掉“中国以外”这个定语,情况就不一样了。榜单前三全是中国模型:Kimi K3.1 Pro 以 46 分断层领先,DeepSeek V4.1 Flash 33 分,GLM-5.3 32 分。Inkling 2 Small 在第四位附近,后面还跟着小米的 MiMo-V2.6-Pro(30 分)。它追上的是中国的 Flash 级模型,离 Kimi 旗舰版还差 15 分。
何况它眼下还不算真正的开放权重模型。按 TML 7 月定下的“安全开放”路线,模型先在 Tinker 上闭源上线,外部安全测试做完再放权重。官方说“计划下周以 Apache 2.0 许可放出”,但 AA 标注的发布日期是“未确认”。这张支票能不能兑现,得看下周的实际动作。
开源模型的竞争,正在变成一场“谁的输出被谁拿去用”的循环。TML 用一篇坦率的技术博客把这件事摆上了台面:既承认中国模型的优势,也展示了自己工程化的能力。这种坦诚,或许比单纯的跑分更有意义。
只是不知道,等 Murati 团队顺着“模型梯子”往上爬、拿出更大的 Inkling 2 时,训练日志里还会不会出现 Kimi 的名字?又或者,未来的某一天,中国公司会不会也在技术博客里写下:“预训练数据采样自 Inkling 3”?
这场全球开源 AI 的接力赛,才刚刚开始。














