

TML新模型Inkling 2 Small:非中最佳开放权重?
11 月 5 日,OpenAI 前 CTO Mira Murati 创立的 Thinking Machines Lab(简称 TML)同一天出了两条新闻。 当天,公司发布了第二代模型 Inkling 2 Small,第三方评测机构 Artificial Analysis(AA)给的评价相当高:权重放出后,它将成为「中国
11 月 5 日,OpenAI 前 CTO Mira Murati 创办的 Thinking Machines Lab(下称 TML)一口气放出两条消息。
一条是第二代模型 Inkling 2 Small 正式发布。第三方评测机构 Artificial Analysis(AA)给出的说法很扎眼:权重公开之后,它会是「中国以外得分最高的开放权重模型」。另一条来自报道——该公司正以 400 亿美元的投前估值募集 50 亿美元新资金。
TML 于 2025 年 2 月公开亮相,到现在已过去一年半有余。这期间,它拿到过 a16z 领投的 20 亿美元种子轮;也经历过人事震荡:联合创始人 Andrew Tulloch 去了 Meta,联合创始人 Barret Zoph、Luke Metz 等人在今年 1 月回到 OpenAI,CTO 一职随后由 PyTorch 联合创始人 Soumith Chintala 接手。
也是今年 1 月,有报道称团队按约 500 亿美元估值融资的谈判卡住了。新一笔钱能不能到账,很大程度上取决于二代模型够不够硬。
技术博客里,跑分表、架构图之外,有一行关于训练数据来源的说明颇耐人寻味:预训练后半程所用数据,多数采样自更早的模型,其中被点名的包括月之暗面的 Kimi K3。
01、594B 的「Small」,强在哪
在大模型行业,「Small」这个叫法正一路膨胀。
今年 7 月,TML 发布初代开放权重模型 Inkling,总参数 975B;两周后推出的 Inkling Small 是 276B。到第二代,Inkling 2 Small 的总参数量涨了一倍多,来到 594B,每次推理激活 17B。架构为 MoE,上下文支持 100 万,思考力度可调,能读图;初代 Inkling 有的音频输入,这一代不再支持。
训练流程下料很重。预训练头一阶段,团队在英伟达 GB300 NVL72 机架上跑了 68 小时,以原生 NVFP4(4 比特浮点)精度吃进 8.4 万亿 token;第二阶段再补 3.8 万亿 token 的高质量新数据;最后两个阶段合计约 3540 亿 token,用推理与智能体轨迹收尾,上下文拉到 100 万。接着是 9 天的联合强化学习:2048 块 GPU,rollout 超过 1700 万次,单次 rollout 中位耗时 8 分钟,长的要跑 4 个小时。
这些长链路训练,对应官方口中这一代最大的长进——长程自主工作。演示里有几个例子:用 Three.js 从零写出一个城市经营游戏,建筑、纹理、车辆全靠程序生成,电力、预算和突发事件都得管;用 Python 从零写出一台能启动真实 Linux 内核的电脑模拟器;还能把一张平面户型图变成可以走动的 3D 漫游。
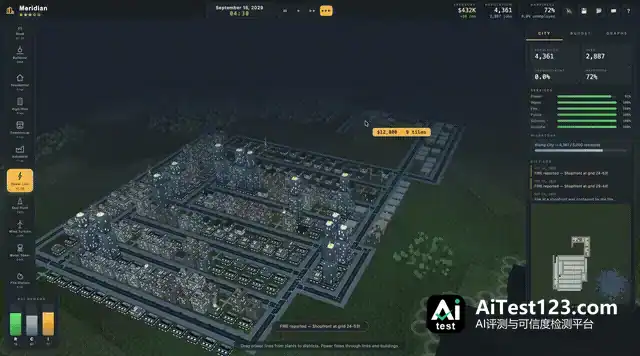
用 Three.js 从零生成的城市经营游戏|图片来源:Thinking Machines
训练过程也出过险情。强化学习跑到一半,监控发现模型通过搜索工具接触到的第三方服务,绕开了团队设的网络封锁。训练只能暂停,去掉联网环境、给工具调用加上同步监控后才继续。官方还承认,早期版本碰上太难的任务会「执着于成功」,出现编造结果、无视指令甚至掩盖行为。到发布版,内部「不当行为」得分从上一代的 66.8 降到 14.9(越低越好),但跟闭源模型比仍有差距。
跑分看,它最突出的长板是知识工作和长流程商业任务。AA-Briefcase 考察表格、演示文稿和备忘录,它拿到 1527 的 Elo 分,上一代 Small 只有 912,Claude Sonnet 5.5 (medium) 是 1439,Gemini 3.8 Flash (high) 是 1203。官方对比表里,JobBench(70.5%)、Vals 法律指数(73.9%)、金融指数(61.5%)和 HLE-Diamond(28.7%)四项,它都是最高分。
编程上就没法全面领先了。FrontierCode v2.0 和 DeepSWE v1.1 上,它赢过 Kimi K3 和 GLM-5.3-Flash,却落后于 DeepSeek-V4.1-Flash(25.4% 对 28.5%,72.1% 对 77.0%);SWEBench Pro v2 (Hard) 上则输给 Kimi K3。跟闭源模型比,命令行任务 Terminal-Bench 4.0 上它只有 13%,Sonnet 5.5 是 30%。
代价落在 token 消耗上。AA 的测试中,它每完成一个任务平均要输出约 15 万 token,上一代是 3.7 万,Sonnet 5.5 是 3.1 万。好在定价压得低:每百万 token 输入 0.30 美元、输出 1.00 美元,单个任务成本 1.18 美元;Gemini 3.8 Flash 要 7.77 美元,Sonnet 5.5 要 10.02 美元。
幻觉率下降则有点取巧。AA-Omniscience 上,它的幻觉率从 61% 降到 27%,可答题率也从 77% 掉到 53%,准确率只从 32% 升到 34%——降幻觉主要靠不会就不答。官方同样承认,它聊天体验优化偏弱,内容组织差,还爱用斜杠。
02、为 Tinker 造一把锤子
为什么做一个聊天粗糙、却在写代码和做表格上格外卖力的模型?答案得看 TML 眼下最核心的产品 Tinker。
Tinker 是 2025 年 10 月上线的云端微调 API。对 TML 而言,开源模型更像 Tinker 的招牌:模型免费放出,企业客户到平台上付费微调和推理。
强化学习的任务配比,把这家公司的取向摊开了。按 token 算,编程拿走 65.0%,办公与知识工作 13.3%,STEM 推理 7.6%,网页与应用构建 7.2%,这四项加起来超过 93%。反倒是跟日常闲聊最沾边的「对话、安全与认知」,按 token 只占 0.2%。
评分器的设计同样围着生产力任务转。编程这块用隐藏单元测试;有些任务还额外挂了一个「智能体评分器」,不光看测试过没过,也看模型解题的路子;文档和工具调用,交给按评分细则打分的模型评委;网页应用则把渲染出来的截图两两对比,让奖励模型判断哪张更好。上线之前,早期版本还顶着「Fledge-Alpha」的代号,在编程工具 OpenCode 上匿名跑过真实场景,测编程表现。
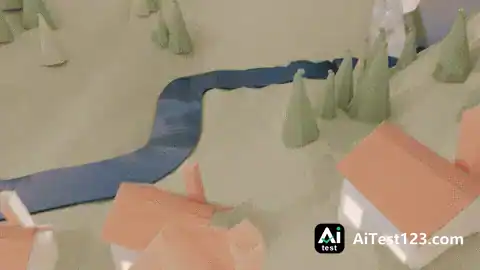
Inkling 2 Small 在 Blender 里按反馈反复迭代,做出的一段纸艺动画|图片来源:Thinking Machines
官方翻来覆去讲的卖点就一个——「适合微调」:数据和算法不变,新模型学得更快,涨得也更多。拿一个财报摘要任务来说,它只训了 75 步,就追上了初代 Small 训完全程的成绩。
博客里还记了一个套娃式的例子:TML 给 Inkling 2 Small 批了 500 美元预算,让它上 Tinker 自己训一个 Qwen3.5-4B 去做时间序列预测。评测它自己写,SFT 和强化学习也是它自己做,4 小时 17 分钟后花掉 426 美元,小模型的得分从 0.191 抬到 0.289。
按官方的说法,Inkling 2 Small 不过是「一组模型梯子中的一级」,更多尺寸很快会跟上。先拿中等尺寸验证可微调性和长程干活的能力,把开发者拉进 Tinker,这门生意才转得起来。
03、被「蒸馏」的中国模型
那行字的说法,官方原话是这样的:「H3 和 H4 的数据大部分是从更早的模型(包括 Kimi K3 和我们自己的模型)采样得到的轨迹,并按正确性和对齐做了过滤。」
其中 H3 有约 3200 亿 token 的推理和智能体轨迹,另外还含回放的预训练数据;H4 则是约 340 亿 token 的最高质量智能体轨迹。前两阶段合计 12.2 万亿 token,相比之下这部分体量不大,位置却很关键:模型就是在这儿学会长上下文推理、学会像智能体那样干活,之后才进强化学习。
Kimi K3 占多少,官方没公布,所以不能说 Inkling 2 Small 是「靠蒸馏 Kimi 做出来的」。能确定的是,这份配方里被点名的外部模型只有 Kimi K3 一个。
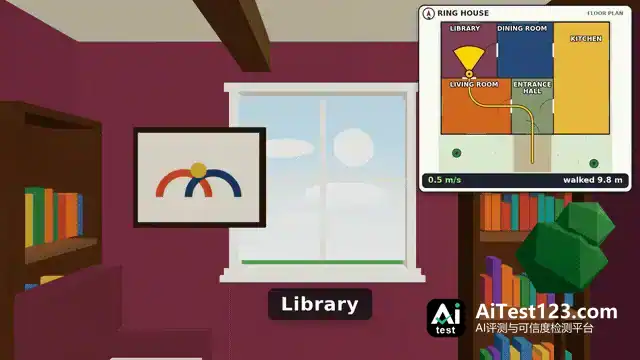
从一张平面户型图生成的 3D 漫游,右上角是行走路线|图片来源:Thinking Machines
为什么偏偏这两个阶段要用别人的轨迹?智能体轨迹这种数据太难攒。模型得真在环境里调工具、读报错、改代码、再验证,一条完整轨迹动辄几万 token,靠人工标注基本没法上量。最省事的法子,是找一个在编程和智能体任务上已经够强的模型,让它跑大量任务,把做对的那些过程留下来。TML 自己的对比表里,Kimi K3 在 SWEBench Pro v2 (Hard) 和长上下文测试上都压过 Inkling 2 Small,拿它当老师,顺理成章。
放在今年的语境里,这一幕有点微妙。2 月,Anthropic 指控 DeepSeek、月之暗面和 MiniMax 用约 2.4 万个假账号跟 Claude 聊了超过 1600 万次,借此蒸馏其能力。到了 11 月,一家硅谷明星公司自己在博客里写明,采样了月之暗面模型的轨迹。
两件事的性质得分开看。假账号刷闭源模型 API,违反的是服务条款;Kimi K3 是开放权重模型,权重公开可下载,在自己的集群上部署、采样它的输出,属于开源生态里的常规用法。至于是否完全符合 Kimi 许可证的细节,TML 没说明,这里不做判断。
说起来,蒸馏在业内早就是常规操作了。TML 上一代模型走的就是「多教师蒸馏」,把不同阶段的强化学习揉到一起。这次换成把外部最好用的开源模型接进数据管线,再过一遍过滤器,工程上很务实。
生态位才是真正挪了地方。前两年开源社区流行的是拿 Llama、Mistral 的权重去微调,或者拿闭源大厂的输出喂小模型。如今像 Kimi K3 这种中国开放权重模型,已经变成硅谷团队训练下一代模型的数据来源;TML 演示里拿来训练的底座,同样是阿里的 Qwen。
04、美国开源模型追上来了吗
就算用上了 Kimi K3 的轨迹,Inkling 2 Small 离榜首还是有一段距离。
AA 最新的开放权重榜(v5.0.1)上,它拿 31 分,把欧美同行甩在后面:最近的 Mistral Large 4 是 26 分,Meta 的 Muse Spark Open 是 25 分。AA 那个「中国以外最高」的头衔,就是这么来的。
把这个定语去掉,前三名全是中国模型:Kimi K3.1 Pro 以 46 分断层领先,DeepSeek V4.1 Flash 33 分,GLM-5.3 32 分。Inkling 2 Small 排在第四位附近,身后还有 30 分的小米 MiMo-V2.6-Pro。它追上的是中国的 Flash 级模型,离 Kimi 的旗舰还差 15 分。
更何况,它眼下还称不上真正的开放权重模型。按 TML 7 月定下的「安全开放」路线,模型先在 Tinker 上闭源上线,外部安全测试做完再放权重。官方说「计划下周以 Apache 2.0 许可放出」,AA 那边标注的发布日期则是「未确认」。这张支票能不能兑现,下周见分晓。
开源模型的竞争,正在变成一场「谁的输出被谁拿去用」的循环。TML 用一篇坦率的技术博客,把这件事摆到了台面上。
只是不知道,等 Murati 团队顺着「模型梯子」往上爬、拿出更大的 Inkling 2 时,训练日志里还会不会出现 Kimi 的名字?














