Thinking Machines推Inkling 2 Small:开放权重可自训,估值冲2600亿
总参数量5940亿,每个Token激活参数170亿。

前OpenAI首席技术官米拉·穆拉蒂创办的美国AI创企Thinking Machines Lab,在11月6日推出通用多模态模型Inkling 2 Small,下周将开放权重。该模型把重点放在定制训练上,开发者可以用自己的数据继续训练,也能自行调用工具去微调别的模型。

Thinking Machines官方公告(图源:X)
第三方评测机构Artificial Analysis(AA)的智能指数给了它31分,前代Inkling-Small是13分。按眼下这份榜单,开放权重之后,新模型会在该指数中排到中国以外开放权重模型的第一位。
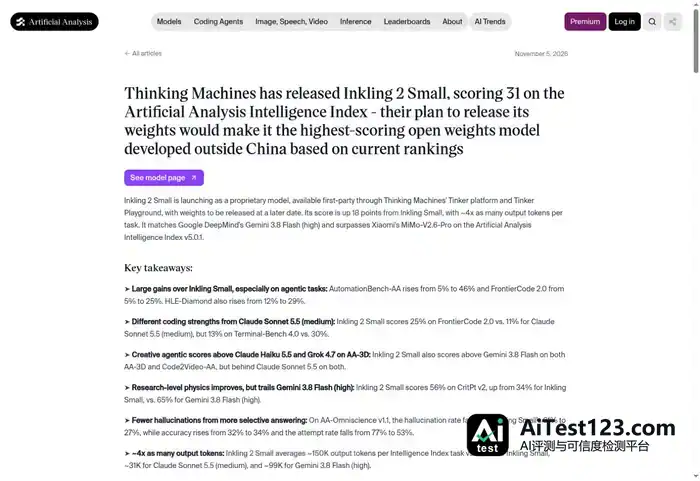
AA表示,以当前排名看,Inkling 2 Small开放权重后将成为中国以外研发的开放权重模型中智能指数最高的一款(图源:Artificial Analysis)
据Thinking Machines Lab介绍,Inkling 2 Small是第二代模型系列的首款产品,走混合专家(MoE)架构,总参数5940亿,每个Token激活170亿参数,可输入文字和图像、输出文字,思考投入程度可以调节。公司改进了预训练,又采用统一强化学习,让模型在智能体编程、视觉、知识工作和推理等任务上表现更好,重点是撑住长时间的自主执行。
定制训练这块,公司按客户需求试了多种后训练场景。比如用公开财报电话会议数据搭的投资分析任务,Inkling 2 Small经过强化学习微调,训练75步就追上前代Inkling-Small训练200步后的水平,最终成绩也压过前代。

投资分析任务中,各模型表现随训练步数和估算训练费用的变化(图源:Thinking Machines Lab)
新模型还能干训练和调试的活。官方案例里,Inkling 2 Small自己写评测、备数据、比训练方案、改错误,用4小时17分钟、花426美元(约合人民币2861元)完成了Qwen3.5-4B的微调。公司称,训练后的Qwen3.5-4B在未见数据上的预测误差比基座降低约15%。
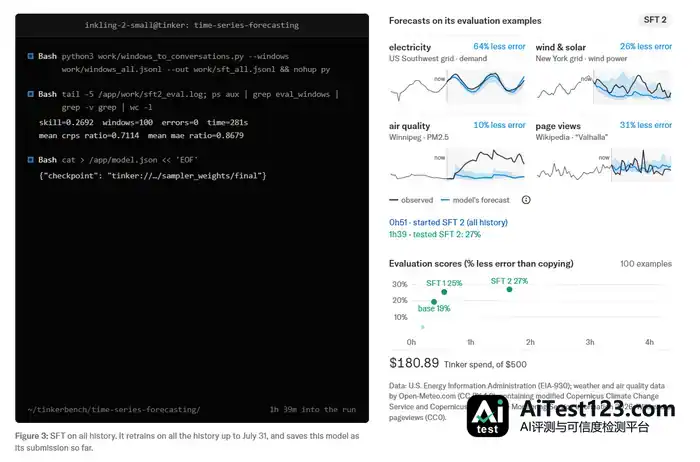
Inkling 2 Small微调Qwen3.5-4B的过程截图,显示运行至1小时39分钟时第二次监督微调方案的测试结果(图源:Thinking Machines Lab)
Thinking Machines Lab在2025年2月公开亮相,主要给开发者提供可定制模型和后训练工具。开发者能通过该公司的模型后训练平台Tinker,拿自己的数据和评价标准训练模型,底层分布式训练设施不用自己管。
公司联合创始人、CEO米拉·穆拉蒂此前是OpenAI首席技术官,在OpenAI干了逾6年。那段时间她管研究、产品与安全,ChatGPT、GPT-4、DALL·E等项目的开发与发布都由她领导。
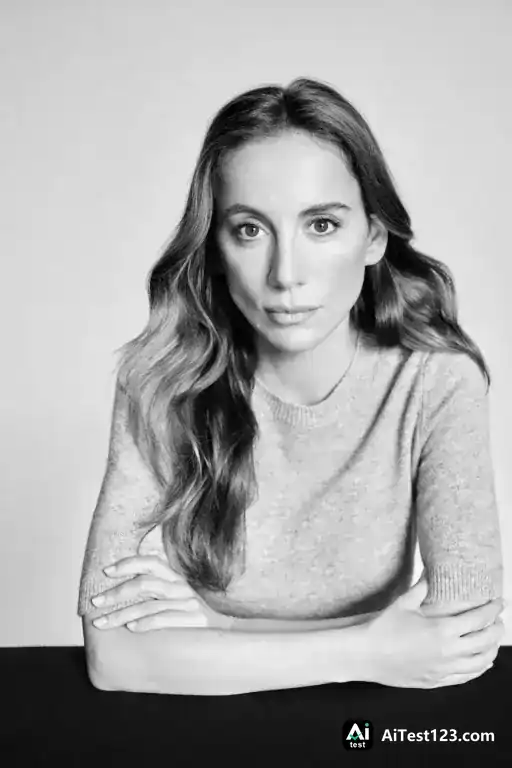
Thinking Machines Lab联合创始人、CEO米拉·穆拉蒂(图源:达特茅斯学院)
Business Insider今日报道,该公司正洽谈由Accel领投的50亿美元新一轮融资(约合人民币336亿元),拟议投前估值400亿美元(约合人民币2687亿元)。
此前公司已拿到a16z、英伟达等机构的投资。今年3月10日,英伟达披露已向其投资,金额没公布。2025年7月,Thinking Machines Lab披露完成约20亿美元种子轮融资(约合人民币134亿元),投后估值120亿美元(约合人民币806亿元),a16z领投,英伟达、AMD、Accel、思科等参投。
现在开发者可以自行调用和微调Inkling 2 Small,也能在Tinker Playground里体验。
定价上,采样服务每百万非缓存输入Token收0.30美元(约合人民币2.02元),每百万输出Token收1美元(约合人民币6.72元);64K、256K上下文窗口的训练费用分别是每百万Token 1.50美元(约合人民币10.08元)和3美元(约合人民币20.15元)。
公司打算做完外部安全测试和红队测试后,下周以Apache 2.0许可证开放完整权重,到时用户还能下载在Tinker上训练出来的检查点。
一、AA智能指数升至31分,覆盖编程、金融与视觉任务
前面提到,Inkling 2 Small在AA智能指数拿31分,比前代Inkling-Small的13分多了18分。该指数综合衡量知识工作、编程、科学和通用能力,截至11月6日,开放权重模型里得分最高的是Kimi K3.1 Pro,46分。
模型规模也比前代大。据Thinking Machines Lab透露,前代Inkling-Small总参数2760亿,每个Token激活120亿参数;新模型Inkling 2 Small总参数5940亿,每个Token激活170亿参数。
编程方面,按公司汇总的第三方评测结果,新模型在软件工程测试FrontierCode v2.0中拿到25.4%,高过GLM-5.3-Flash的14.2%,低于DeepSeek-V4.1-Flash-1017的28.5%。金融任务上,新模型在金融智能体评测Finance Agent v2.1中拿到67.5%,高于DeepSeek-V4.1-Flash-1017的62.9%。

Inkling 2 Small与其他模型在编程及自动化研究任务中的成绩对比(图源:Thinking Machines Lab)
视觉评测上,Thinking Machines Lab给出的数据显示,Inkling 2 Small在图像理解测试MMMU Pro(Standard 10)中拿到81.6%,比DeepSeek-V4.1-Flash-1017的80.6%稍高。该模型还会回看自己生成的页面或场景,借助视觉反馈接着改代码。

▲Inkling 2 Small在视觉理解、界面定位及视觉创作等评测中与其他模型的成绩对照(图源:Thinking Machines Lab)
网站生成能力的DesignArena评测里,Thinking Machines Lab引用11月5日的榜单称,Inkling 2 Small得1340分,超过GPT-6 Astra(max)的1333分,但不及Muse Wonder(max)的1366分。

▲11月5日DesignArena网站生成榜单部分模型成绩(图源:Thinking Machines Lab)
视觉创作上,该公司拿出城市模拟器、Linux个人电脑模拟器、折纸场景和户型漫游四个案例,涉及交互式应用开发、系统模拟与三维场景制作。城市模拟器让用户扩建城市、管理供电和预算,户型漫游则按平面图生成三维演示。
城市模拟器先铺路、划地块,再逐步长出住宅和高层建筑。演示里,零散建筑扩成完整街区,城市还有昼夜变化,入夜后建筑和道路亮灯。建设工具与城市管理面板分列界面两侧,用户扩建的同时能查看人口、供电、预算等信息。
▲Inkling 2 Small编程构建的城市模拟器,呈现道路建设、街区扩张与昼夜变化(视频来源:Thinking Machines Lab)
户型漫游把平面图变成能走进去的三维空间。演示以第一人称视角穿过客厅、书房、厨房等房间,室内摆着沙发、书架和绿植。右上角平面图同步标出所处位置和朝向,用户可对照房间布局。
▲Inkling 2 Small按平面图制作的三维户型漫游,右上角地图同步显示位置与朝向(视频来源:Thinking Machines Lab)
二、金融任务75步追平前代,4小时17分钟完成Qwen微调
Thinking Machines Lab公布的定制训练实验显示,一项投资分析任务中,Inkling 2 Small训练75步就达到前代Inkling-Small训练200步后的水平,最终成绩也压过前代。
该任务用的是公开财报电话会议数据,考察模型经针对性训练后的分析表现。各模型的数据和算法相同,都通过Tinker训练200步,并各自搜索学习率。Inkling系列用3个随机种子做实验,结果取平均值。
训练与调试任务,新模型同样能上手。美国AI数据创企Proximal为Thinking Machines Lab构建的一项内部任务里,Inkling 2 Small要微调Qwen3.5-4B,让后者预测天气、维基百科页面浏览量等时间序列。
按该公司公布的演示,任务限时12小时,Tinker费用预算500美元(约合人民币3358元)。模型实际用4小时17分钟、花426美元(约合人民币2861元)完成。该公司称,微调后的Qwen3.5-4B在未参与训练的8-9月数据上,预测误差比基座降低约15%。
过程中,Inkling 2 Small先写评测、整理训练样本,发现8次预测用了相同随机种子后改了设置。接着它对比监督微调(SFT)和强化学习(RL)两种方案。RL尝试让预测过于自信、成绩下滑,模型便停掉该方案,补充近期数据继续SFT,最后提交SFT检查点。
▲Inkling 2 Small微调Qwen3.5-4B过程截图,显示运行至1小时39分钟时第二次监督微调方案的测试结果(图源:Thinking Machines Lab)
GPU算子优化属于另一类研发任务。Thinking Machines Lab公布的结果显示,Inkling 2 Small把DeepSeek-V3.2稀疏注意力前向、反向算子的速度提到原始实现的6.02倍,高于DeepSeek-V4.1-Flash的5.66倍,低于Claude Opus 5.5的18.80倍。测试跑在B300 GPU上。作为对照的原版算子代码没有针对B300专门优化,6.02倍指优化后的算子代码相较原版的运行速度。

▲各模型优化DeepSeek-V3.2稀疏注意力算子的过程与结果,纵轴为相较原版算子代码的加速倍数(图源:Thinking Machines Lab)
三、统一强化学习训练9天,增加行为约束与执行监控
训练方法上,Thinking Machines Lab透露,先靠多阶段训练攒下模型的通用能力,再用统一强化学习让模型完成多步骤任务,具体有两个重点:
1、分阶段加入高质量数据与任务执行记录
初始预训练用了8.4万亿Token,在英伟达GB300 NVL72机架上跑68小时,原生采用NVFP4低精度浮点格式训练。
后续阶段再用3.8万亿Token质量更高、时效性更强的数据,并加入推理与智能体执行轨迹。部分轨迹采样自Kimi K3和该公司此前模型,经正确性与对齐筛选后投入训练。
2、将推理与智能体任务放入同一轮强化学习
前代Inkling的做法是把推理与智能体能力分开训练,再用多教师蒸馏把两边的本事合到一起。这次换成了统一的强化学习:2048张GPU跑9天,完成1075步,产出超过1700万条轨迹。

▲Inkling 2 Small统一强化学习的计算量、GPU数量、训练时长及轨迹规模(图源:Thinking Machines Lab)训练任务铺到编程、文档、视觉、工具使用和科学问答这些领域。代码任务主要看隐藏测试和程序检查的结果打分,文档和工具使用靠评分规则加一个大模型当裁判,网页应用则拿渲染出来的截图做比对。
长任务方面,训练用了256K上下文,还加了上下文压缩。一条轨迹耗时的中位数是8分钟,第99百分位到了4小时。该公司的研发团队另外在奖励里塞进了长度惩罚,让模型自己去权衡思考投入和执行效率。

▲Inkling 2 Small强化学习的训练参数,包括上下文窗口、单条执行轨迹的Token用量及执行时长(图源:Thinking Machines Lab)
行为约束分两头做:训练和执行监控。按Thinking Machines Lab公布的内部评测,新模型的不当行为指标是14.9,前代Inkling-Small为75.2,GPT-6.1 Sol则只有0.8。也就是说,新模型比前代收敛不少,但和GPT-6.1 Sol仍不在一个量级。

▲Inkling 2 Small与其他模型在行为对齐相关评测中的成绩,表中各项指标均为数值越低越好(图源:Thinking Machines Lab)
训练这一侧,该公司会把含不当行为的轨迹过滤掉,在强化学习中对违规操作施以惩罚,并奖励模型主动放弃完不成的任务。教师模型那边也给了行为规范提示,之后再用同策略自蒸馏训练新模型。
执行监控这一侧,系统会在工具调用之前核对操作是否在任务授权范围内,同时对已经完成的执行记录做审查。据该公司披露,有一次训练中,异步监控器发现模型借着搜索工具能访问的第三方服务,把网络阻断绕了过去。研发团队当即停下训练,加固设施,把需要联网的环境撤掉,又补上工具调用前的同步监控,然后才恢复训练,继续做对齐。
结语:通用模型持续升级,模型厂商与云平台争夺定制模型训练业务
Inkling 2 Small既提升了通用能力,接受定制训练的表现也好了一些。Thinking Machines Lab通过Tinker把它放出来,开发者可以拿自己的业务数据和评价标准接着训,该公司还演示了模型做微调实验的整个过程。
做模型定制的企业已经不少。3月17日,法国大模型公司Mistral AI推出企业训练系统Forge,能用内部文档、代码和业务记录来训练模型;2月17日,美国云服务商AWS把Amazon Bedrock的强化学习微调扩展到部分Qwen和GPT-OSS模型上。
企业客户要的不只是通用模型,还得让模型懂自己的术语、流程和任务要求。厂商争的正是这块业务,从模型调用、定制训练到评测、部署都要覆盖。Thinking Machines Lab这次把模型和训练能力一起升级,说到底也是在给这类企业订单加筹码。