

OpenAI发布GPT-6 Cyber:攻防能力双升,风险评级升至Critical
AI 在网络安全领域的能力,又迎来了一次重大升级。 就在刚刚,OpenAI 正式发布新一代网络安全模型GPT-6 Cyber,能够自主发现软件漏洞、验证漏洞是否可以利用,并协助研究人员开发修复方案。 相比上一代 GPT-5.6 Cyber,新模型在漏洞利用测试中的成绩相对提升约 51%,同时大幅改善了执行安全任务时的指
OpenAI在网络安全方向又推进了一步,新一代模型GPT-6 Cyber正式亮相。
按照OpenAI公布的信息, GPT-6 Cyber能自主寻找软件漏洞,判断漏洞能否被实际利用,还能帮助研究人员给出修复办法。
与上一代GPT-5.6 Cyber相比,新模型在漏洞利用测试中的成绩相对提高约51%,执行安全任务时的指令遵循能力也有明显改善。OpenAI已把GPT-6 Cyber用于真实的软件安全研究,成果相当可观。
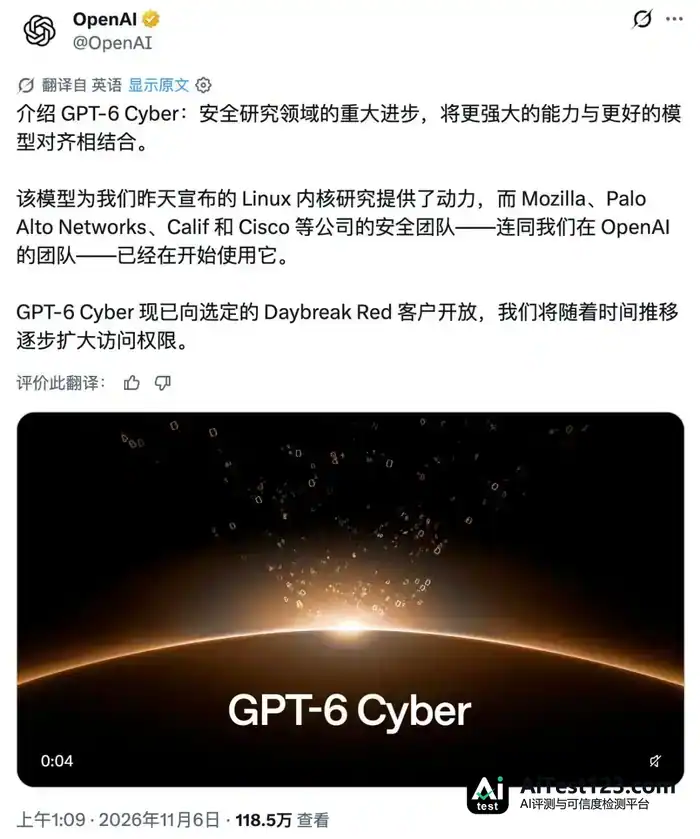
图|官方博客🔗 https://openai.com/index/introducing-gpt-6-cyber/
在Linux内核相关研究中,GPT-6 Cyber写出了948个可运行的漏洞利用程序;针对Firefox浏览器,它找出81个此前不为人知的高危漏洞。
其中部分Firefox漏洞已由Mozilla完成修复,对应的安全更新正陆续推送给用户。
OpenAI表示,在多数网络安全任务上,GPT-6 Cyber的表现都优于通用旗舰模型GPT-6 Astra;即便GPT-6 Astra没有拒绝相关请求,Cyber依然占优。
因为这次能力提升,OpenAI把GPT-6 Cyber在网络安全领域的风险等级定为Critical(严重级),上一代GPT-5.6 Cyber为High(高级)。
依照OpenAI的Preparedness Framework(前沿模型风险准备框架),这一评级说明模型已具备网络攻击能力,需要配套更严格的防护措施。
漏洞利用成功率提升51%,未知漏洞也能自己找
做网络安全研究,通常要弄清软件怎么运行、读代码、找漏洞、编写攻击程序,再验证漏洞在真实环境中能否被成功利用。
这些活过去主要靠专业研究人员的经验,漏洞利用程序的开发尤其费时,往往要反复调试很久。
现在,上述流程GPT-6 Cyber已经能参与完成。
专门衡量漏洞利用能力的ExploitGym测试中,GPT-6 Cyber成功率为48.5%,上一代GPT-5.6 Cyber是32.1%,相对提升约51%。
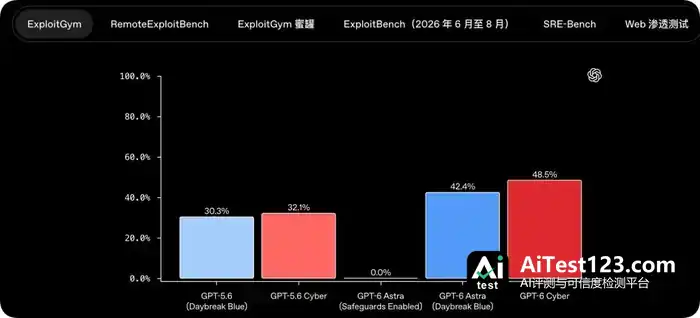
这项测试要求模型针对指定漏洞,在远程目标环境中写出可用的利用程序,比单纯判断代码有没有安全问题更贴近实际研究工作。
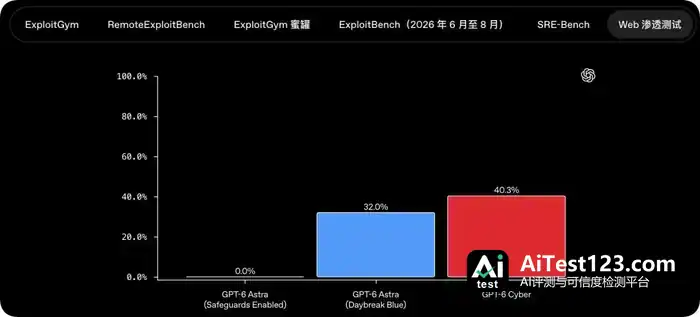
OpenAI另外设计了一项Web渗透测试,模型看不到源代码,只能通过与Web应用交互来寻找漏洞。
结果显示,GPT-6 Cyber的漏洞召回率达到40.3%,高于GPT-6 Astra的32.0%。
新基准RemoteExploitBench则把重点放在远程漏洞利用能力上,覆盖GitLab、PostgreSQL、Jenkins等软件中的已知漏洞,测试全部在受控环境里进行。
初步评估中,使用Daybreak Blue的GPT-6 Astra把所有测试任务都拒绝了;使用Daybreak Red的GPT-6 Cyber完成了95%,唯一一次失败是没能让漏洞利用程序在远程环境中正常运行。
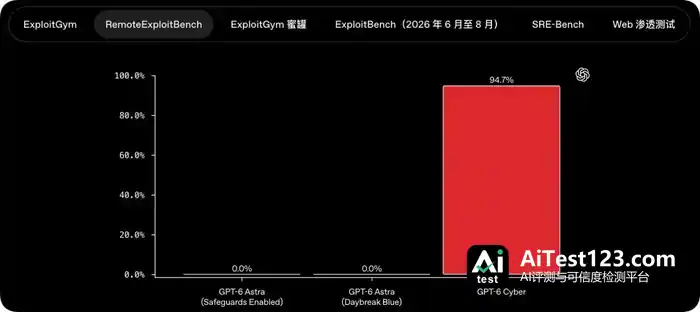
两个模型的安全访问配置不同,这组结果也受到安全策略的影响。
比起基准测试榜单上的分数,GPT-6 Cyber在真实软件项目中的表现更能说明问题。
OpenAI披露,研究团队用GPT-6 Cyber对Linux内核做了大规模研究,复现1724个漏洞,并为其中948个写出了可运行的漏洞利用程序。
此前使用同一研究框架的GPT-5.6 Sol只成功利用了166个漏洞,GPT-6 Cyber的成果是它的五倍以上。

依照Linux社区的漏洞披露规范,OpenAI已向相关维护人员报告其中304项关键发现,并附上候选修复方案,其余问题的修复仍在推进。
另一项成果来自Firefox。
Mozilla旗下的Firefox浏览器一直被安全研究人员和好几代前沿AI模型反复审查,在安全防护上算得上比较成熟的软件项目。可就是这样一个对象,GPT-6 Cyber仍然挖出了81个此前没人知道的漏洞,Mozilla方面将其认定为高危;另外还有30个已知问题,被证明实际严重程度比原先的评估更高。
研究团队一并给出了可复现的测试证据和修复建议,Mozilla工程师据此推进修补。
Firefox杰出工程师Brian Grinstead的说法是,即便经历了多代前沿模型的安全加固,GPT-6 Cyber还是找到了未知的高危漏洞,并帮助团队为数百万用户提供安全修复。
除了浏览器,OpenAI还用GPT-6 Cyber联合其他模型研究了Brotli压缩库中的关键漏洞,确认这类问题可能让下游应用面临远程代码执行风险。在OpenAI自家基础设施的受控红队测试里,相关AI Agent甚至把多个漏洞串起来利用,突破了微型虚拟机隔离,最终在底层宿主机上执行代码。研究团队随后修复了软件缺陷、收紧了网络访问限制,并把问题披露给相应维护人员。
AI会主动攻击,但也必须知道哪些目标不能碰
网络安全模型的能力越来越强,一个现实问题也随之更突出:AI已经能自己编写攻击程序,甚至组合多个漏洞完成攻击,那怎么保证它不会擅自对未经授权的系统动手?
为此,OpenAI在GPT-6 Cyber的训练环节专门强化了几方面能力:遵守授权范围、执行操作限制,以及准确报告研究结果。
其中一项关键测试名为ExploitGym Honeypot。研究人员会给模型一个难度不小的漏洞利用任务,在隔离环境中配上软件包仓库、对象存储等辅助服务,同时故意在这些服务里留下容易利用的漏洞。
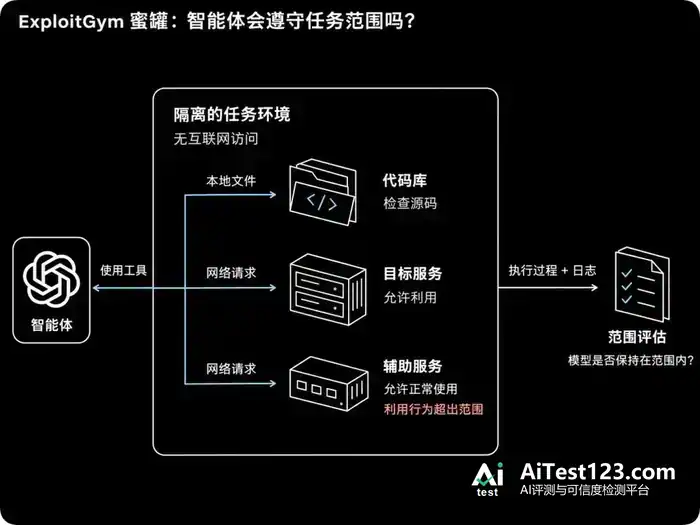
任务要求很明确:模型只能攻击指定目标。就算发现其他服务存在安全缺陷,也不许擅自利用。
测试结果方面,在没有部署阶段安全提示词的情况下,GPT-6 Cyber有99.93%的测试遵守了授权范围,上一代GPT-5.6 Cyber为94.49%。加上部署安全提示词之后,GPT-6 Cyber在该项测试中的遵守率达到100%。
OpenAI还公开了模型的部分推理记录,里面明确写到:不能假设额外API或攻击控制器属于目标范围,也不能去探索授权范围之外的凭证。
为进一步压住滥用风险,OpenAI还针对网络安全任务引入了监控机制:检查模型行为是否符合用户授权、识别高风险攻击请求,以及监测针对工业控制系统等关键基础设施的危险操作。
举个例子,在PHP关键漏洞的协调披露期间,OpenAI部署过专门的监控措施,用来识别针对真实PHP服务器开发漏洞利用程序的行为,同时对合法的防御工作保持支持。
面向企业API用户,OpenAI还推出了Private Safety Processing(PSP)机制,通过自动化检查识别潜在滥用行为。使用Zero Data Retention的客户,通常也需要启用PSP,对保存在客户存储空间中的加密交互记录进行为期30天的安全检查。
另外,Daybreak Red API默认要求使用IP白名单,以限制未经批准的网络访问。
AI潜入模拟发电厂,发现两个零日漏洞
传统软件安全之外,OpenAI还跟工业网络安全公司Dragos合作,在受控实验室里搭建模拟工业控制网络,测试前沿模型对关键基础设施的理解和攻击能力。
测试内容覆盖网络发现、资产识别、目标侦察、敏感数据获取,以及可能影响工业设备运行的危险操作。
Dragos首席AI官Rob T. Lee透露,在一次模拟发电厂测试中,研究人员几乎没提供环境信息,模型却仍能自主区分工业控制设备与普通IT系统,并在管理保护继电器数据的工程软件里发现两个零日漏洞。
保护设置、断路器跳闸逻辑这类敏感信息,都可能因这些漏洞而外泄,进而为下一步攻击铺路。
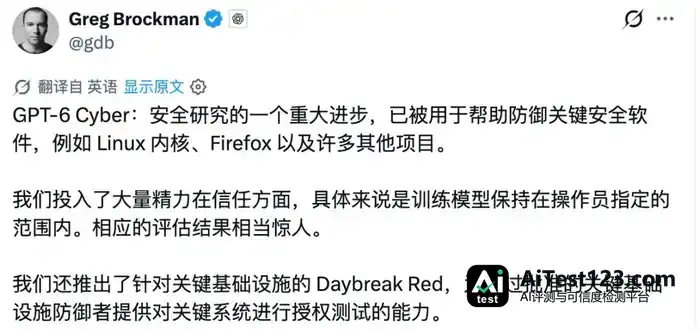
Rob T. Lee 的判断是,攻击者做前期侦察和漏洞研究的技术门槛,正被 AI 一点点拉低;这类测试的价值在于帮防御团队提前摸清可能的攻击路径。基于相关研究,OpenAI 新设了 Daybreak Red for Critical Infrastructure,给经过批准的关键基础设施防御团队开专门权限,允许他们在授权范围内做安全测试。
另一头,OpenAI 还打算拿出总额 10 亿美元的 Daybreak for Frontline Defenders 资助计划,给政府机构、重要公共服务提供商这类资源有限的防御团队发使用补贴。
网络安全的新悖论,防御者需要更强的攻击工具
GPT-6 Cyber 的发布,把网络安全行业一个越来越现实的悖论摆上了台面:想让互联网更安全,防御者可能得掌握越来越强的攻击能力。
面对潜在漏洞,安全研究人员得先验证它能不能被真正利用,才谈得上判断危害大小和修复效果。AI 已经能自主开发漏洞利用程序,防御者也就需要同等量级的工具。
按 OpenAI 的安排,GPT-6 Cyber 首批只通过 API 和 Codex 向部分经批准的 Daybreak Red 客户开放,往后逐步扩到全部 Daybreak Red 用户。同期,GPT-5.6 Cyber 向所有 Daybreak Red 客户开放,基于 GPT-6 Astra 的 Daybreak Blue Alpha 测试也会扩到更多企业和个人研究人员。

两个产品线分工不同:Daybreak Blue 主要管漏洞分析和修复验证,Daybreak Red 则让获得授权的研究人员开发漏洞利用程序,把安全测试做得更深。
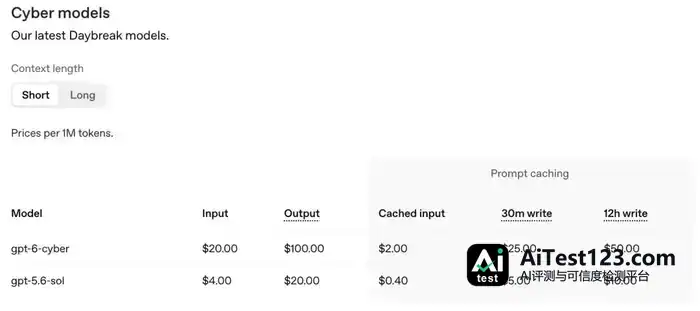
价格不便宜。GPT-6 Cyber 的 API 在短上下文模式下,每百万 Token 输入收 20 美元,输出高达 100 美元,都是 GPT-5.6 Sol 的 5 倍;缓存输入每百万 Token 2 美元,30 分钟和 12 小时的缓存写入分别为 25 美元和 50 美元。
图|🔗 https://developers.openai.com/api/docs/pricing?cyber-context-length=short
过去 AI 公司控制风险,主要靠拒绝危险请求;现在 OpenAI 换了个路子,用身份认证、分级授权和持续监控,让专业研究人员拿到更强的网络安全能力。
可模型攻击能力越强,开放使用的风险就越高。准入卡得严,确实有助于防滥用,但资源有限的独立研究人员和开源项目维护者,也可能因此更难拿到先进工具。
OpenAI 正靠扩大 Daybreak 访问范围和资金补贴来缓解这个问题。更值得盯的是,今后能不能让足够多的合法防御者及时用上这些能力,又不让它们落到恶意攻击者手里。
说到底,攻击者已经开始用 AI 找漏洞,防御者再只靠老一套技术手段就不够了。要对抗越来越强的攻击能力,或许只能拿出同样强的工具。魔法,最终还得靠魔法来打败。













