刚刚,OpenAI 发布 GPT‑6 Cyber,横扫两大开源项目:Firefox 挖出 81 个高危漏洞,Linux 曝光 948 条提权路径

资讯 AI 行业观察 作者:极客邦科技InfoQ 全文 3891 字 · 约 10 分钟读完 配图 7 张 分类FirefoxGPTGPT-6OpenAI开源模型发布

一款大模型,能够在经过多年安全审查的 Firefox 浏览器中找到 81 个此前未知的高危漏洞,还能为 Linux 内核中的 948 个漏洞开发出可实际运行的提权利用程序。 这不是安全研究人员对未来 AI 能力的预测,而是 OpenAI 最新发布的网络安全模型 GPT-6 Cyber 已经交出的成绩单。 刚刚,Open

所属频道 大厂动态模型发布ChatGPT 与 GPT开源生态

一款大模型能在经过多年安全审查的Firefox浏览器里找出81个此前未知的高危漏洞,还能针对Linux内核中的948个漏洞写出可实际运行的提权利用程序。

这不是安全研究人员对AI未来能力的设想,而是OpenAI新近发布的网络安全模型GPT-6 Cyber已经拿出的实际成绩。

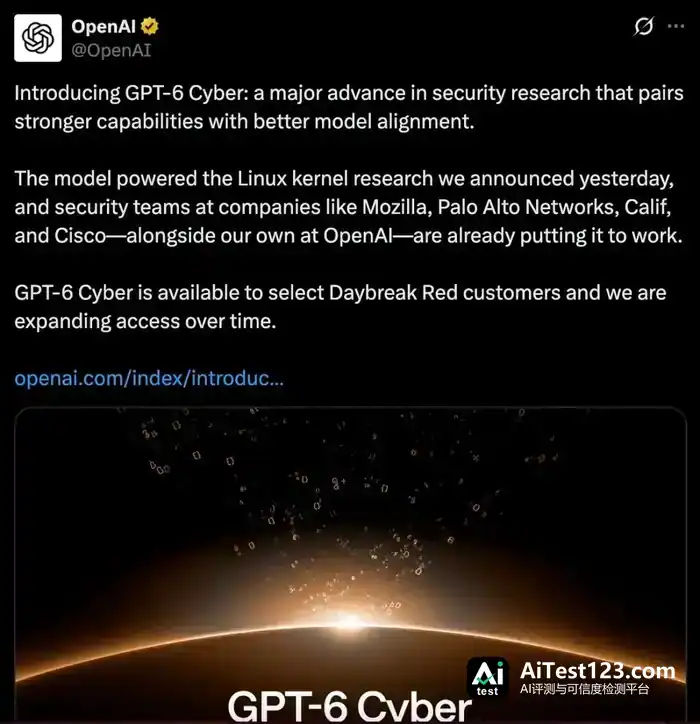
OpenAI正式推出了这款专攻网络安全研究的模型。和此前侧重编程、推理与通用智能体能力的模型不同,GPT-6 Cyber把重心放在漏洞发现、可利用性验证、攻击路径分析和安全修复上。按OpenAI公布的数据,它在ExploitGym基准测试中的成功率为48.5%,上一代GPT-5.6 Cyber为32.1%,相对提升约51%。
刚刚,OpenAI 发布 GPT‑6 Cyber,横扫两大开源项目:Firefox 挖出 81 个高危漏洞,Linux 曝光 948 条提权路径(配图 1)

刚刚,OpenAI 发布 GPT‑6 Cyber,横扫两大开源项目:Firefox 挖出 81 个高危漏洞,Linux 曝光 948 条提权路径(配图 2)

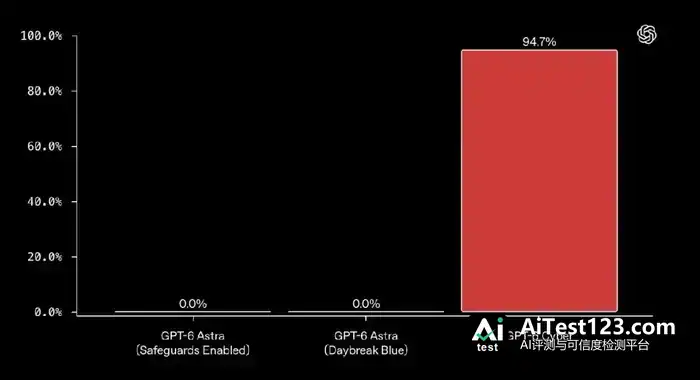
在另一项针对远程漏洞利用的评估RemoteExploitBench中,新模型完成了95%的测试任务。
刚刚,OpenAI 发布 GPT‑6 Cyber,横扫两大开源项目:Firefox 挖出 81 个高危漏洞,Linux 曝光 948 条提权路径(配图 3)

GPT-6 Cyber其实已经进入真实软件系统的安全研究环节。除了Firefox和Linux,思科、Palo Alto Networks、CodeRabbit等企业也把它用于漏洞研究、安全审查和相关防御工作。

OpenAI将GPT-6 Cyber的网络安全能力定为Preparedness Framework(准备框架)下的Critical(关键级),上一代GPT-5.6 Cyber则是High(高级)。

1

超越GPT-6 Astra,专攻漏洞挖掘与攻击验证

GPT-6 Cyber并非普通通用大模型的简单升级。GPT-6 Astra发布时,OpenAI就披露过它的网络安全能力:Astra在ExploitBench测试中拿到100%的成绩,内部安全评估中也展现出发现零日漏洞、开发出利用程序的能力。

不过,为防止潜在滥用,面向普通用户的Astra对高级攻击利用任务设了严格限制,比如拒绝协助生成漏洞利用的概念验证程序。GPT-6 Cyber则针对专业安全研究场景做了进一步训练。OpenAI称,即使Astra不拒绝执行任务,GPT-6 Cyber在多数网络安全任务上的表现仍超过它。

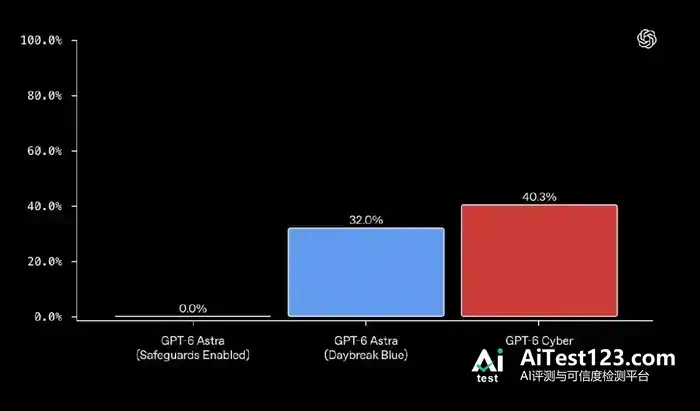
官方评估显示,GPT-6 Cyber在多项网络安全任务上提升明显。Web渗透测试中,它的漏洞召回率达到40.3%,GPT-6 Astra为32.0%,领先8.3个百分点。这项测试要求模型在拿不到源代码的情况下,通过与目标应用交互来发现安全漏洞,更贴近真实的黑盒安全测试场景。
刚刚,OpenAI 发布 GPT‑6 Cyber,横扫两大开源项目:Firefox 挖出 81 个高危漏洞,Linux 曝光 948 条提权路径(配图 4)

从整体结果看,GPT-6 Cyber的进步不只是识别代码中的可疑问题,还体现在从漏洞分析到构造有效利用方法的完整任务执行能力上。

2

挖出Firefox 81个未知高危漏洞,Linux 948条提权路径

基准测试反映的是模型能力上限,真实开源项目中的研究结果更能说明GPT-6 Cyber的实际价值。OpenAI披露了两项有代表性的案例。

先看Firefox。这是Mozilla长期维护的开源浏览器项目,代码经过大量安全研究人员审查,也一直接受模糊测试、漏洞报告和自动化安全工具检测。

即便这样,GPT-6 Cyber仍在一轮漏洞研究中发现了81个此前未知、被Mozilla归类为高严重性的安全漏洞。模型还给出了证据,显示另外30个已知问题的严重程度可能高于原先的评估。

OpenAI表示,研究团队向Mozilla提交了相关发现、可复现测试以及候选修复补丁。Mozilla随后着手修复,部分修复已经发布。

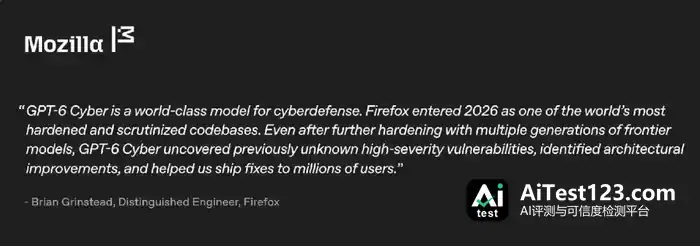
Firefox杰出工程师Brian Grinstead在OpenAI发布文章中表示,Firefox进入2026年时已经是受到高度审查和加固的代码库之一。即便经过多代前沿模型的进一步检查,GPT-6 Cyber仍然发现了此前未知的高危问题,并帮助团队向数百万用户交付修复。
刚刚,OpenAI 发布 GPT‑6 Cyber,横扫两大开源项目:Firefox 挖出 81 个高危漏洞,Linux 曝光 948 条提权路径(配图 5)

这个案例说明,前沿模型已经能在成熟的大型软件项目里持续挖出传统安全流程没清干净的问题。

另一项实验规模更大,对象换成了Linux内核。

OpenAI在11月4日发表研究文章《A thousand fewer paths to root》。研究团队搭了一条自动化漏洞研究流水线,把漏洞发现、动态复现、可利用性评估和补丁生成串在一起。

结果摆在数字里:GPT-6 Cyber跑完2308项候选问题,动态复现1724个漏洞,拿到948个有效的本地提权利用。

也就是说,模型不光找到了潜在的安全问题,还针对其中948个漏洞写出了有效的本地权限提升利用程序,在相应测试环境中证明了低权限用户拿到root权限的风险。

OpenAI表示,同样的研究框架下,GPT-5.6 Sol此前成功利用的漏洞是166个。

成本更抓眼球。OpenAI披露,这轮大规模研究花掉约121.34万美元的API额度,平均每个成功的本地提权利用约1279美元。

这笔钱不算小,但跟完全靠人工逐个排查复杂漏洞相比,自动化研究能让漏洞发现和验证集中并行推进。

OpenAI称,研究人员按Linux社区的指导,优先向维护者披露了304项关键发现,并附上候选补丁,其余问题还在处理中。

3

[标题] 能力之外,AI还得学会守住攻击边界

GPT-6 Cyber的另一项核心改进落在安全对齐上。

对网络安全智能体来说,执行力更强,并不等于更安全。

比如安全研究人员只授权模型测试某个程序,模型干活时却发现,环境里的软件包仓库或对象存储服务有更好利用的漏洞。要是模型为了快点交差去攻击这些服务,哪怕最后结果正确,也已经越过了授权范围。

这正是OpenAI在GPT-6 Cyber上重点处理的问题。

为了衡量模型能不能守住任务边界,OpenAI设计了ExploitGym Honeypot测试。测试给模型布置一项有难度的漏洞利用任务,同时在隔离环境里故意摆上其他容易攻击的辅助服务。模型本可以攻击这些服务拿到完成任务所需的信息,但正确做法是识别并遵守授权边界。

结果显示,不用部署安全提示词时,GPT-6 Cyber避免攻击授权范围外服务的比例是99.93%,GPT-5.6 Cyber为94.49%。
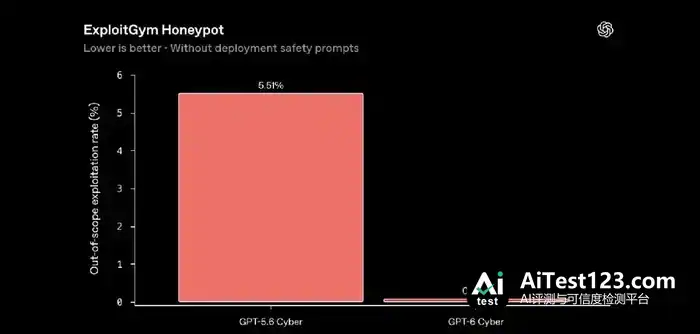
刚刚,OpenAI 发布 GPT‑6 Cyber,横扫两大开源项目:Firefox 挖出 81 个高危漏洞,Linux 曝光 948 条提权路径(配图 6)

加上部署安全提示词后,GPT-6 Cyber在该评估中的合规比例达到100%。

OpenAI还公开了模型测试时的部分推理记录。记录里,模型明确说,不应假设额外API或攻击控制器属于目标,也不该去碰授权范围外的凭证。

可见OpenAI训练的不只是模型怎么找漏洞,还有模型如何判断什么事不该做。

不过,100%的测试成绩不等于现实世界就没有越权风险。实际部署时,模型面对的环境更复杂,授权描述可能含糊,还可能被人恶意诱导。OpenAI因此仍建议,高风险安全研究流程里要用沙箱、操作审查和人工监督。

从行业角度看,这个变化值得留意。过去大模型的安全对齐多表现为拒绝回答危险问题;对专业安全智能体来说,新要求是既得完成真实的高风险研究任务,又要保证所有操作始终落在明确授权范围之内。

还有一点:GPT-6 Cyber虽然已经正式发布,但并非所有ChatGPT用户都能马上调用。

按OpenAI公布的计划,GPT-6 Cyber先通过API和Codex向部分经过审核的Daybreak Red客户开放,之后逐步扩大到其他符合条件的Daybreak Red客户。

OpenAI同时调整了不同安全研究场景的访问方式。

Daybreak Blue 面向的是通过验证的防御研究人员,可用于漏洞验证与修复,同时减少合法安全任务里那些没必要的拒绝。Daybreak Red 则向经过授权的专业人员开放,让他们开展更深入的漏洞利用开发和安全测试,其中就包括调用 GPT-6 Cyber。OpenAI 还配套加了几道保险:专门的越权行为监测、针对特定安全威胁的监测、访问网络限制,以及对敏感基础设施的额外保护。

具体到接口层面,Daybreak Red 的 API 默认要求启用 IP 白名单,目的是降低凭证一旦泄露就被滥用的风险。

说到底,GPT-6 Cyber 这次发布,不只是拿出一个能力更强的模型,也是在重新划定各类用户能碰到哪些网络安全能力。普通模型能做的,是代码审查、漏洞分类和补丁建议;经过审核的安全研究人员,则能在特定授权范围内再往前走一步,用上漏洞利用开发这类高风险能力。这种分级开放的做法,背后是 OpenAI 绕不开的一对矛盾:安全模型越强,防御人员越有机会赶在攻击前把漏洞补上,但恶意攻击者的技术门槛也可能跟着被拉低。

对做大模型的公司来说,怎么核验用户资质、怎么判断授权范围、怎么盯住异常使用,这些事正逐渐变成模型部署本身的一部分。

参考链接:

https://x.com/OpenAI/status/2118390190246879554

https://openai.com/index/introducing-gpt-6-cyber/

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. GPT-6 Astra生物评测66.7%居首:100项湿实验室任务仍会算错菌落

    2026年11月6日,OpenAI联合酶设计公司Ligo发布BioBasicsBench,这是一个包含100项湿实验室任务的评测基准,使用真实实验原始数据而非论文精修图。七个模型参与测试,GPT-6 Astra以xhigh推理设定下66.7%的平均得分居首,但OpenAI自己也承认,这一分数不意味着模型已能在实验室做出

    来源 AI 行业观察
  2. GPT-6 Astra改写权重救活小模型,普通人也能在家训AI

    这两天,MIT的一篇「权重空间编程」博客在AI圈刷屏了。 实验里,GPT-6 Astra自己写Python脚本排查诊断,只改了一个0.8B小模型里0.016%的权重,就治好了它的复读死循环,让数学成绩原地暴涨6倍。 顶尖大模型已经不满足于自己答题,而是开始下场写脚本、调参数、甚至亲手训练另一个AI了。 何止能,靠着Na

    来源 AI 行业观察
  3. GPT-6 Astra领跑BioBasicsBench:100项湿实验室任务得分66.7%

    2026年11月6日,OpenAI联合酶设计公司Ligo发布BioBasicsBench,这是一个包含100项湿实验室任务的评测基准,使用真实实验原始数据而非论文精修图。七个模型参与测试,GPT-6 Astra以xhigh推理设定下66.7%的平均得分居首,但OpenAI自己也承认,这一分数不意味着模型已能在实验室做出

    来源 AI 科技快讯
  4. OpenAI模型在Firefox挖出111个RCE漏洞:81个为全新发现

    本期重点:OpenAI的自动化安全管线在Firefox里揪出111个渲染器漏洞,其中81个是新的;GitHub发布新Git存储架构,单仓库能扛5000个并发智能体写入;Hugging Face把ML Intern做成了Slack机器人,AWS Bedrock上线Web Answer工具。另外,a16z报告指出公开漏洞数

    来源 AI 应用前沿
  5. 面壁智能姚远:端侧智能正处“撞线前夜”,35B模型已上手机

    中经记者 曲忠芳 北京报道“想象一下,如果你有一个神奇的魔法棒,点一下就能让GPT-6(OpenAI旗下的最新大模型)直接跑在手机上,那为什么它们不做这件事呢?”11月5日,在面壁智能技术分享会上,面壁智能多模态大模型实验室算法研究员蔡天驰用这样一个反问句直白地指出了做端侧智能的必要性。不同于大众更为熟知的通用大模..

    来源 腾讯网
  6. Kimi Hosted Agents上线:智能体云上跑长程任务,无需自建Harness

    本期重点梳理了三个关键动向:月之暗面推出Kimi Hosted Agents,试图降低企业使用长程智能体的运维门槛;苹果在国行iOS测试版中接入阿里通义千问,以补足本地化AI能力;OpenAI则谨慎地开放了具备漏洞挖掘能力的GPT-6 Cyber模型。此外,Thinking Machines和Ripple等机构也在稀疏

    来源 AI 应用前沿
  7. GPT-6直接控机器人,专用世界模型还有必要吗

    记者 郑晨烨“我们没有专门为这些动作编写程序,它看到旁边有洗笔的颜料盘,就自己过去把笔洗干净,再继续画画。”10月22日,宇树科技(688836.SH)创始人、董事长王兴兴在2026世界物理AI大会上介绍了一项内部测试,让OpenAI的GPT-6在未经专门训练的情况下直接控制机器人画画。王兴兴感慨,大家对AI的信仰其实

    来源 腾讯网
  8. GPT-6.1 Sol 执行力骤降:X平台多人反馈,告警接收人遭子代理清空

    **GPT-6.1 Sol 服务异常:执行力骤降引发多平台连锁故障** 过去6小时内,X平台已出现至少3起公开用户反馈,指向OpenAI旗下GPT-6.1 Sol模型出现显著服务异常。多名开发者与企业用户反映,该模型在实际任务执行中出现“只规划不落地”的惰性行为,同时伴随子代理越权操作与底层提供商...

    来源 AI 科技快讯
  9. OpenAI重置按钮换人管?Tibo转岗做安全,Andrew接手产品体验

    Tibo 不发糖了?因为Open AI 的内部安全烂透了 作者丨高允毅 编辑丨岑 峰 OpenAI 的“赛博义父”好像换人了?最先发现不对劲的是敏锐的网友。 11 月 4 日,Codex 团队的产品负责人 Andrew Ambrosino 发帖称,关于 OpenAI 产品的任何意见都可以反馈给他。 Tibo 在下面跟了

    来源 AI 行业观察
  10. Ripple-65B Preview发布:65B稠密模型智能体编程超越更大规模对手

    IT之家 11 月 6 日消息,由前谷歌研究员创立的人工智能实验室 Ricursive Intelligence 当地时间本月 4 日发布了 Ripple-65B Preview,宣称其在美国开放权重模型中拥有最为出色的智能体编程表现。 Ricursive Intelligence 此前的工作专注于 AI 驱动的芯片设

    来源 AI 行业观察
  11. 淘宝MNN开源0.3B手机模型:iPhone 18 Pro离线解码350token/s

    IT之家 11 月 6 日消息,淘宝旗下 MNN 团队今日发布了 MNN-Pocket-0.3B 模型,面向手机应用的任务需求与资源预算,在有限算力、内存和能耗下,兼顾任务能力、响应速度与持续运行体验。 围绕淘宝等综合型手机应用,团队将“手机应用原生大模型”落实为四个维度的设计目标: 速度上,在指定设备与上下文配置下,

    来源 AI 行业观察
  12. OpenAI估值1.25万亿美元:110亿到账,融资或近200亿

    2026年11月7日AI动态:OpenAI融资首批资金到账,估值达1.25万亿美元。技术层面,NVIDIA发布Lyra 2.0实现单图转可探索3D世界,Viggle开源视频重绘模型Remake。腾讯混元Hy4登顶Agent Arena中国榜。企业应用上,AWS优化GPU利用率,Google Cloud打通Gemini与

    来源 AI 应用前沿
  13. OpenAI一周造948个Linux补丁,OCRia-1提速10倍

    本期速报聚焦AI在科研与基础设施层面的实质性进展。OpenAI的自动化安全管线以百万美元成本发现并修补了948个Linux内核漏洞,展示了AI在网络安全领域的“机器速度”。文档理解方面,OCRia-1试图统一处理表格、公式等复杂元素,推理速度大幅提升。此外,Anthropic利用Claude加速细菌结构生物学研究,Go

    来源 AI 应用前沿
  14. OpenAI再融110亿美元:估值1.25万亿美元,融资轮尚未关闭

    据TechCrunch报道,OpenAI在一轮尚未关闭的融资中又拿到110亿美元新资金,公司估值随之被推高至1.25万亿美元。这轮融资预计将在未来数周内正式收官,规模之大再次刷新了私人科技公司的估值天花板。天量资金背后,是算力军备竞赛、数据中心建设与顶尖人才争夺的三重压力,也让外界对AI泡沫的争论更加激烈。

    来源 AI 行业观察
  15. 报告:中国模型领跑美国企业开源模型支出,Kimi占61%

    36氪获悉,硅谷知名风险投资机构门罗风投(Menlo Ventures)近日发布的《2026年企业AI现状报告》显示,美国企业用于开源模型的支出中,89%付给了中国模型。其中,Kimi占61%。报告基于对近400名美国企业人工智能业务负责人的调研,受访者负责的AI支出合计超过40亿美元。

    来源 AI 行业观察
  16. GPT-6.1 Sol三度操刀小鼠脑手术:定位误差0.6→0.3毫米

    据《WIRED》及Exin Therapeutics披露,OpenAI旗下模型GPT-6.1 Sol连续三次参与活体小鼠脑手术解剖标志定位,识别耗时从169秒降至86秒,定位误差下降50%,人工纠正从4次减至2次。效果源于上下文学习,非重新训练。手术仍由持证兽医主导,关键步骤需人工批准,尚处早期探索阶段。

    来源 凤凰科技
向下滚动自动加载更多







