OpenAI上线GIF生成功能:Images 2.6提速50%,设计工具活儿收进模型
OpenAI要把靠AI重生的应用都干死?
11月5日早间,ChatGPT里多了一样东西,不少人是在使用时才发现的。
给一句话,或者传一张照片,它就能吐出一段循环播放的GIF。出来之后播放速度可以调,每一帧能翻看,某一帧不满意还能单独改。
我们随手试了试,动物、动画这类题材,有些效果确实可以。
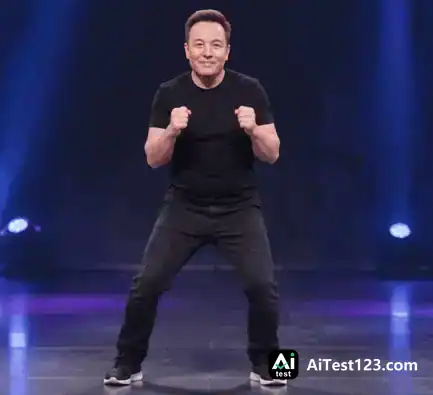
也有翻车的。提示词写的是“马斯克跳闪身步”,结果动图里既看不出马斯克,也看不出闪身步,画面比较糙。
今年初Images 2.0刚露面时,很多人感慨“眼见为实”的日子过去了,那场面估计大伙还有印象。
生图此后一直是OpenAI最能打的能力之一。不过这次的变化,跟以往不太一样。
以前的AI生图,解决的是从无到有:用户给一段文字,模型还一张图。可一张图要真正进工作流程,后面还得改、得排版、得转格式。普通用户面对这些步骤,意味着再开几个软件;设计师和内容团队则要搭上一段不短的后期时间。
Images 2.6这版更新,OpenAI开始把这些活儿往模型内部收。
除GIF生成外,新模型图像生成更快,多轮编辑更稳,还给了开发者SVG矢量导出和图像标注编辑接口。价格方面,OpenAI没涨。
过去,AI图像创业公司的很大一部分价值,就来自模型能力和用户实际需求之间的那段距离。它们把复杂模型包装成好上手的成品,再靠修图、排版、模板、素材管理这些功能收钱。
可当模型厂商自己动手把这些环节补齐,原来的生意就没那么稳了。
对OpenAI来说,这也许只是图像产品的一次升级;对一批靠单点功能吃饭的AI工具公司来说,变化恐怕才刚开头。
加量不加价,三类工具的活被装进模型
Images 2.6不是简单提个速的版本。
从产品设计看,OpenAI这回做了两件事:让图像生成更快,让生成之后的修改和使用更省事。
先说速度。
按OpenAI公布的数据,Images 2.6比上一代整体快了50%。API端推出两个版本:GPT-Image-2.6 Flare和Sunburst。
Flare偏重响应速度和效率,海报、商品图这类要快速迭代的任务适合它;Sunburst更看重细节和多轮编辑的一致性,画面精度要求高的工作用它更合适。
低画质设置下,Flare最快约6秒就能出一张图。对需要反复调素材的内容生产者来说,速度快了,同样时间里就能多试几轮。
说个冷知识:快手最早就是做GIF动图的工具,名字叫“GIF快手”。后来它从工具软件长成中国最大的短视频平台之一,中间经历了一次重要的产品转型。
举这个例子是想说明,GIF动图的需求摆在那儿,很明确。
现在在ChatGPT里,用户直接写文字描述或者传图就能生成动图。比如让一张人物照片动起来,或者把静态商品图变成循环播放的展示素材。生成后播放速度可调,单帧画面也能查看和修改。
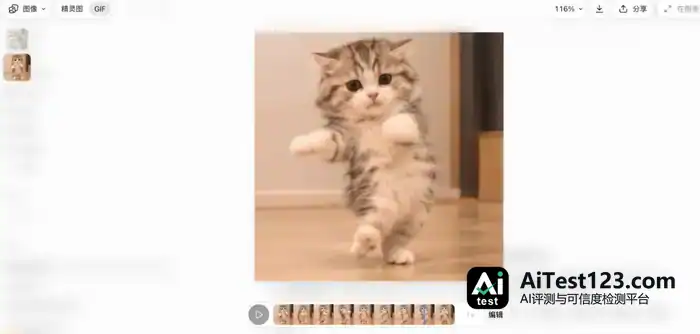
对社交媒体运营、广告营销和内容创作者来说,这能力有实际用处。以前一张静态图要变成GIF,一般得走图片处理、逐帧制作、动图合成这几步。偶尔用一次的人,不值得专门去学这套流程;素材需求量大的团队,则要额外搭时间和人力。
OpenAI在官方博客里提到,AI办公助手公司Town已经用上新模型,给产品里的虚拟角色做打字等待动画。
另一处变化在设计文件的输出上。
Images 2.6已经能导出SVG格式了,只是眼下这项能力主要对API开发者开放。和常见的PNG、JPEG不一样,SVG存的是矢量路径,无论放大多少倍都不会糊成像素块,后续调整图形、颜色和细节也方便得多。
换句话说,模型产出的东西不再局限于“能看”的图片,而是可以直接进入网页、应用和印刷流程的设计素材。
对设计师群体来说,这个变化的分量不轻。
局部编辑同样在朝这个方向走。
ChatGPT早前就上线了图像标注功能:用户在图片上圈出想改的地方,再用文字说明需求即可。这次更新,OpenAI把这项能力开放给了API开发者。
开发者因此可以把图像修改嵌进自家产品里,不必再指望用户重新敲一遍提示词,也不用靠复杂的蒙版操作去圈定修改范围。
OpenAI还新增了complexity参数,开发者能借此控制模型在生成前花多少规划计算。任务简单就少规划、优先保速度;构图复杂则多投算力。
这和文本模型里调节推理力度的做法有几分相像。模型不再只有一种固定的生成模式,资源怎么分配,交由开发者按任务复杂度决定。
价格上,Flare和Sunburst的图像输出都是每百万Token 30美元,图像输入8美元,文本输入5美元,与上一代对应模型持平。
能力变成接口,中间商的处境变了
过去几年,AI图像赛道冒出了一批增长很快的创业公司。
有的做AI写真,有的做商品图,还有的专攻海报、头像和社交媒体素材。产品形态各异,商业逻辑却相近:底层调模型,上层搭交互界面和具体功能,再靠订阅、点数或企业服务收钱。
这套打法在生成式AI起步阶段很容易成立。
那会儿基础模型用起来门槛不低,普通用户既不知道怎么写出有效的提示词,也不清楚如何控制画面;模型本身往往又只能干单项任务,生成结果还得借助别的软件再处理。
创业公司正好填上了这段距离。
它们未必有自己的模型,但能靠产品设计把复杂的技术能力包装成普通人用得上的服务。用户为便利掏钱,创业公司从中拿到商业收入。
美图就是个例子。它是互联网时代的产品,到了AI时代又活了过来,走的就是这个逻辑:不做自己的基础大模型,靠做大模型与用户之间的连接赚得盆满钵满。2026年上半年,它的营收增加了22.1%,净利润暴涨了39.5%。
现在的问题是,OpenAI这样的顶级模型,开始把过去由应用层承担的功能直接做进模型,创业公司的竞争优势将直接受到冲击。
拿AI海报来说,过去一个产品可能提供几十种模板,用户选风格、输文字,再由模型出图。如今底层模型如果已经能理解海报布局、准确处理文字,还能直接完成局部修改,那么只提供模板和提示词的产品,就很难再守住原有的差异化。
AI修图也是类似的情况。
用户只想换个背景、调整人物服装或者改掉画面里某个细节,直接在ChatGPT里做,可能比打开一个独立应用更省事。尤其当这些功能已经包含在用户现有的订阅里,第三方工具就尴尬了:同样的能力,用户凭什么再付一次钱?
换过来看,OpenAI 的盘算也不小:底层技术攥在自己手里,ChatGPT 这样的流量入口也在手上,新功能可以径直推到海量用户面前。
受影响的也不只是美图,Canva、Adobe都在其列,它们需要警惕的是用户对工具需求的变化。
Adobe Firefly目前没有单纯依靠模型画质竞争,而是强调商业使用的安全性。按照Adobe此前公布的企业政策,Firefly早期模型主要使用Adobe Stock、开放授权内容和公有领域内容进行训练,部分企业客户还可以获得合同约定的知识产权赔偿保障。
品牌和企业客户做商业设计,版权风险、素材来源、最终由谁担责,这些都得算进去。Adobe眼下相对稳的地方,恰恰就在这里。
也有应用方已经动手,把新模型接进了自家产品。
Figma Weave和Picsart成了Images 2.6的早期合作方。OpenAI在发布信息里说,Figma Weave把新模型用在可复用的创意工作流上;Picsart则想靠更快的生成和更稳的编辑,让用户做系列化视觉内容时更省事。
说到底,底层模型越强,应用层就越得重新证明自己值多少钱。
一家工具公司如果卖的只是模型本身已经会的东西,溢价很难长期撑住。反过来,它要是能把模型嵌进复杂业务流程,攒下用户数据、行业经验和协作关系,模型变强反倒可能推着自己增长。
AI应用市场接下来可能出现的一次分化,也就在这里。
OpenAI想要的生意还有很多
今年9月OpenAI推出Images 2.5时,就已经在强调更精确的编辑、参考图片和更快的生成速度。当时公布的数据是,用户每周通过ChatGPT和API生成的图片超过30亿张。
才过两个月,这个数字又多了10亿。一家靠对话产品起家的公司,图像能长成ChatGPT里规模相当可观的使用场景,这本身就说明问题。
尤其是图像生成一旦进入更具体的工作流程,商业价值就不一样了。模型厂商争的不再只是一次调用,而是用户在整个工作过程中用哪个平台。
OpenAI近几个月的战略调整,也能给这次图像更新提供另一个观察角度。
今年3月,OpenAI宣布停掉Sora独立产品。路透社当时报道说,这一决定跟公司重新分配资源有关,OpenAI开始把更多注意力放到编程工具、企业客户这些商业前景更明确的方向上。Sora相关产品随后在4月停止服务,API也在9月关闭。
这事曾让外界感到意外。Sora是OpenAI在视频生成领域最受关注的产品之一,引发过大量讨论,也一度被视为生成式AI进入内容生产行业的重要入口。
但看后续动作,OpenAI对产品价值的判断正在调整。
跟独立的视频生成应用比,能嵌进ChatGPT、Codex和企业工作流的能力,或许更容易带来持续使用和商业收入。
Images 2.6的产品设计,某种程度上也体现了这种取舍。
它没把重点放在一个全新的独立创作社区,也没打算再造一个专门的GIF应用。GIF生成直接放进ChatGPT,SVG、markup等能力开放给API开发者。用户在原有产品里能完成更多事情,开发者也能把这些能力接进自己的应用。
这样一来,OpenAI同时握住两个方向的机会:C端增加ChatGPT的使用场景,B端通过API进入更多专业软件和业务流程。
其中API的意义尤其值得注意。
ChatGPT直接面对的是用户,API面对的则是那些已经拥有用户、业务和场景的公司。OpenAI不必亲自开发每一种垂直工具,只要提供底层模型,其他企业就会把它的能力嵌进自己的产品。
对国内创业者来说,一些机会可能已经在悄悄流失。
AI修图、AI海报、AI头像、AI商品图过去一度是生成式AI创业最容易切入的方向。产品开发周期短,用户需求直观,靠订阅和流量也容易实现早期商业化。
可随着模型能力不断下沉,只靠提示词优化、界面设计和简单功能组合,很难成为长期壁垒。
真正有价值的东西,也许并不在模型本身。
拿电商图片工具来说,它能不能读懂不同品类商品的特性,能不能让商品细节不走样,能不能接上商家的商品数据库和广告投放系统?企业设计工具同样如此:品牌素材管不管得住、视觉规范能不能统一,跟内部审批和协作流程打不打得通,都是问题。
工具类创业公司接下来得重新回答一个问题:底层模型能做的事越来越多,自己手里到底还攥着什么?
再往远看一点,顶级模型的能力越来越强,人是不是也该想想,自己还剩下什么?