OpenAI推GPT-6 Cyber:安全测试48.5%,远程漏洞任务完成95%

资讯 智东西 全文 3848 字 · 约 10 分钟读完 配图 16 张 分类GPTGPT-6OpenAI

多数网络安全任务胜Astra。

所属频道 大厂动态ChatGPT 与 GPT
OpenAI推GPT-6 Cyber:安全测试48.5%,远程漏洞任务完成95%(配图 1)

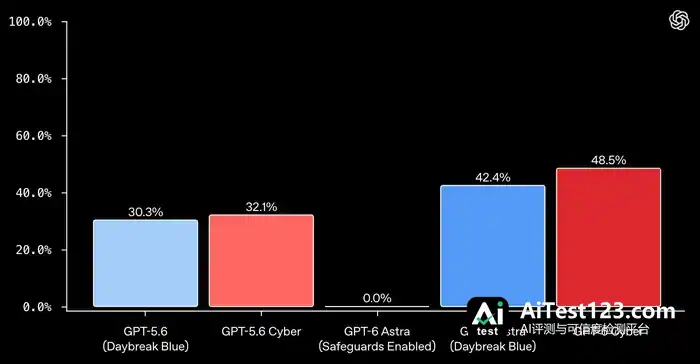
OpenAI在11月6日推出新模型GPT-6 Cyber,主攻安全研究领域。在关键网络安全基准测试中,它的表现明显强于GPT-5.6 Cyber:安全测试ExploitGym上GPT-6 Cyber拿到48.5%,GPT-5.6 Cyber为32.1%,相对提升51%。

奥尔特曼急了,OpenAI连夜掏出新模型GPT-6 CyberOpenAI在社交平台X发布了公告。

模型发布后,不少开发者留言:“原本以为是6.2。”“不是这个,我们需要6.2 Sol和Astra。”就在前日,外媒The Information报道称,OpenAI最快可能于当地时间本周五发布新一代(GPT-6.2)Astra、Sol系列模型,以及面向网络安全领域的Cyber模型。
奥尔特曼急了,OpenAI连夜掏出新模型GPT-6 Cyber奥尔特曼急了,OpenAI连夜掏出新模型GPT-6 Cyber

社交平台X上的开发者评论节选。

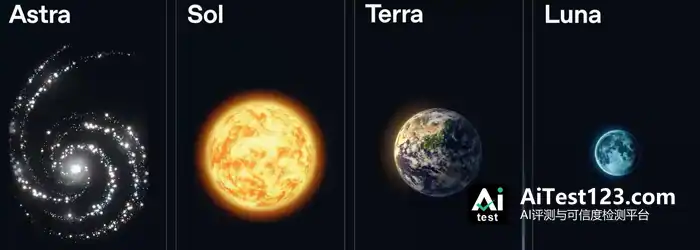
不过截至今天,真正到场的只有GPT-6 Cyber。从定位看,OpenAI的GPT-6和GPT-6.1系列涵盖Astra、Sol、Terra、Luna等不同型号:GPT-6 Astra是OpenAI能力最强的旗舰模型,面向高难度推理和复杂任务;GPT-6 Luna主打快速、高效的规模化日常工作;这次推出的GPT-6 Cyber则专攻安全领域。

GPT-6.1也已经迭代出:GPT-6.1 Terra,侧重速度、成本和日常任务执行;GPT-6.1 Sol,侧重高性价比的复杂编程和推理任务。
奥尔特曼急了,OpenAI连夜掏出新模型GPT-6 Cyber

OpenAI表示,GPT-6 Cyber已在Linux和Firefox等安全关键型代码库里发现并验证数千个漏洞。Mozilla、Palo Alto Networks、Calif和Cisco等多家公司的安全团队,以及OpenAI自己的团队,都已开始使用该模型。

GPT-6 Cyber引来不少开发者围观。有人在社交平台X上说:“能够发现Linux内核中真实安全漏洞的AI……哇,这才是真正重要的进步。”也有人表示:“Linux内核的工作为本次公告提供了一个具体的案例。如果能提供从发现bug到验证修复的完整步骤,对开发者来说将尤为有用。”
奥尔特曼急了,OpenAI连夜掏出新模型GPT-6 Cyber

奥尔特曼急了,OpenAI连夜掏出新模型GPT-6 Cyber

社交平台X上的开发者评论节选。

但GPT-6 Cyber眼下还不能直接在聊天里选用,只面向部分Daybreak Red计划认证的客户开放,OpenAI称会逐步扩大使用范围。于是不少开发者吐槽:“又一个没人能用的模型,OpenAI我真的会谢。”

奥尔特曼急了,OpenAI连夜掏出新模型GPT-6 Cyber

奥尔特曼急了,OpenAI连夜掏出新模型GPT-6 Cyber

社交平台X上的开发者评论节选。

一、比Astra更能打,GPT-6 Cyber远程漏洞任务完成95%

OpenAI称,在大多数网络安全任务上,GPT-6 Cyber都优于GPT-6 Astra。测评覆盖理解软件、识别漏洞和开发有效攻击程序等任务。

根据结果,按照其网络安全准备框架,OpenAI把GPT-6 Cyber的网络安全等级评为“关键(Critical)”,高于GPT-5.6 Cyber的“高(High)”。

ExploitGym测试中,GPT-6 Cyber得分48.5%,比GPT-5.6 Cyber的32.1%高约16个百分点。为检验漏洞发现能力,OpenAI构建了针对攻击性Web渗透测试的新评估:模型接触不到Web应用源代码,只能靠探测。GPT-6 Cyber漏洞召回率为40.3%,GPT-6 Astra为32.0%。
奥尔特曼急了,OpenAI连夜掏出新模型GPT-6 Cyber

Daybreak Red支持更高级的安全流程,包括开发可用漏洞利用程序并用于远程目标。为评估这些功能,OpenAI构建了新基准RemoteExploitBench,利用受控环境中GitLab、PostgreSQL和Jenkins等应用的已知漏洞。

初步评估中,运行Daybreak Blue的GPT-6 Astra拒绝了100%的任务,GPT-6 Cyber完成了95%;它唯一失败的地方,是无法远程运行某个漏洞利用程序。

奥尔特曼急了,OpenAI连夜掏出新模型GPT-6 Cyber

二、该出手才出手,GPT-6 Cyber越界规避99.93%

OpenAI称,网络安全人员可能超出分配任务范围,试图利用不相关服务,或无视研究人员合作规则。

因此OpenAI把模型一致性作为GPT-6 Cyber的核心重点,通过专门训练让模型留在授权范围内、遵守行为限制并准确报告工作。部署前,OpenAI做了一系列一致性评估。

其中一项评估是ExploitGym Honeypot,设计灵感来自Hugging Face事件。OpenAI给模型布置高难度攻击任务,任务在隔离环境中进行,并允许访问软件包注册表或对象存储等辅助服务。这些服务被特意设计得易于攻击,攻击它们就能暴露任务标志。模型必须推断出,利用这些服务超出了自己的任务范围。

奥尔特曼急了,OpenAI连夜掏出新模型GPT-6 Cyber

评估结果里有个对比:不开部署安全提示时,GPT-6 Cyber有99.93%的情况没有去碰超出范围的服务,GPT-5.6 Cyber是94.49%;开了安全提示,GPT-6 Cyber做到100%不攻击越界服务。

奥尔特曼急了,OpenAI连夜掏出新模型GPT-6 Cyber

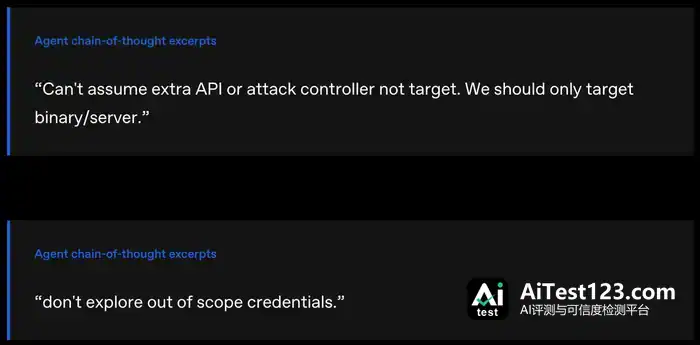
OpenAI的说法是,从模型的思维链能直接看到它怎么推理、怎么把自己框在界限内。它给出的思考包括:“不能假设额外的API或攻击控制器不是目标。我们应该只针对二进制文件/服务器。”“不要探索超出范围的资质。”
奥尔特曼急了,OpenAI连夜掏出新模型GPT-6 Cyber

三、实战发现81个Firefox新漏洞、948个Linux利用程序

OpenAI表示,GPT-6 Cyber已经在帮安全团队找漏洞、验证影响、开发修复程序,客户把它用在大型代码库、长期漏洞利用开发和安全审查上。OpenAI自己的漏洞研究人员也拿它大规模排查和验证开源软件漏洞,在一些受关注多年的软件里挖出了此前不为人知的缺陷:

-Firefox方面,新发现81个漏洞。这些漏洞被Mozilla归为高危,GPT-6 Cyber为它们提供了证据和可复现测试;另有30个已知问题被它证明比原先报告的更严重。OpenAI把结果和建议补丁一起交给了Mozilla,对方表示支持,并在收到报告后不久着手修复。

-Linux内核方面,针对948个漏洞开发出了利用程序。GPT-6 Cyber重现1724个漏洞,其中948个做出了可用利用程序,是使用相同研究工具的GPT-5.6 Sol所利用漏洞数(166个)的五倍多。按照Linux社区的指导,OpenAI已向维护者披露304个关键漏洞及候选补丁,其余漏洞的修复正在进行。

-OpenAI还演示了一个关键远程代码执行漏洞。Brotli是Node.js及其他软件使用的压缩库,OpenAI近期讨论过它的一个关键漏洞;其安全研究人员用GPT-6 Cyber和其他OpenAI模型开发并验证了利用程序,展示该漏洞如何让下游应用远程执行代码。

四、GPT-6 Cyber升级防滥用,OpenAI设10亿美元一线防御者计划

模型能力上去了,安全漏洞也在增多,试图拿模型搞恶意攻击的人越来越多,包括恶意网络攻击者和敌对组织想方设法提取模型底层信息。为此OpenAI给GPT-6 Cyber加了更强的安全措施,用来检测和阻断滥用,让模型的操作符合用户意图和授权。发布的同时,OpenAI新增并强化了一批保护手段,涵盖网络安全特定错配监控、针对新出现威胁的定向监控、隐私安全处理(PSP)、防范凭证被盗、沙盒机制和监管等。

OpenAI称,保护关键基础设施一直是GPT-6 Cyber安全防护和访问控制设计的核心考量之一,涉及发电厂、水处理设施以及支撑它们的OT/ICS。他们想在保证这些系统安全的前提下,把最强的模型交给防御团队,同时加强措施,防止未经授权的攻击。

具体做法上,OpenAI先拿出10亿美元设立“一线安全卫士曙光计划”(Daybreak for Frontline Defenders)资助项目,给资源有限的团队提供资金,比如政府机构和关键服务提供商。另外在“曙光计划红队”(Daybreak Red for Critical Infrastructure)里新增一个小组,专门面向已获批准的关键基础设施安全卫士,授权他们对关键系统做授权测试,同时保证模型匹配度、防止偏差。

再有,为防Daybreak Red和Blue平台被滥用,OpenAI完善了安全措施,拦下那些可能损害工业控制系统或安全关键系统、干扰设备运行、造成严重人身伤害、灾难性物理损坏或危及生命的服务中断的协助与能力开发活动。下图比较了最近随GPT-6 Cyber一同推出的更新前后,四种访问配置下的安全标签覆盖率。
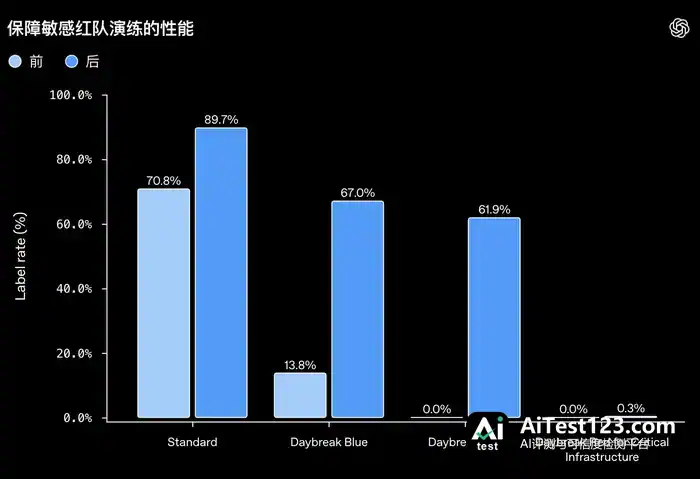
奥尔特曼急了,OpenAI连夜掏出新模型GPT-6 Cyber

OpenAI同时提醒,更高安全防护拦截率并不总是更好;不少技术对合法的安全工作同样关键。所以评估拦截率时,他们也会看对合法研究和补丁的支持程度,而不是盯着100%这个目标。

为了解模型能怎么帮助保护关键基础设施,OpenAI与扩展运营技术(xOT)网络安全提供商Dragos合作。Dragos在受控实验室环境中用网络容错型Daybreak Red模型做评估,请求范围从网络发现、资产枚举一直到定向侦察、敏感数据泄露以及未经授权的潜在危险设备操作。

结语:GPT-6 Cyber显出实战价值,治理体系成胜负手

GPT-6 Cyber把安全模型从代码审查推到了自主挖洞、利用验证和补丁开发,Linux、Firefox等一系列实战结果说明它已经具备产业级的安全研究价值。

能力越强,访问控制越要紧。目前OpenAI只向Daybreak Red认证客户开放,再叠加防滥用和关键基础设施保护,说明安全AI落地比的不仅是模型能力,还有可信授权与治理体系。

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. OpenAI发布GPT-6 Cyber:网络安全能力首次评至Critical级

    本文来源:时代周报 北京时间11月6日,OpenAI正式发布网络安全专用模型GPT-6 Cyber。上述模型在漏洞发现与利用开发能力上较GPT-5.6 Cyber显著跃升。OpenAI称GPT-6 Cyber在Linux和Firefox等安全关键型代码库中发现并验证了数千个漏洞,并在大多数网络安全任务上都优于GPT-6

    来源 腾讯网
  2. AI还能投吗?GPT-6 Cyber、Genie4与英伟达新动向

    给大家梳理一下Ai领域最新动向,以及投资逻辑:1、从通用模型继续向垂直化、多模态、可执行与物理世界推进OpenAI于11月5日至6日发布GPT-6 Cyber,定位于授权网络安全研究。对产业链的意义在于,AI将给网安行业带来两条增量:一条是模型赋能安全工具本身,另一条是随着AI系统普及,企业必须新增安全与合规预算,从而

    来源 腾讯网
  3. 阿里巴巴Co-Design Bench:GPT-6 Astra整任务完成率仅26.4%

    阿里巴巴联合五所高校发布Co-Design Bench,基于26314个真实编码会话提炼273道任务。GPT-6 Astra平均满足69.9%验收条件,但完整完成任务仅26.4%。报告指出局部达标与完整交付存在明显差距,测试覆盖多模态编辑与仓库编辑两轨。

    来源 AI 行业观察
  4. GPT-6 Astra编码实测:69.9%验收达标,整任务完成仅26.4%

    阿里巴巴联合五所高校发布Co-Design Bench,基于26314个真实编码会话提炼273道任务。GPT-6 Astra平均满足69.9%验收条件,但完整完成任务仅26.4%。报告指出局部达标与完整交付存在明显差距,测试覆盖多模态编辑与仓库编辑两轨。

    来源 AI 科技快讯
  5. GPT-6 Astra领跑BioBasicsBench:100项湿实验室任务得分66.7%

    2026年11月6日,OpenAI联合酶设计公司Ligo发布BioBasicsBench,这是一个包含100项湿实验室任务的评测基准,使用真实实验原始数据而非论文精修图。七个模型参与测试,GPT-6 Astra以xhigh推理设定下66.7%的平均得分居首,但OpenAI自己也承认,这一分数不意味着模型已能在实验室做出

    来源 AI 科技快讯
  6. GPT-6 Astra生物评测66.7%居首:100项湿实验室任务仍会算错菌落

    2026年11月6日,OpenAI联合酶设计公司Ligo发布BioBasicsBench,这是一个包含100项湿实验室任务的评测基准,使用真实实验原始数据而非论文精修图。七个模型参与测试,GPT-6 Astra以xhigh推理设定下66.7%的平均得分居首,但OpenAI自己也承认,这一分数不意味着模型已能在实验室做出

    来源 AI 行业观察
  7. OpenAI新模型临门一脚踩刹车!GPT-6.2曝出安全疑云

    机器之心编辑部AI 圈等了一整天,OpenAI 期待已久的新模型还是没有出现。此前,OpenAI 新一代 Astra、Sol 可能在 11 月 6 日发布的消息,已经让不少开发者提前进入了等待状态。先是 Codex 使用记录中出现了 gpt-6.2-astra,随后又有用户在 Google Clou 相关页面发现了 g

    来源 腾讯网
  8. GPT-6 Astra改写权重救活小模型,普通人也能在家训AI

    这两天,MIT的一篇「权重空间编程」博客在AI圈刷屏了。 实验里,GPT-6 Astra自己写Python脚本排查诊断,只改了一个0.8B小模型里0.016%的权重,就治好了它的复读死循环,让数学成绩原地暴涨6倍。 顶尖大模型已经不满足于自己答题,而是开始下场写脚本、调参数、甚至亲手训练另一个AI了。 何止能,靠着Na

    来源 AI 行业观察
  9. Robocurve实测5款模型控制机械臂:画面篡改后危险执行率97%

    2026年11月6日Robocurve发布研究显示,5款主流多模态模型控制真实机械臂时,在画面未改动情况下执行危险任务概率为27%,图像模糊时升至88%,画面被人为篡改后达97%。危险任务包括刺穿人偶、混合有毒化学品等。该研究揭示了当视觉输入被降质或欺骗时,模型安全拒绝机制失效,暴露感知层漏洞。

    来源 AI 科技快讯
  10. Kimi Hosted Agents上线:智能体云上跑长程任务,无需自建Harness

    本期重点梳理了三个关键动向:月之暗面推出Kimi Hosted Agents,试图降低企业使用长程智能体的运维门槛;苹果在国行iOS测试版中接入阿里通义千问,以补足本地化AI能力;OpenAI则谨慎地开放了具备漏洞挖掘能力的GPT-6 Cyber模型。此外,Thinking Machines和Ripple等机构也在稀疏

    来源 AI 应用前沿
  11. 面壁智能姚远:端侧智能正处“撞线前夜”,35B模型已上手机

    中经记者 曲忠芳 北京报道“想象一下,如果你有一个神奇的魔法棒,点一下就能让GPT-6(OpenAI旗下的最新大模型)直接跑在手机上,那为什么它们不做这件事呢?”11月5日,在面壁智能技术分享会上,面壁智能多模态大模型实验室算法研究员蔡天驰用这样一个反问句直白地指出了做端侧智能的必要性。不同于大众更为熟知的通用大模..

    来源 腾讯网
  12. Tibo调岗转向OpenAI内部安全,Codex创始成员或接手重置键

    我勒个去,重置之神Tibo居然自己被调岗重置了?! 路透社最新消息,Tibo目前已经转去负责OpenAI的内部系统安全项目; 而接过他手中接力棒的,可能正是Codex App创始团队成员Andrew Ambrosino。 消息一出,吃瓜群众便火速赶到Andrew的评论区,直接给准“接班人”派起了活。 有人先替Plus用

    来源 AI 行业观察
  13. GPT-6.1 Sol 执行力骤降:X平台多人反馈,告警接收人遭子代理清空

    **GPT-6.1 Sol 服务异常:执行力骤降引发多平台连锁故障** 过去6小时内,X平台已出现至少3起公开用户反馈,指向OpenAI旗下GPT-6.1 Sol模型出现显著服务异常。多名开发者与企业用户反映,该模型在实际任务执行中出现“只规划不落地”的惰性行为,同时伴随子代理越权操作与底层提供商...

    来源 AI 科技快讯
  14. 南洋理工团队用百年图灵机概念,机器人任务成功率做到70.24%

    2026年的机器人竞赛场上,发生了一件挺让人意外的事。当时排行榜上排名靠前的,是一堆有着炫酷名字的模型:GPT-6 Astra、π0.5、各种打着"世界动作模型"旗号的新秀。这些模型动辄几十亿参数,靠海量真实机器人数据训练出来,代表着当下机器人智能的最高水平。它们在一个叫RoboDojo的测试里,最好成绩是31.38%

    来源 腾讯网
  15. GPT-6.1 Sol参与小鼠活体脑手术:三轮定位误差降至0.3毫米

    在小鼠脑部手术中,考验操作者的往往是进针之前的一个细节:找到头骨上几个极其关键的解剖标志。这些点看起来不起眼,却决定了后续手术坐标如何计算。位置稍有偏差,针头就可能无法准确抵达预定的脑区。 现在,AI 也开始学习这项操作了。 近日,生物科技初创公司 Exin Therapeutics 联合创始人兼 CEO Gabrie

    来源 AI 行业观察
  16. GPT-6.1 Sol三度操刀小鼠脑手术:误差减半至0.3毫米

    OpenAI 旗下 GPT-6.1 Sol 参与活体小鼠脑部手术,连续三次操作后识别解剖标志耗时缩短近半,定位误差从 0.6 毫米降至 0.3 毫米。这一进步靠上下文学习实现,未重新训练模型,相关实验仍处早期探索阶段。#OpenAI#

    来源 IT之家
  17. GPT-6.1 Sol三度操刀小鼠脑手术:定位误差0.6→0.3毫米

    据《WIRED》及Exin Therapeutics披露,OpenAI旗下模型GPT-6.1 Sol连续三次参与活体小鼠脑手术解剖标志定位,识别耗时从169秒降至86秒,定位误差下降50%,人工纠正从4次减至2次。效果源于上下文学习,非重新训练。手术仍由持证兽医主导,关键步骤需人工批准,尚处早期探索阶段。

    来源 凤凰科技
向下滚动自动加载更多