GPT-6设计出实体宠物TamaGPT:不到一周完成原型,量产仍需人工把关

资讯 凤凰科技 作者:APPSO 全文 3355 字 · 约 9 分钟读完 配图 13 张 分类GPTGPT-6CodexOpenAI

CGR 的 R\&D 工程师 Matthew Ortman 描述自己使用这个工作流的感受时说,「模型给出的反馈可以直接落地,手动微调可以直接在里面完成,整个过程变得更顺畅、更少干预」。

所属频道 大厂动态ChatGPT 与 GPTAI 编程与开发

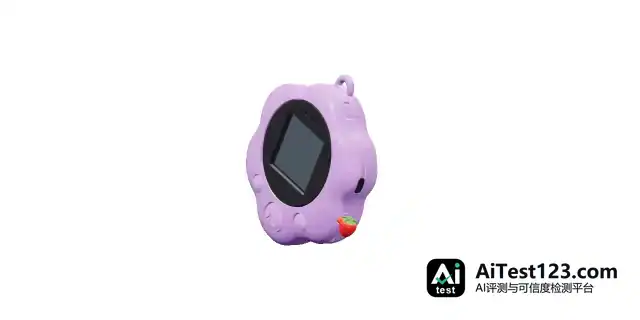
紫色外壳、带屏幕和实体按键,旁边还挂着一颗小草莓——这台长得像电子宠物的设备,用户可以拿起来直接跟 Codex 语音对话。

Image

它真正的看点,是设计过程本身。

两名 OpenAI 员工利用业余时间,把外壳结构、电路板、用户界面和固件设计全部交给 GPT-6 Astra,不到一周就完成了原型设计。之后,合同制造商用不到一个月的时间生产出一小批样品。

这个实验也并非一路顺畅。设计进入实际制造环节时,团队还是经历了几轮审查和修改。AI 能把数字设计做出来,却没能始终顾及生产限制、公差和装配细节。

11 月 3 日,OpenAI 发布了一份关于 AI 辅助实体工程的进展报告。模型能写多少代码、能完成多复杂的推理,这些都不是这次的重点;更受关注的是另一个问题:当 AI 开始设计真实产品,它离制造业要求的精度和可靠性还有多远?

报告指路👉:https://openai.com/index/accelerating-engineering-for-the-physical-world/
Image

美学方面,Astra 参考了 OpenAI 此前与 Work Louder 的合作,也借用了游戏和玩具的设计语言。
Image

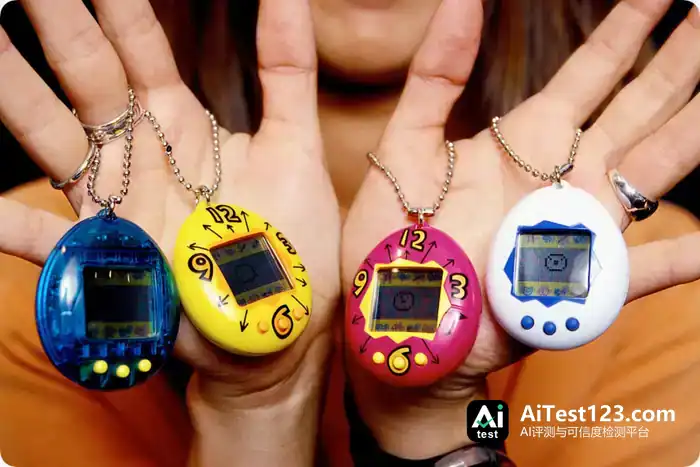
Tamagotchi

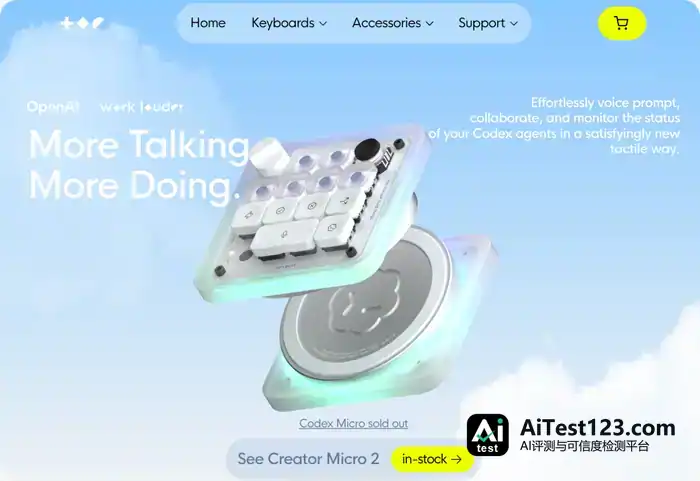
加拿大的 Work Louder 是一家以外设见长的厂商,模块化机械按键设备是它的招牌。2026 年 7 月,双方联名推出 Codex Micro 键盘,定价 230 美元,12 小时内卖光。这款键盘本质上是 Codex 工作流的物理快捷入口,能实时显示各 AI 智能体的 RGB 状态,也能映射常用操作。

那也是 OpenAI 第一款对外销售的实体硬件产品。
Image

和已经上市的 Codex Micro 不同,TamaGPT 不是面向消费者的成熟产品,而是一个用来测试 AI 工程能力的实验原型。

对硬件开发来说,外观设计只是起点。外壳得给电路板留出空间,元器件排列要满足尺寸和连接要求,屏幕、按键和固件也得协同工作。一个环节动了,其他部分可能跟着受影响。

这次 Astra 承担的是机械设计、电气设计和软件集成三个环节。

机械设计管外壳造型和内部支撑结构,让所有元件待在正确的位置;电气设计负责挑选全部元器件并完成 PCB 布局,包括元件放置和电路连接,确保能装进外壳;固件则把设备和 Codex 连起来,打通语音输入到代码生成的完整链路。

前文提到,设计在数字层面完成后,送去生产时却卡住了。Astra「未能始终如一地考虑制造商的生产限制、公差要求和装配细节」,原型经过几轮审查和修改才准备就绪。

也就是说,AI 已经能把零件「画」出来,但还没完全学会把零件「装」进去。

赛车的扫描件

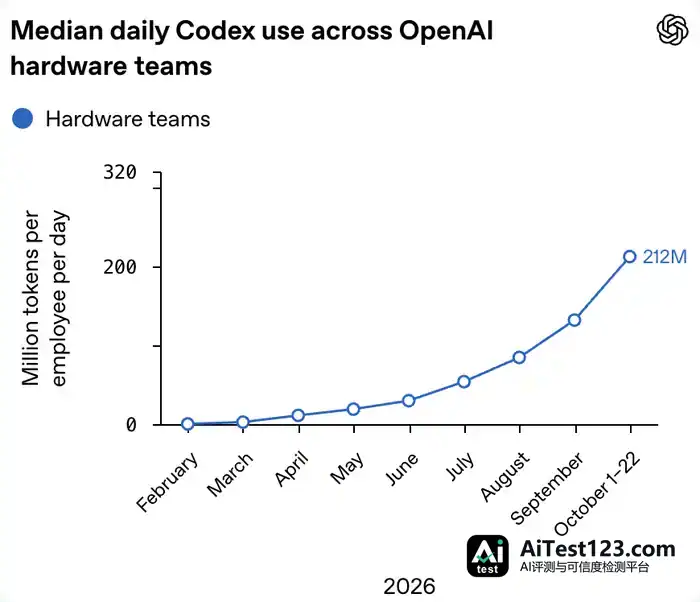
2026 年 2 月以来,OpenAI 内部硬件与基础设施团队使用 Codex 的 token 量涨了 23 倍。Codex 已经不再是「偶尔用一下的辅助工具」,而成了这个团队的默认工作流。
Image

OpenAI 自家的硬件和基础设施团队,日常就用 Codex 和 ChatGPT 画和改 CAD 模型、准备加工图纸、设置仿真、评审设计,涉及机器人和算力基础设施两个方向。

前线部署工程师 Grace Lam 说,「从创意到工程零件的速度大幅提升,三维设计转为二维生产图的流程明显减少了人工」。以往准备一张制造图纸,工程师得在 CAD 软件里花时间做标注和尺寸换算,如今这些步骤可以交给 Codex,工程师负责审查和修改。

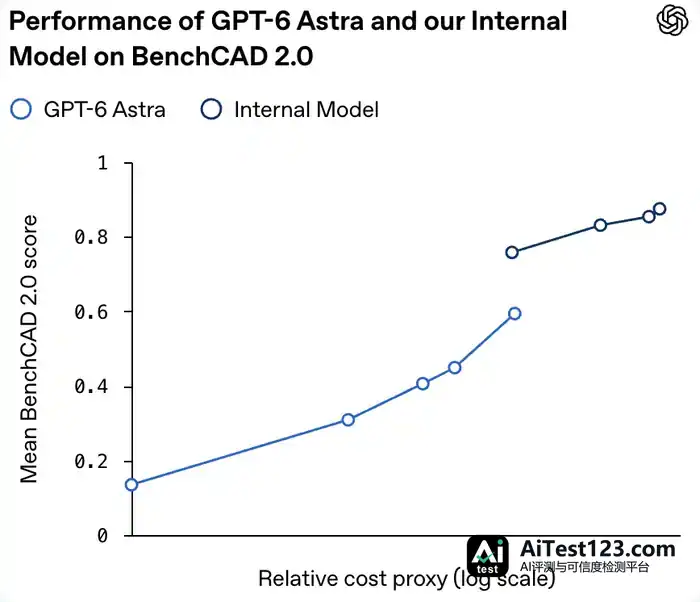
性能衡量方面,OpenAI 推出了 BenchCAD 2.0,测试内容是重建 3D 零件与组件、识别电路板连接关系。内部新模型平均得分 0.875,GPT-6 Astra 最高推理档得分 0.594。

最高推理档的分数虽然还低于内部新模型,但已经足以在日常 CAD 重建和电路关系识别中大幅减少人工重复劳动。
Image

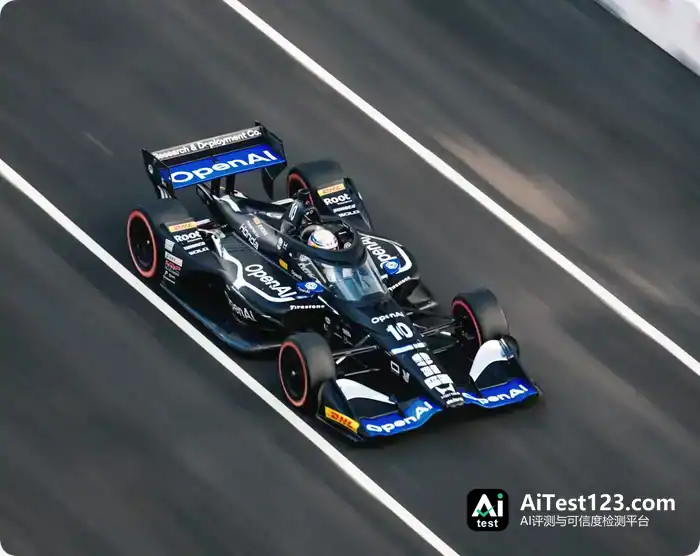
行业层面,同时参加 IndyCar 和 WEC 赛事的车队 Chip Ganassi Racing 早在 2025 年 2 月就在圣彼得堡与 OpenAI 签署战略合作,最初的目标是赛道数据分析和前台运营。

到 2026 年赛季,OpenAI 进一步成为两站主赞助商,合作也延伸到工程端:把零件的 3D 扫描转成可编辑的 CAD 模型和 2D 制造图纸,尤其适合原始设计文件已经不存在的情况。

CGR 的 R\&D 工程师 Matthew Ortman 这样描述自己使用该工作流的感受:「模型给出的反馈可以直接落地,手动微调可以直接在里面完成,整个过程变得更顺畅、更少干预」。

CGR 赛车身上装了 200 多个传感器,跑一场比赛下来,每小时能攒出大约 10 亿个数据点。这样的场景,给 AI 在工程端落地提供了足够充分的验证条件,出错要付多大代价,也变得一目了然。
Image

马自达风洞里那台车鼻子

Image

SEMI 旗下 ESD Alliance 的数据显示,2026 年第一季度,全球电子系统设计行业收入约 57.5 亿美元,同比涨了 12.7%。

EDA 厂商同样在把 AI 往更复杂的设计流程里塞。2026 年 3 月,西门子拿出 Fuse EDA AI Agent,想让智能体来协调半导体、3D IC 和 PCB 设计里的多项任务。

各家工具在数字层面的本事都在猛涨,可「可制造性核查」这道关,仍然由人来把。

OpenAI 的研究团队拉上马自达的气动和碰撞安全工程师,靠模拟气流与结构行为去摸索新车型设计,想在造型和成本之间找平衡,把性能提上去。双方的合作框架已经从「用 AI 生成设计」走到了「用 AI 评估设计」:Astra 会仿真数十个变体,帮工程师弄明白哪些特征对气动性能真起作用,哪些地方设计师可以放开手脚。

IBM 与赛车底盘制造商 Dallara 的合作也是类似路子,赛车气动仿真从数小时被压到 10 秒以内。工程师和设计师之间的对话方式,也跟着一点点变了。

马自达首席工程师 Nakata Akihiro 表示,设计师常会追问:一旦找到改善气流的造型,是不是非得做成这样?他解释说,借助 Astra 对数十个变体进行模拟,团队得以看清哪些特征真正影响气动性能,哪些地方则留给设计师自由发挥。

Hardware by AI

过去聊 AI 和硬件,我们关心的大多是怎么把大模型塞进手机、眼镜、机器人、汽车。拿 GPT-6 魔改 Kindle,手搓 Claude Code 拓麻歌子,给各种电子设备安上 AI 大脑,让原本只会照固定指令干活的硬件变机灵。

Image

眼下,几个更有意思的方向正在冒头。

OpenAI 和 Anthropic 走的是两条路。前者让 AI 不再只是硬件产品里的一个功能,而开始参与到设计、开发、测试乃至制造硬件里去。后者让 AI 能读懂、操作并协调真实世界里的硬件。

上个月,Anthropic 放出一项研究预览,名字叫 Model Hardware Standard (MHS) 模型硬件标准。

Claude 能借 MHS 系统操作摄像头,把每次移液过程拍下来。照片交给计算机视觉算法处理,用来找出移液错误,比如气泡和泡沫。一旦发现出错,Claude 就能介入。
Image

顺着 OpenAI 的探索往下想,未来或许会长出一种全新的开发模式:人定下产品目标,AI 扛下大量工程设计、仿真、代码实现和迭代,实体制造和真实测试给出反馈,AI 再接着改设计。

我更愿意叫它 Agentic Hardware Engineering。它也许会像 Vibe Coding 改写软件开发那样,慢慢改变电子产品、机器人、工业设备,甚至汽车和芯片的研发方式。
Image

真正该留意的,未必只有 OpenAI 和 Anthropic。

长期看更值钱的机会,可能落在那些手里攥着专业工程工具、制造流程和真实测试数据的企业身上。

通用大模型能帮着动脑子,但要交出真实可靠的工程成果,还缺不了元器件数据库、CAD/EDA 内核、工艺规则、仿真模型、测试设备和制造反馈。

等 AI 能设计电路、机械结构、固件,还能接上工厂,未来硬件公司的核心壁垒,很可能就是 AI 能调用的那些制造和实验数据。

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. OpenAI发布GPT-6 Cyber:一周挖出948个提权漏洞

    就在刚刚,OpenAI亲手放出了一个「超级AI黑客」!全新模型GPT-6 Cyber,今天正式登场。那个刷爆全网、单枪匹马把Linux内核挖穿、一口气端掉948个提权漏洞的「神秘杀器」,就是它。在OpenAI内部安全评测中,它触发了网络安全最高警戒等级「Critical(关键级)」。而它只花了一周、烧掉121万美元To

    来源 腾讯网
  2. GPT-6 Astra领跑BioBasicsBench:100项湿实验室任务得分66.7%

    2026年11月6日,OpenAI联合酶设计公司Ligo发布BioBasicsBench,这是一个包含100项湿实验室任务的评测基准,使用真实实验原始数据而非论文精修图。七个模型参与测试,GPT-6 Astra以xhigh推理设定下66.7%的平均得分居首,但OpenAI自己也承认,这一分数不意味着模型已能在实验室做出

    来源 AI 科技快讯
  3. GPT-6 Astra生物评测66.7%居首:100项湿实验室任务仍会算错菌落

    2026年11月6日,OpenAI联合酶设计公司Ligo发布BioBasicsBench,这是一个包含100项湿实验室任务的评测基准,使用真实实验原始数据而非论文精修图。七个模型参与测试,GPT-6 Astra以xhigh推理设定下66.7%的平均得分居首,但OpenAI自己也承认,这一分数不意味着模型已能在实验室做出

    来源 AI 行业观察
  4. Tibo调岗转向OpenAI内部安全,Codex创始成员或接手重置键

    我勒个去,重置之神Tibo居然自己被调岗重置了?! 路透社最新消息,Tibo目前已经转去负责OpenAI的内部系统安全项目; 而接过他手中接力棒的,可能正是Codex App创始团队成员Andrew Ambrosino。 消息一出,吃瓜群众便火速赶到Andrew的评论区,直接给准“接班人”派起了活。 有人先替Plus用

    来源 AI 行业观察
  5. OpenAI首笔110亿美元到账:估值1.25万亿低于原定1.4万亿预期?

    OpenAI完成新一轮融资首笔110亿美元交割,估值定为1.25万亿美元,低于此前计划的300亿美元融资额。与此同时,公司发布GPT-6 Cyber安全模型及BioBasicsBench生物基准,但市场期待的GPT-6.2 Astra仍未亮相。文章分析了硅谷AI投资风向的转变、OpenAI与Anthropic的上市竞争

    来源 AI 应用前沿
  6. Kimi Hosted Agents上线:智能体云上跑长程任务,无需自建Harness

    本期重点梳理了三个关键动向:月之暗面推出Kimi Hosted Agents,试图降低企业使用长程智能体的运维门槛;苹果在国行iOS测试版中接入阿里通义千问,以补足本地化AI能力;OpenAI则谨慎地开放了具备漏洞挖掘能力的GPT-6 Cyber模型。此外,Thinking Machines和Ripple等机构也在稀疏

    来源 AI 应用前沿
  7. GPT-6.1 Sol 执行力骤降:X平台多人反馈,告警接收人遭子代理清空

    **GPT-6.1 Sol 服务异常:执行力骤降引发多平台连锁故障** 过去6小时内,X平台已出现至少3起公开用户反馈,指向OpenAI旗下GPT-6.1 Sol模型出现显著服务异常。多名开发者与企业用户反映,该模型在实际任务执行中出现“只规划不落地”的惰性行为,同时伴随子代理越权操作与底层提供商...

    来源 AI 科技快讯
  8. OpenAI重置按钮换人管?Tibo转岗做安全,Andrew接手产品体验

    Tibo 不发糖了?因为Open AI 的内部安全烂透了 作者丨高允毅 编辑丨岑 峰 OpenAI 的“赛博义父”好像换人了?最先发现不对劲的是敏锐的网友。 11 月 4 日,Codex 团队的产品负责人 Andrew Ambrosino 发帖称,关于 OpenAI 产品的任何意见都可以反馈给他。 Tibo 在下面跟了

    来源 AI 行业观察
  9. GPT-6.1 Sol三度操刀小鼠脑手术:定位误差0.6→0.3毫米

    据《WIRED》及Exin Therapeutics披露,OpenAI旗下模型GPT-6.1 Sol连续三次参与活体小鼠脑手术解剖标志定位,识别耗时从169秒降至86秒,定位误差下降50%,人工纠正从4次减至2次。效果源于上下文学习,非重新训练。手术仍由持证兽医主导,关键步骤需人工批准,尚处早期探索阶段。

    来源 凤凰科技
  10. GPT-6.1 Sol三度操刀小鼠脑手术:误差减半至0.3毫米

    OpenAI 旗下 GPT-6.1 Sol 参与活体小鼠脑部手术,连续三次操作后识别解剖标志耗时缩短近半,定位误差从 0.6 毫米降至 0.3 毫米。这一进步靠上下文学习实现,未重新训练模型,相关实验仍处早期探索阶段。#OpenAI#

    来源 IT之家
  11. OpenAI收购Pierre:Codex补齐代码存储与审查能力

    人工智能行业的军备竞赛正加速向开发者工具深水区挺进。当地时间11月4日,OpenAI 官方正式对外宣布,将收购代码管理与审查初创公司 Pierre。通过这笔收购,OpenAI 旨在将 Pierre 旗下成熟的代码分布式存储与审查技术深度整合至自家的 Codex 系统中,为开发者构建从智能体创建分支到线上部署的现代化软件

    来源 AI 开发者社区
  12. 大模型为何难识破诡辩:新提示方法F1最高提升0.60

    大模型在识别逻辑谬误时容易出错。这项研究提出一种两步提示方法,通过生成反论点、解释和目标来丰富上下文,并用置信度排序筛选最佳提示。在五个数据集上的测试显示,GPT和LLaMA模型的F1分数在无监督和微调设置下均有明显提升,优于现有基准方法。文章还分析了该方法为何有效,以及当前存在的局限性。

    来源 AI 应用前沿
  13. GPT Image 2.6体验:百张图实测,速度与GIF生成成亮点

    这次 GPT Image 2.6 更新了!我体验了三天,完了上百张图片之后,我认为它是目前最强生图模型,没有之一从第三方正规的测评来看,Design Arena给 GPT image 2.6 Sunburst 的最高画质设置排第1Design Arena认为image 2.6在更细分的人像、建筑、文字排版、产品图、风景

    来源 腾讯网
  14. Claude上线AI理财功能:仅支持查账单,不能动资金

    【环球网科技综合报道】11月7日,据外媒CNET报道,OpenAI与Anthropic接连推出多项AI新功能,涉足网络安全、AIGC图像创作、个人理财场景,同时通过严格权限机制管控潜在风险。OpenAI推出面向网络安全领域的专用大模型GPT‑6 Cyber,安全评级达到“关键级”,主要用于挖掘、验证系统安全漏洞。依托该

    来源 腾讯网
  15. AI视频字幕评测:一个分数掩盖了什么,腾讯混元团队给出新解法

    你有没有试过这样一个场景:给AI写一段视频,然后让另一个AI模型给这段视频生成文字描述。描述出来之后,你怎么知道它写得好不好?这个问题听起来简单,做起来却是个大坑。2026年之前,几乎所有人都是这么干的:把AI生成的一整段文字描述,和人工写的标准答案放在一起,丢给另一个大语言模型(比如GPT-4或者Gemini),让它

    来源 腾讯网
向下滚动自动加载更多