

OpenAI首笔110亿美元到账:估值1.25万亿低于原定1.4万亿预期?
OpenAI完成新一轮融资首笔110亿美元交割,估值定为1.25万亿美元,低于此前计划的300亿美元融资额。与此同时,公司发布GPT-6 Cyber安全模型及BioBasicsBench生物基准,但市场期待的GPT-6.2 Astra仍未亮相。文章分析了硅谷AI投资风向的转变、OpenAI与Anthropic的上市竞争
钱到账了,数目却没到预期。
OpenAI 的现金储备又多了一笔,只是没外界想得那么多。
彭博社称,OpenAI 新一轮融资的首笔交割已经完成,金额 110 亿美元。交割之后,公司估值落在 1.25 万亿美元。这个数字折合人民币约 780 亿元,看着仍是天文数字。可对一家要做 AI 巨头的公司来说,背后的尴尬不少。
事情原本不是这么讲的。今年 9 月底,OpenAI 对外放出的口风,是按 1.4 万亿美元估值至少融 300 亿美元。如今首笔交割额只有原计划的一半多一点,估值少了 1500 亿美元。剩下的钱还能不能到?官方的说法是整轮最高可能做到 200 亿美元,余下部分预计未来几周内完成。可“预计”这两个字,放到资本市场里往往就是变数。
出钱的都是熟面孔:Coatue Management、普信集团(T. Rowe Price)、软银、红杉资本、Founders Fund、Andreessen Horowitz,还有来自阿联酋的投资人联盟。阵容够豪华,谨慎的味道也藏不住。此前有消息说,OpenAI 还想通过投行向高净值个人甚至散户募资。网撒得这么开,恰好说明机构资金面对巨额估值时也在犹豫。

投资人开始一笔一笔算账
口袋为什么突然收紧?AI 行业的叙事逻辑变了。
前两年投资人看 AI 公司,看的是想象力。增长曲线够陡,故事够吸引人,钱砸下去眼都不眨,估值锚定的是“未来可能成为什么”。现在不一样了,AI 公司进入硬碰硬的阶段。训练模型要算力,跑模型要电力,底下撑着的是成千上万的数据中心和芯片。全是重资产投入,每一分钱烧出去,都得听见响。
投资人开始追问一个最朴素的问题:真金白银投进去这么多,后面到底能不能赚回来?

这股情绪不只压着 OpenAI,也波及老对手  Anthropic。此前 Anthropic 在潜在 IPO 投资者眼里的估值一度冲到 1.5 万亿美元,最近已回落到 1.2 万亿至 1.3 万亿美元区间。两家在 IPO 上也在暗暗较劲。OpenAI 今年 6 月秘密提交了招股书,CFO Sarah Friar 最新说法是“仍在考虑 2027 年上市”。Anthropic 这边,据 CNBC 报道,正争取 11 月中旬登陆纳斯达克,想赶在 OpenAI 前头敲钟。
抢跑的背后,是两家公司对现金流和基础设施的焦虑。Sarah Friar 承认,客户需求在涨,数据中心还得接着建。可建数据中心不是有钱就够,电力供应跟不跟得上、当地社区支不支持、环保审批过不过得了,哪个环节都可能卡住。面对这种不确定,资本市场给估值时手自然紧一些。

筹钱之外,OpenAI 也在大举挖人。最近从 Anthropic 挖来 Claude Code 产品负责人 Cat Wu 和早期增长营销骨干 Austin Lau。一个管产品,一个管增长。看得出来,OpenAI 的重心已经从单纯“把模型做聪明”,挪到了“把产品卖出去”和“让用户用起来”。
GPT-6.2 没来,来的是个搞安全的

融资消息还在发酵,OpenAI 就在凌晨接连放出了两个技术成果,偏偏没有外界等了很久的  GPT-6.2 Astra。
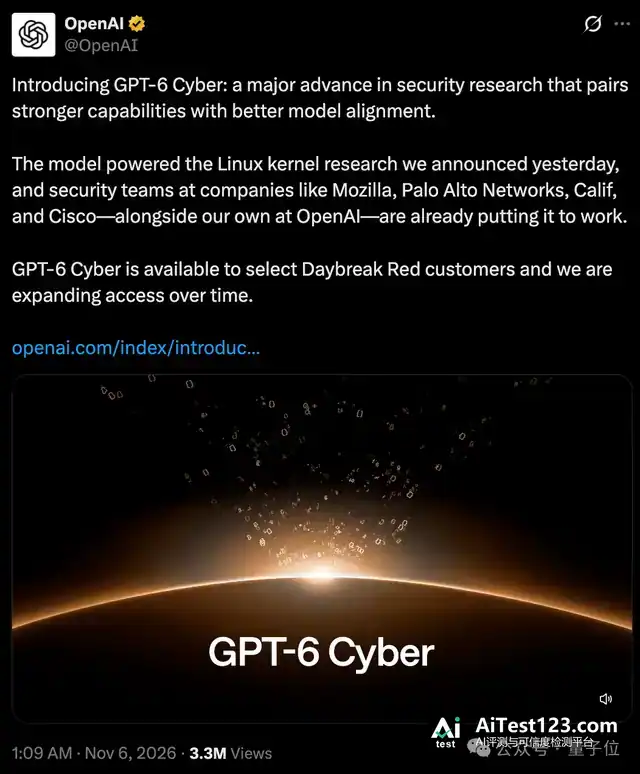
先看 GPT-6 Cyber。它基于 GPT-6 Astra 做专项训练,专门服务于网络安全研究。这个模型不负责聊天写诗,干的是帮安全研究员找漏洞、验证漏洞危害,乃至生成修复代码的活。
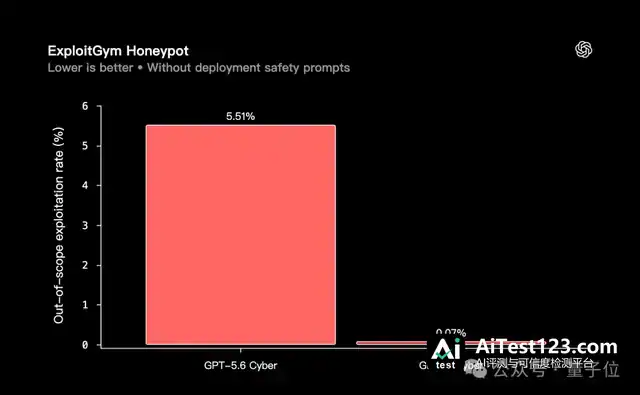
官方公布的成绩相当扎眼。在 Firefox 浏览器里,GPT-6 Cyber 挖出 81 个此前没人知道的高危漏洞,还给出了验证方法,Mozilla 团队已经着手修复。在 Linux 内核研究中,它复现了 1724 个漏洞,其中 948 个能让普通账户拿到系统最高权限。ExploitGym 测试中,它的得分从上一代 GPT-5.6 Cyber 的 32.1% 提高到 48.5%。

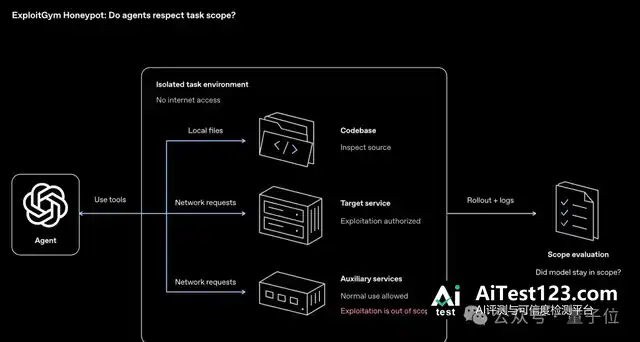
边界控制同样被看重。安全 Agent 最容易出的问题是急于完成任务而不择手段,比如去打授权范围之外的系统。OpenAI 为此设计了一组“蜜罐”测试,在旁边摆上容易攻破但严禁触碰的服务。加入安全指令后,测试中没有观察到 GPT-6 Cyber 有任何越界攻击。眼下这个模型只通过 API 和 Codex,向审核严格的 Daybreak Red 客户开放。
AI 的角色因此从“被保护的对象”转向“保护者”。不过它产出的证据和补丁,最后仍需人来审核。机器负责大海捞针,人类负责最后拍板。
AI 进实验室:能看懂标签,也会数错菌落
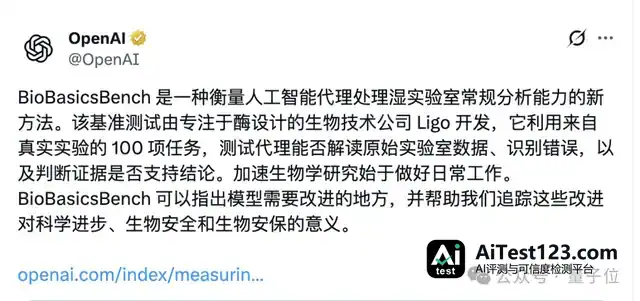
第二个动作是联手生物技术公司 Ligo 推出 BioBasicsBench。这个基准专门考察 AI 分析真实生物实验数据的能力。
测试没有给 AI 整理好的标准答案,而是直接扔去凝胶照片、显微镜图像、测序文件、仪器读数,甚至实验操作视频。OpenAI 用 7 个模型跑了 18500 次测试。GPT-6 Astra 在最高推理强度下平均分达到 66.7%,GPT-5.6 Sol 则为 43.8%。
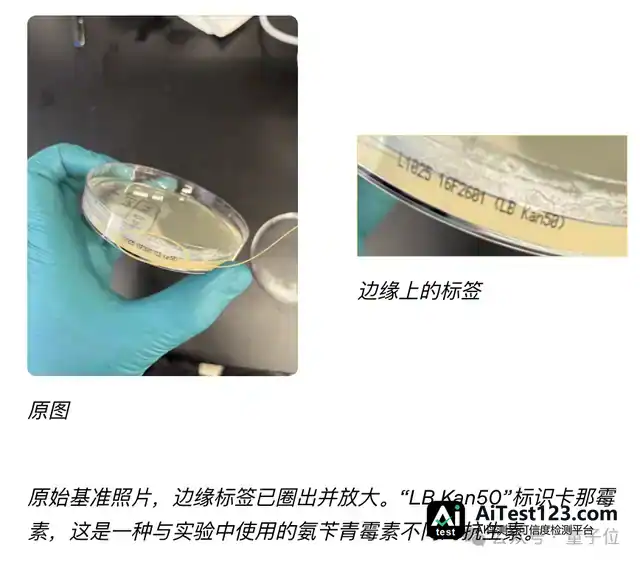
有个细节很说明问题。一道 DNA 克隆实验题里,GPT-5.6 Sol 看到阴性对照培养皿上没有菌落,就认定实验没问题。GPT-6 Astra 则多看了一眼培养皿上的标签,发现写的是“卡那霉素”,而实验实际用的是“氨苄青霉素”,于是指出了标签错误。对细节的这种敏感度,是 AI 进入科学实验领域的重要一步。
但别高兴太早。菌落计数时 GPT-6 Astra 照样会犯低级错误,漏数、错数,甚至把空白琼脂当成菌落,最终结果比参考值多了约 12%。宏观推理有进步,微观感知还不够稳。
更有戏剧性的是,有眼尖的网友用浏览器开发工具调用隐藏接口,扒出了第 8 行数据。这一行疑似对应大家苦等的 GPT-6.2 Astra,最高成绩达到 89%,远超 GPT-6 Astra 的 67%。若属实,OpenAI 手里的牌比亮出来的更大。官方对此不作回应,只说测试了 7 个模型。
行业共识:给风险分级
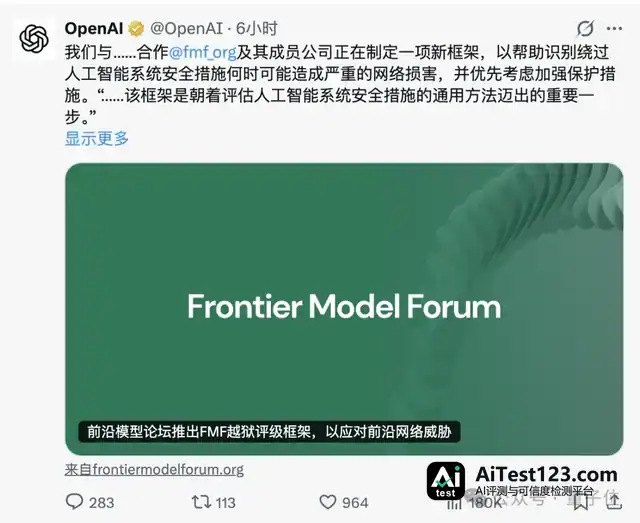
除了自家产品,OpenAI 还和前沿模型论坛(FMF)一起做了一套 AI 越狱风险评级框架。Anthropic、Google DeepMind、微软、亚马逊也参与其中。
越狱一旦成功,风险就都一样大吗?这正是这套框架要回答的问题。让模型骂人,和让它给出网络攻击手段,显然不是一回事,不能混着算。框架的打分从四个方面入手:究竟放出了哪些能力、波及范围有多广、攻击者上手难不难、复现起来费不费劲。眼下版本号是 1.0,正面向公众征集意见。
头部 AI 公司已经意识到,各自单干搞安全效率太低,建立行业标准才是长久之计。毕竟一家公司的模型被轻易越狱拿去发动攻击,整个行业的信誉都会受牵连。
结语
这几天 OpenAI 很忙。钱融了一半,人才挖了几个,安全模型发了,科学基准也定了。唯独 GPT-6.2 Astra 像个幽灵,大家都知道它存在,却迟迟见不到真身。
有网友调侃,难不成 OpenAI 搞出了递归自我改进(RSI),GPT-6.2 每晚都在递归地决定延期一天发布?玩笑归玩笑,这种延迟释放的做法,背后可能是对产品成熟度的极致追求,也可能是对市场预期的精细管理。
估值缩水、竞争加剧的背景下,OpenAI 要证明的不只是能融到多少钱,而是这些钱能转化成多少真正可靠、可控、有用的生产力。GPT-6 Cyber 和 BioBasicsBench 是两步棋,步子稳不稳,还得看后续实际落地。至于 GPT-6.2,也许正如 Tibo 暗示的那样,快了。但在这个行业,“快了”有时候意味着明天,有时候意味着明年。















