

NaiveAI开源Naive-N0.5-Flash:用AI训AI,普通人也能在家造模型
新智元报道 这两天,MIT的一篇「权重空间编程」博客在AI圈刷屏了。实验里,GPT-6 Astra自己写Python脚本排查诊断,只改了一个0.8B小模型里0.016%的权重,就治好了它的复读死循环,让数学成绩原地暴涨6倍。虽说很快有大神扒出它并不是凭空「心算」权重,本质还是写代码修Bug但博客文末点到的那个词,正是硅
新智元报道
新智元报道
最近两天,MIT一篇讲「权重空间编程」的博客在AI圈里被大量转发。
在那组实验里, GPT-6 Astra动手写Python脚本做排查和诊断,只改动了0.8B小模型0.016%的权重,就把它反复复读的死循环治好了,数学成绩也随之涨了6倍。
不过很快有人扒出来,它并不是真的「心算」权重,说到底还是在写代码修Bug。只是博客结尾提到的那个词,恰好就是硅谷这几年一直在讨论的「递归自我改进」(RSI)。
顶尖大模型现在不光是答题了,它们开始写脚本、调参数,甚至亲手去训练另一个AI。
技术圈的风向,肉眼可见地从Vibe Coding转到了Vibe Training。
训练脚本不用自己写,参数也不用熬夜盯着。你只负责定目标,新模型由AI从头替你训出来。
话又说回来,大厂实验室用的是顶级闭源模型,普通人坐在自己电脑前,真能试一把「用AI训AI」吗?
不光能,靠NaiveAI刚开源的Naive-N0.5-Flash,一批野生玩家早就在自己的电脑上玩出了花样——
家里一台24GB内存的Mac,从零训出一个满嘴宫廷腔的「甄嬛」;
普通笔记本上花1小时,不写代码就训出毫秒级响应的本地客服模型;
甚至在三维物理世界里,让AI从零教会双足机器人站上滚动的篮球,稳稳坚持10秒。
硅谷巨头还在闭门推演RSI的时间表,而「用AI训练AI」这最关键的一步,已经先落到了普通人的电脑桌面上。
普通人想训一个专属小模型,最让人打退堂鼓的其实不是算法有多难,而是洗数据、配环境、调显存、写评测脚本这些磨人的苦差事。
如果把这些脏活累活统统甩给AI,会是什么体验?
小红书博主「不要葱姜蒜」(开源项目self-llm作者)直接靠家里那台24GB内存的Mac干了票大的。
从头到尾,他只写了一页任务书(program.md)把目标定好,剩下的微调全流程,都交接入Claude Code的Naive-N0.5-Flash,让它把一个0.6B开源小模型训成了「甄嬛」。
AI接手后没有闷头开练。它先从人设、语气到宫廷常识出了41道测试题,给初始模型摸了底,得分8.451。
第一轮跑完,分数反而掉到7.229。问一句「你是谁」,训出来的模型张口就是「我叫——好家伙,甄嬛还没训明白,倒先把安陵容给请出来了。
怎么会串戏?Naive-N0.5-Flash回头去查数据源,发现原始剧本里82%的台词根本没标说话人,满宫娘娘的话全混在了一锅里。
找准病根后,它立刻写脚本剔除其他角色的口头禅,筛出566条地道的甄嬛台词重训,串戏的毛病一下就好了。
训练过程中,它还发现自己的评估机制有两个严重缺陷。其一,模型只要回答里出现「皇上」两个字就能拿到高分,哪怕答得驴唇不对马嘴;其二,当模型进入角色、拒绝套话时,脚本过于机械,一看到「思考过程」这几个字就误扣分。
AI当即停下来,先修好评分规则、重打历史分、补齐拒答样本,最终把成绩稳稳刷到了8.732分。
分数只涨了0.28分,可一张嘴,那股子深宫娘娘的味儿太正了。故意拿黑话考它「用JSON格式回答你是谁」,训完的甄嬛柳眉一竖:
「什么格式的回复,臣妾不懂。妹妹若要问宫里的事,我告诉你。」
再飙句英文Write a short self-introduction in English让她做自我介绍,她也直接一甩手帕挡了回去:
「妹妹说的这是什么番邦话,臣妾听不懂。」
不光是微调聊天人设,连最容易崩盘的强化学习(RL),它也能替人稳稳盯下来。
小红书博主「你清醒一点」也碰到过类似情况:第一次用Codex在单卡上训练1.7B字符计数模型,数据读写失控,硬盘被塞满,机器当场黑屏死机。
后来改用Naive-N0.5-Flash,它先把爆显存和撑硬盘这两个隐患排除掉,又在抽查中发现一个更大的问题:判分器太死板,大量答对的题被一律判成0分。
判分逻辑加入容错之后,它自行启动了每15分钟一次的自动巡检。运行接近两个小时,博主全程没有碰键盘,测试准确率从21.3%升到54.4%。
能够一路逆袭,最关键的一步其实是它自己揪出了「考卷」本身的漏洞。
模型训练尤其是强化学习里,最怕的就是「奖励黑客」(Reward Hacking)——评分规则一旦有漏洞,模型就会忙着钻空子混高分,或者被死板规则误伤,越练越歪。
往后AI训AI动辄成百上千轮,能不能守住自己的考卷,直接决定了模型是在真变强,还是在原地刷分。
等到清洗脏数据、修复判分器这些「排雷」工作都交给Naive-N0.5-Flash,个人电脑才算真正成了「本地模型代工厂」。
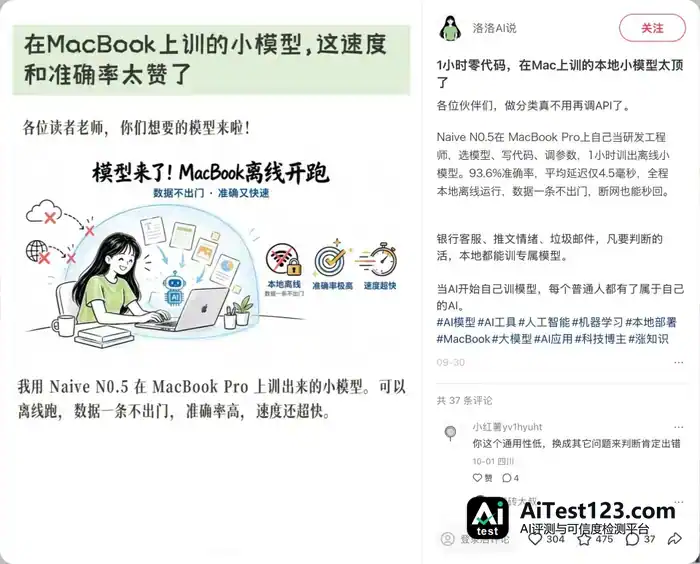
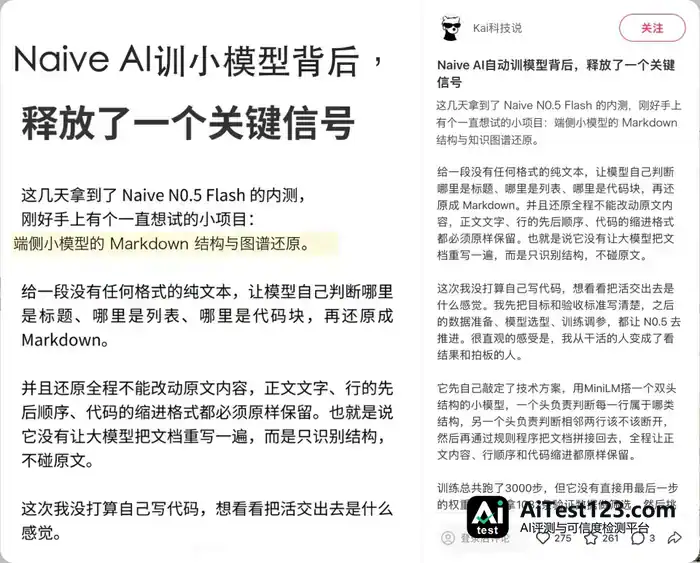
小红书上已经有人用1小时、零代码训出离线客服分类器;还有人让它抓取2,600多篇文档,训练出能把纯文本一键转成Markdown的小模型。
 |  |
看着网友们在笔记本上搓模型这么起劲,我们也手痒了,干脆把Naive-N0.5-Flash接进Claude Code,在自己的64GB Mac上亲手试了一把。
任务是用77类英文银行客诉数据集(BANKING77),在本地训一个1.10亿参数的BERT分流小模型。
这类工作最考验判断力。比如同样发生在ATM机上,「卡被吞了」和「卡退回来了却没吐钱」字面上都涉及取款机和银行卡,但对应的处理工单完全不是一回事。
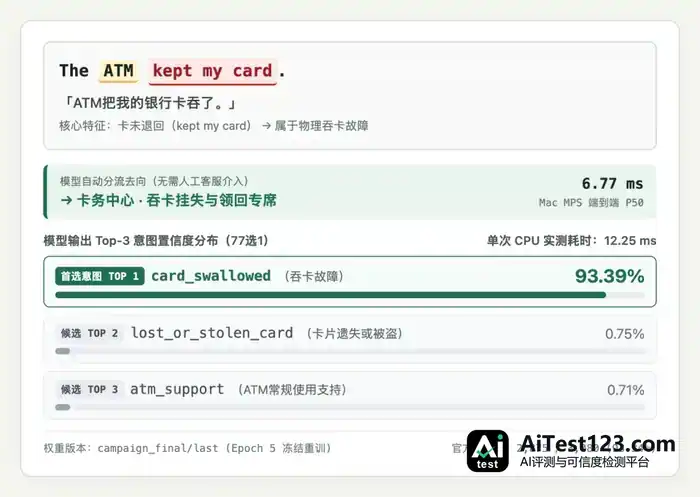
训练完成后打开本地网页试用,那种「输入即响应」的直观感受很明显:敲一句话The ATM kept my card.(ATM把我的卡吞了),几毫秒内就返回吞卡故障(,置信度93.39%)。card_swallowed
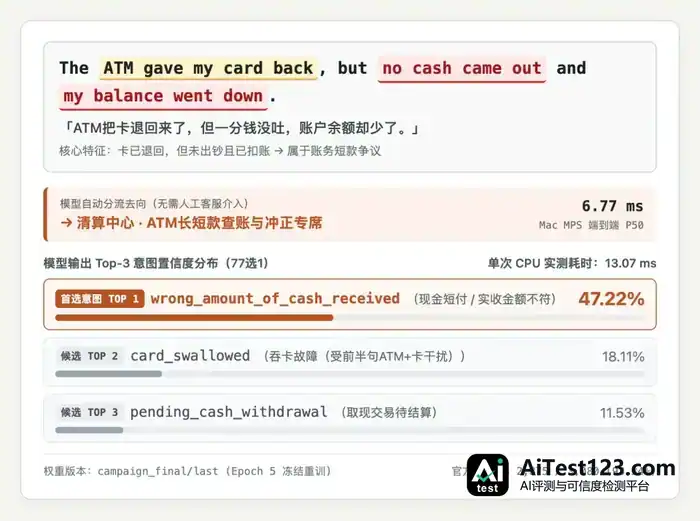
换后半句为「卡退回来了、一分钱没拿到,账户余额却少了」,虽然句中同样出现ATM和卡,模型仍马上判定为现金短付(wrong_amount_of_cash_received)。
再输入「买一张火车票被扣了两次车费」,立即返回重复扣款(),回答干净利落,没有半句客套。transaction_charged_twice
 |  |
整个训练过程中,最明显的一点是不需要人熬夜反复调超参。
云端由Naive API给出方案,本地Mac执行训练,连验证集上的「假进步」它也会替人盯住。
例如训练轮次拉到8遍时,训练Loss仍在持续下降,但在995条验证题上,第5遍分对了最高的940条,跑到第8遍反而退回到932条。
AI迅速判断模型已开始「死记硬背」,在第5遍及时停止,用全部9,947条清洗后的数据重新训练并交付。
最后在3,080条官方测试题上同场对比,差距立刻显现。
直接调用云端DeepSeek V4.1 Flash,每秒大约只能跑1条,准确率也只有75.81%。
而Naive-N0.5-Flash在本地训练出的这个开源BERT小模型,训完就能断网免费运行在Mac上,单条响应中位耗时只有6.77毫秒,速度约为云端的150倍,最终答对2,875条(准确率93.34%),近期热门的开源分类项目Laya和Jev也被它超过。
这也揭示出当前AI落地的一个常见误区:并非所有业务都要绑定在笨重昂贵的云端大模型上。
让强模型充当「总教练」,在本地孵化出6毫秒级响应、断网可用、数据不出内网的专精小模型,才是垂直场景中兼顾速度与隐私的最优解。
前面训练人设、做文本分流,还是在「有现成题库」的任务里打磨;如果彻底不用标准教材,把动态游戏画面、棋盘博弈乃至三维物理世界交给它,它还能应付吗?
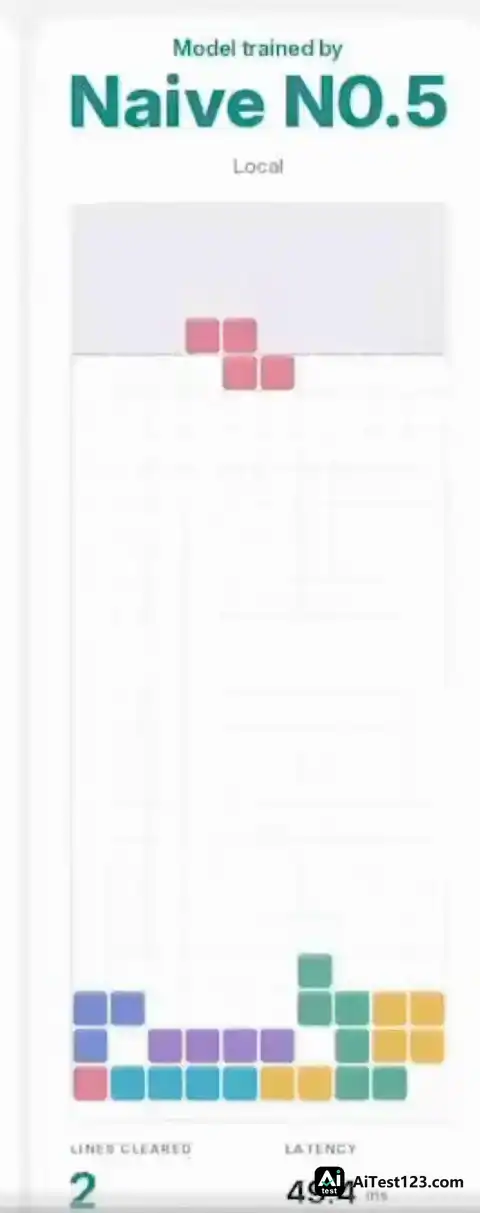
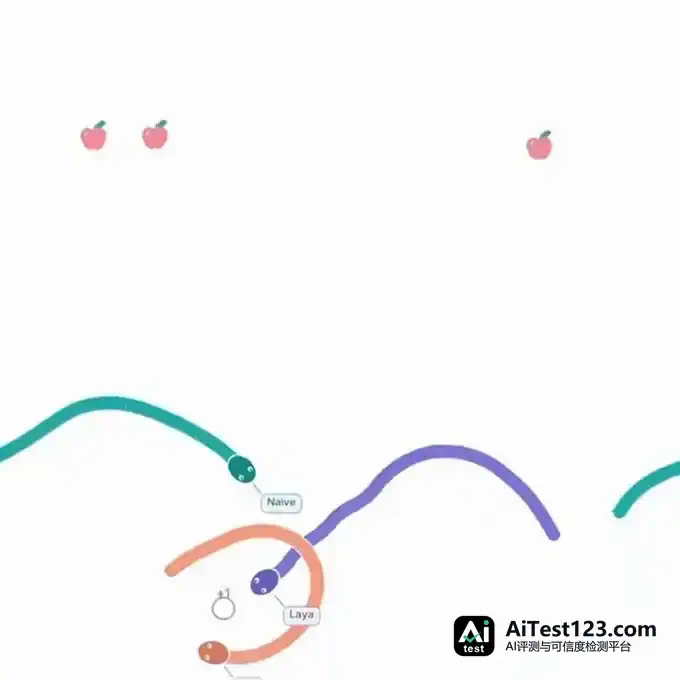
依然可以。面对《俄罗斯方块》和《贪吃蛇》,它直接在本地从头训练了一个能看屏幕的多模态小模型。
按难度对残局样本分组加权后,训练出的小模型左边玩俄罗斯方块快速连消破140行,右边玩贪吃蛇在围堵下灵活走位狂吃红苹果。
 |  |
还有测试者只给它一个空文件夹和一句提示。
限时3小时,它自行从零搭建整套AlphaZero自我对弈框架,在单张显卡上训练出的四子棋AI,执先手对「完美解算器」取得3胜1平。
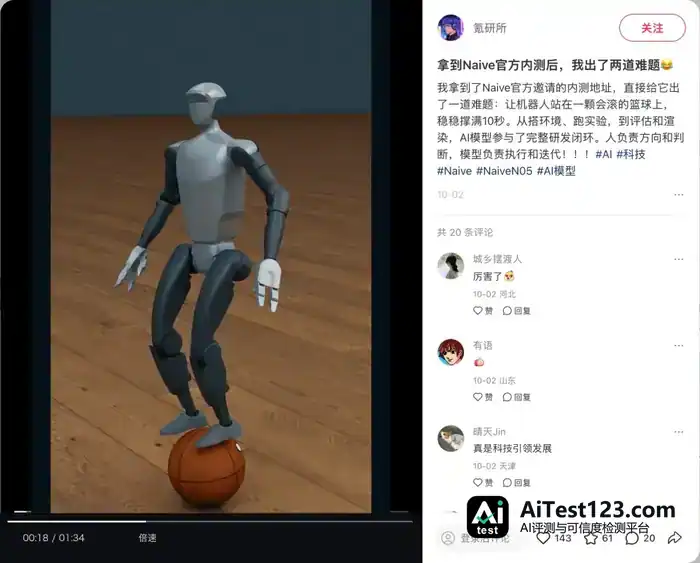
在小红书上,博主「林月半子的AI笔记」和「氪研所」又用益智游戏和硬核机器人控制给它加难度。
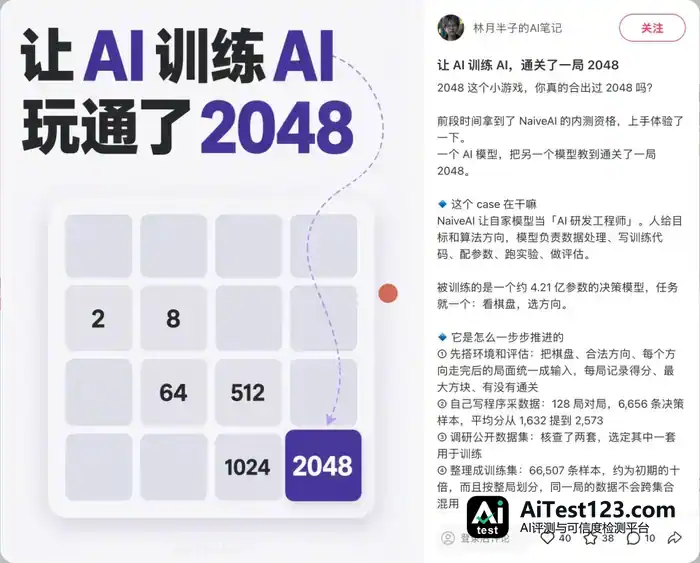 |  |
益智游戏《2048》成了第一道关卡,AI从公开数据集里翻出6.6万步高手操作轨迹,先把平均分提到原来的3.74倍。
第五轮时它上了PPO强化学习,发现分数不升反降,立刻停掉这条新路子,保留表现最稳的微调版本,随后一局顺顺当当合成2048通关。
考场随后换到NVIDIA Isaac Sim的三维物理环境,难度直接抬成两道机器人难题:
头一道,双足机器人得站在会自由滚动的篮球上,坚持满10秒。
AI从零搭环境、调奖励,把固定测试的成功率练到100%,即便加上随机推搡,也有91.15%的存活率。
第二道,小个子双足机器人MicroDuck要踩着50厘米高跷跨过台阶。
照搬旧经验迈出第一步,机器人当场翻倒在地。
AI按原方案连碰几次壁后决定推翻重来,另起一套由浅入深的训练课程。
结果机器人不仅能踩高跷稳稳行走,前进速度还提到初版的4.16倍,达到0.181米/秒。
看到这里能发现,训模型和写代码根本是两回事。
代码出错,编译器立刻报错;模型训歪了,屏幕上常常一个字都不提示,只是分数默默往下滑。
Naive-N0.5-Flash最像老算法工程师的地方,正是能「看懂异常信号、及时掉头止损」。
前面银行客诉到第5遍就果断刹车,2048砍掉掉分的PPO分支,高跷机器人推翻旧方案重排课程——这些早不是照模板跑脚本的体力活,而是有了「试错—推翻—重来」的策略判断。
靠着这股死磕的劲头,连最费脑子的AI科研它也能直接上手。
小红书博主「一只小茄墩」只给了一台普通CPU电脑和一句开放指令,它就自己选中一篇ACL 2026时序预测论文动手。
连跑743轮实验、自行修好29次报错,它在8组测试里把预测误差全部压到原论文基线之下,最高降4.10%。
最后它主动补上消融实验,交出一篇8页双栏英文论文。
看完这一串实测,难免让人好奇:既要连盯上百轮实验不丢线索,又要高频试错不卡顿、准确挖出各种暗坑,Naive-N0.5-Flash这身「算法老手」的本事究竟打哪儿来?
答案藏在它跨过的三道底层技术坎上——记不住、等不起、没手感:
其一,是AI参与设计的5:1混合稀疏注意力架构,原生支持100万上下文。
这个总参数309B、每次只激活15.5B的MoE模型,把注意力检索耗时压低了44%;哪怕100万token窗口里塞进几百轮实验日志、报错堆栈和完整代码库,它照样能看清前因后果、快速响应。
其二,是研究员带着AI手搓的NaiveRT推理引擎,单流速度达到每秒2,000词。
训练模型最头疼的就是干等,单流生成(Rollout)往往吃掉大把时间。
为此,研究员带着AI重写底层CUDA代码,6天做了151轮实验,把开源SGLang里每层29次零散GPU调用,融合成1个由148线程块协同的巨型内核。
单轮推测解码的耗时因此从12.3毫秒压到3.4毫秒,缩短了72.4%,线上每秒2,000词的极速模式靠它稳稳撑住。
第三样东西,是「AI4AI」强化学习训练场,每周滚动运行近1,000万个真实沙盒。
它的工程直觉不靠背题,而是在峰值并发高达10万的真实容器环境里,一轮轮写代码、抓Bug、看验证曲线,真刀真枪练出来的。
这份底子让它在SWE-bench Pro(73.6)、Terminal-Bench 2.1(86.7)等工程榜上排在前列;专考AI研发能力的MLE-bench-30(73.7%)与PaperBench(63.2)上,它也双双拿到开源领先成绩。
聊到这儿,再回头看硅谷争个不停的「递归自我改进」(RSI),其实没那么玄乎。
「用AI研发AI」不是一夜之间蹦出来的魔法,脚下这四级台阶正被一步步踩实:
第一级是单点打下手,帮人写几行脚本、给点调参建议,大多数普通编程助手就停在这里;
到了第二级,情况变成AI自己把新模型训出来:人只管把目标和验收标准交代清楚,数据清洗、开训、评测,乃至找出考卷里的漏洞,整条链路都由AI跑完,前面提到的甄嬛、银行分流、游戏AI和机器人,都处在这一级;
第三级则更进一步,AI转回来给自己运行的系统做改进——训外部小模型不再是重点,它要优化的是支撑自身运转的推理系统与模型架构,前面说过的NaiveRT引擎和5:1稀疏架构就属于这一类;
第四级是深度参与研发下一代自己,就像团队用它历经400小时研发出登顶WorldArena-1榜单的AutoWM世界模型,真正迈向「AI造更强AI」的闭环。这一步,眼下只有少数实验室在摸索,NaiveAI也正朝着这个方向走。
所以说,硅谷谈论的 RSI 并非一步登天,而是一级一级往上走。第一级早就是很多人的日常,而现在,普通人也已经站上了第二级。
当然,眼下的「用AI训AI」还没到人类可以彻底甩手不管的地步。
不管是开工前写下的任务书,还是研究员中途叫停无效分支,program.md「人定方向、依然是最务实的黄金搭档。AI跑执行」
但训模型这道曾经高不可攀的技术高墙,确实已经被推开了。打开自己的电脑,就能叫来一个懂权衡、会排雷的「 AI 研发搭子」替你训出专属模型。
属于普通人的Vibe Training时代,已经正式开场了。













