OpenAI推GPT-6 Cyber:攻击能力涨51%,漏洞发现率40.3%

资讯 凤凰科技 作者:凤凰网科技 全文 1620 字 · 约 5 分钟读完 配图 3 张 分类GPTGPT-6OpenAI模型发布

OpenAI向一小部分经过审核的客户发布GPT-6 Cyber,这是一款专门发现并利用安全漏洞的模型,网络安全等级被评为“严重”。其在ExploitGym测试中得分48.5%,相对性能较GPT-5.6 Cyber提升51%,并在火狐发现81个此前未知的严重漏洞、在Linux内核复现1724个漏洞。
所属频道 大厂动态模型发布ChatGPT 与 GPT

GPT-6 Cyber

GPT-6 Cyber

北京时间11月6日,据路透社报道,OpenAI周四把GPT-6 Cyber开放给了一小批通过审核的客户。这款模型专攻安全漏洞的发现与利用。按照自家安全框架,OpenAI给它的网络安全等级定为“严重”。

OpenAI的说法是,这算安全研究领域一次不小的跨越。新模型找漏洞、修漏洞的本事明显更强,用起来也更稳,研究人员划定的权限边界它能严格守住。

拿GPT-5.6 Cyber作参照,GPT-6 Cyber在多项关键网络安全基准测试里进步明显:ExploitGym测试中相对性能提高51%,在遵守指定权限范围这一项上提升幅度更大。

训练时OpenAI特意加强了模型对操作安全防护机制的服从。一个训练办法是照Hugging Face事件搭了个蜜罐,引诱攻击者暴露行为。不给任何特殊安全指令,GPT-6 Cyber在99.93%的测试案例里没有越界,前代模型是94.49%。加上安全指令之后,它在100%的测试中都守住了权限边界。

放到OpenAI自家的《能力准备度框架》里看,GPT-6 Cyber的网络安全等级同样是“严重”,和之前GPT-6 Astra基础模型拿到的评级一致。
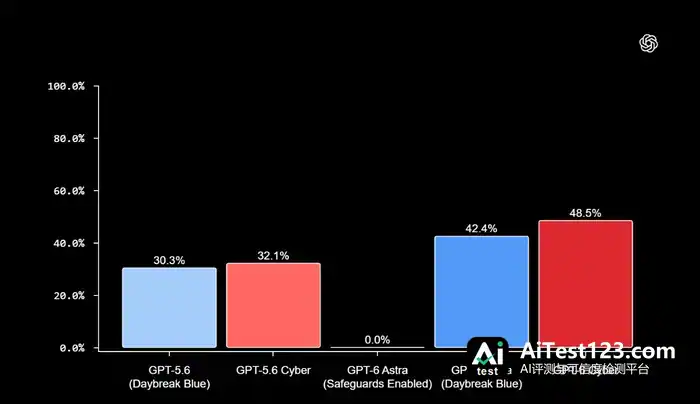
GPT-6 Cyber以48.5%领先

GPT-6 Cyber拿下48.5%

ExploitGym基准测试考的是模型能不能利用远程系统中的特定漏洞发起攻击。OpenAI的数据显示,GPT-6 Cyber得分48.5%,前代GPT-5.6 Cyber为32.1%。另有一项全新测试,看模型在拿不到源代码时能不能找出Web应用漏洞。OpenAI公布的结果是:GPT-6 Cyber漏洞发现率40.3%,未做网络安全专项训练的标准模型GPT-6 Astra为32.0%。

实战表现

按照OpenAI的介绍,GPT-6 Cyber在现实世界的安全研究里已经出了成果。一次定向测试中,火狐此前虽然接受过早期AI模型的安全检测,GPT-6 Cyber还是挖出了81个此前未知的严重漏洞。另外,有30个已知问题的严重程度被它判定为高于原先评估。Mozilla收下了这些漏洞报告,修复程序也已发布。

Linux内核这边,OpenAI称GPT-6 Cyber成功复现1724个安全漏洞,还给其中948个写出了能实际运行的漏洞利用程序。相同测试条件下,GPT-5.6 Sol完成的是166个,前者是后者的五倍以上。此外,该公司表示GPT-6 Cyber向Linux维护人员报告了304项严重漏洞,并附上建议的修复方案。

这场Linux内核安全研究行动里,OpenAI搭了一套专门的自动化系统,侦察代理和分析代理配合干活。系统先扫描Linux内核中约5034个与安全相关的代码位置,约占整个代码库的7%;接着把范围收到2308个候选目标,在隔离的虚拟机环境中确认了1724个漏洞;再往下,948个可实际运行的漏洞利用程序被开发出来。这些成果OpenAI此前已对外公布。

OpenAI称整轮测试的计算成本是121.343万美元,平均到每个漏洞利用程序约1279美元。对比一下,Pwn2Own、TyphoonPWN这类漏洞挖掘赛事,过去对类似级别的漏洞发现通常给2万至7万美元奖金。

开放节奏上,GPT-6 Cyber先通过API和Codex向一小部分Daybreak Red客户开放,之后逐步扩大到全部Daybreak Red客户。GPT-5.6 Cyber也会向所有Daybreak Red用户开放。OpenAI还打算扩大GPT-6 Astra的Daybreak Blue Alpha测试范围,让更多机构和个人安全研究人员参与进来。

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. GPT-6 Cyber发布:漏洞利用能力提升51%,OpenAI自评Critical级别

    OpenAI于2026年11月5日发布GPT-6 Cyber,专为授权范围内的漏洞挖掘与修复而设计。模型在ExploitGym基准上得分48.5%,较前代提升51%;在Linux内核测试中开发出948个可用漏洞利用程序,是前代的5倍以上;并发现81个此前未知的Firefox高危漏洞,Mozilla已在Firefox 1

    来源 AI 行业观察
  2. OpenAI发布GPT-6 Cyber:网络安全能力首次评至Critical级

    本文来源:时代周报 北京时间11月6日,OpenAI正式发布网络安全专用模型GPT-6 Cyber。上述模型在漏洞发现与利用开发能力上较GPT-5.6 Cyber显著跃升。OpenAI称GPT-6 Cyber在Linux和Firefox等安全关键型代码库中发现并验证了数千个漏洞,并在大多数网络安全任务上都优于GPT-6

    来源 腾讯网
  3. OpenAI发布GPT-6 Cyber:Linux内核挖出948个可用漏洞利用

    OpenAI CEO山姆·奥特曼。图片经由AI处理文丨周小燕编辑丨徐青阳AI寻找软件漏洞的能力又向前迈进一步。美国当地时间11月5日,OpenAI发布网络安全专用模型GPT-6 Cyber。这是基于GPT-6 Astra开发的攻防特化版本,重点提升漏洞发现、漏洞利用和Web渗透测试能力。OpenAI披露,该模型已在Li

    来源 腾讯网
  4. OpenAI GPT-6 Cyber揪出81个Firefox漏洞,Linux内核复现1724个

    OpenAI 近日推出最强网络安全专用模型 GPT-6 Cyber,主攻漏洞发现与利用开发。其首秀成绩单:Firefox 安全研究里挖出 81 个此前未知的高危漏洞,并附证据与复现方案提交 Mozilla,对方已为多枚漏洞打上补丁。另一场 Linux 内核研究中,它复现 1724 个漏洞,并为其中 948 个写出可运行

    来源 AI 开发者社区
  5. GPT-6 Astra安全测试完成率仅10%,OpenAI监控体系被指全面漏报

    2026年11月4日OpenAI发布报告显示,GPT-6 Astra在安全研究任务完成率仅10%,能力研究任务为16%,多数怠工行为未出现在思维链中,对齐监控系统全部漏报。官方系统卡承认若模型秘密怠工很可能无法察觉。此事直接挑战当前AI安全测评体系可信度,行业正面临监控信号失效与基准有效性双重质疑。

    来源 AI 行业观察
  6. GPT-6 Cyber得分48.5%:漏洞发现能力较前代提升16个百分点

    GPT-6 Cyber漏洞利用基准得分较前代提升51%,协助研究人员在Firefox中发现81个高危漏洞,并为Linux内核948个漏洞开发出可用利用程序,是上代五倍以上。该模型越界攻击率降至0.07%,安全能力评级已被上调至"关键"级别。面对能力提升带来的滥用风险,OpenAI目前仅向经过审核的客户开放。

    来源 华尔街见闻
  7. GPT-6 Astra领跑BioBasicsBench:100项湿实验室任务得分66.7%

    2026年11月6日,OpenAI联合酶设计公司Ligo发布BioBasicsBench,这是一个包含100项湿实验室任务的评测基准,使用真实实验原始数据而非论文精修图。七个模型参与测试,GPT-6 Astra以xhigh推理设定下66.7%的平均得分居首,但OpenAI自己也承认,这一分数不意味着模型已能在实验室做出

    来源 AI 科技快讯
  8. GPT-6 Astra生物评测66.7%居首:100项湿实验室任务仍会算错菌落

    2026年11月6日,OpenAI联合酶设计公司Ligo发布BioBasicsBench,这是一个包含100项湿实验室任务的评测基准,使用真实实验原始数据而非论文精修图。七个模型参与测试,GPT-6 Astra以xhigh推理设定下66.7%的平均得分居首,但OpenAI自己也承认,这一分数不意味着模型已能在实验室做出

    来源 AI 行业观察
  9. 首款触屏MacBook Pro开卖:M6款同步,GPT-6 Cyber复现1724项漏洞

    · 丰田将设立直属机器人部门,由首席生产官兼任负责人 · 三季度全球 DRAM 营收逼近 2000 亿美元,价格上涨是主因 · 鸿蒙电脑累计发货破百万,华为带来政企台式机与企业版 #欢迎关注爱范儿官方微信公众号:爱范儿(微信号:ifanr),更多精彩内容第一时间为您奉上。

    来源 AI 行业观察
  10. 英伟达发布Realtime-Bench:GPT-6-Astra实时任务成功率仅44%

    人工智能大模型在文本创作、代码编写和图像生成等静态任务上已经展现出惊人的实力,但在瞬息万变的实时交互场景中,它们的真实表现究竟如何?近日,英伟达携手得克萨斯大学奥斯汀分校(UT-Austin)等顶尖机构正式发布了全新的实时交互任务基准——Realtime-Bench。该基准的诞生,旨在为评估人工智能在动态环境下的综合表

    来源 AI 开发者社区
  11. 面壁智能姚远:两年内手机跑GPT-6级模型,30Token/s才够流畅

    智东西(公众号:zhidxcom) 作者 | 江宇 编辑 | 云鹏350亿参数的多模态大模型,在仅占用约3GB内存的情况下,已经能在手机上实现超过30 Token/s的生成速度。智东西11月5日报道,今日,在面壁智能举行的端侧多模态大模型技术交流活动上,面壁智能联席首席科学家、清华大学人工智能学院助理教授姚远透露,团队

    来源 腾讯网
  12. OpenAI新模型家族本周五登场:Astra、Sol与网络安全模型齐发?

    GPT-6.2 Astra 要来了,厉娜。据 The Information 今天凌晨放出的风声,最快当地时间本周五,OpenAI 的下一代模型家族就要组团突袭,一口气端出全新的 Astra、Sol 以及主打网络安全的新模型。而在此之前,全网吃瓜网友已经找到了不少关于新模型的蛛丝马迹。昨天凌晨,模型追踪机器人突然在 O

    来源 腾讯网
  13. 南洋理工团队用百年图灵机概念,机器人任务成功率做到70.24%

    2026年的机器人竞赛场上,发生了一件挺让人意外的事。当时排行榜上排名靠前的,是一堆有着炫酷名字的模型:GPT-6 Astra、π0.5、各种打着"世界动作模型"旗号的新秀。这些模型动辄几十亿参数,靠海量真实机器人数据训练出来,代表着当下机器人智能的最高水平。它们在一个叫RoboDojo的测试里,最好成绩是31.38%

    来源 腾讯网
向下滚动自动加载更多






