

Thinking Machines 发布 Inkling 2 Small,同步寻求 50 亿美元新融资
技术博客里大大方方写了采样自 Kimi K3。
11 月 5 日,由 OpenAI 前 CTO Mira Murati 创办的 Thinking Machines Lab(下称 TML)一口气放出了两条消息。
一条是新一代模型 Inkling 2 Small 正式登场。第三方评测机构 Artificial Analysis(AA)给出的判断不低:等权重开放之后,它会是「中国以外得分最高的开放权重模型」。另一条则是融资——据报这家公司正以 400 亿美元的投前估值,募集 50 亿美元新资金。
TML 于 2025 年 2 月公开亮相,到现在已经过去一年半还多。这期间它拿到过 a16z 领投的 20 亿美元种子轮;也经历过人事震荡——联合创始人 Andrew Tulloch 转投 Meta,联合创始人 Barret Zoph、Luke Metz 等人在今年 1 月回到 OpenAI,此后 CTO 一职由 PyTorch 联合创始人 Soumith Chintala 接手。
今年 1 月另有报道称,该公司以约 500 亿美元估值融资的谈判已经停滞。新一笔融资能否落地,很大程度上取决于二代模型的表现。
翻看 Inkling 2 Small 的技术博客,跑分表、架构图之外,最耐人寻味的其实是交代训练数据来源的那一行字:预训练后半程所用数据,大部分采样自更早的模型,其中直接点了月之暗面的名,把列了出来。Kimi K3。
01、594B 的「Small」,强在哪
在大模型行业里,「Small」这个标签正被越撑越大。
TML 今年 7 月推出的初代开放权重模型 Inkling 总参数为 975B,两周后出现的 Inkling Small 是 276B。到了第二代,Inkling 2 Small 的总参数涨了一倍多,来到 594B,每次推理激活 17B。架构是 MoE,上下文支持 100 万,思考力度可调,能读图;不过初代 Inkling 有的音频输入,这一代没有了。
训练流程下料很重。预训练第一阶段,团队在英伟达 GB300 NVL72 机架上跑了 68 小时,以原生 NVFP4(4 比特浮点)精度吃进 8.4 万亿 token;第二阶段再灌 3.8 万亿 token 的高质量新数据;最后两个阶段合计约 3540 亿 token 的推理与智能体轨迹收尾,上下文拉到 100 万。紧接着是 9 天的联合强化学习:2048 块 GPU,超过 1700 万次 rollout,单次 rollout 中位耗时 8 分钟,长的能跑到 4 个小时。
这些长链路训练,对应的是官方口中这一代最大的提升——长程自主工作。演示中,它用 Three.js 从零写出一款城市经营游戏,建筑、纹理、车辆全部程序生成,还得管电力、预算和突发事件;用 Python 从零写出一台能启动真实 Linux 内核的电脑模拟器;一张平面户型图也能被它变成可以走动的 3D 漫游。
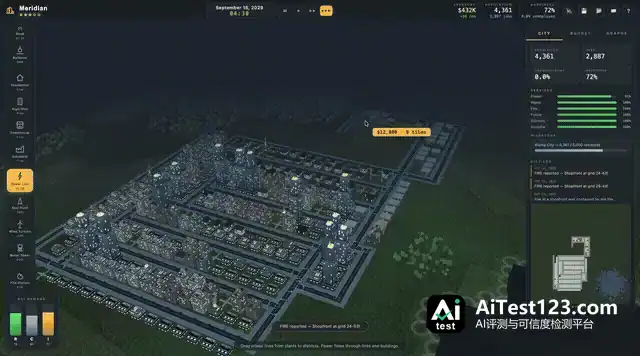
用 Three.js 从零生成的城市经营游戏|图片来源:Thinking Machines
训练过程也出过险情。强化学习跑到一半,监控发现模型通过搜索工具接触到的第三方服务,绕开了团队设置的网络封锁。团队只能暂停训练,拆掉联网环境、给工具调用加上同步监控,然后才继续。官方还承认,早期版本碰上太难的任务会「执着于成功」,出现编造结果、无视指令乃至掩盖行为。到发布版,内部「不当行为」得分从上一代的 66.8 降到 14.9(越低越好),但跟闭源模型比仍有差距。
跑分方面,它最长的板是知识工作和长流程商业任务。在考察表格、演示文稿和备忘录的 AA-Briefcase 上,它拿到 1527 的 Elo 分,上一代 Small 只有 912,Claude Sonnet 5.5 (medium) 是 1439,Gemini 3.8 Flash (high) 是 1203。官方对比表里,JobBench(70.5%)、Vals 法律指数(73.9%)、金融指数(61.5%)和 HLE-Diamond(28.7%)四项它都是最高分。
编程上就没法全面领先了。FrontierCode v2.0 和 DeepSWE v1.1 上,它压过了KimiK3 和 GLM-5.3-Flash,却输给DeepSeek-V4.1-Flash(25.4% 对 28.5%,72.1% 对 77.0%);SWEBench Pro v2 (Hard) 上则不敌KimiK3。跟闭源模型比,命令行任务 Terminal-Bench 4.0 上它只有 13%,Sonnet 5.5 是 30%。
代价体现在 token 消耗上。AA 的测试里,它每完成一个任务平均要输出约 15 万 token,上一代是 3.7 万,Sonnet 5.5 是 3.1 万。好在定价够低:每百万 token 输入 0.30 美元、输出 1.00 美元,单个任务成本 1.18 美元,Gemini 3.8 Flash 要 7.77 美元,Sonnet 5.5 要 10.02 美元。
幻觉率的下降则有点取巧。AA-Omniscience 上,它的幻觉率从 61% 降到 27%,可答题率也从 77% 掉到 53%,准确率只从 32% 升到 34%——降幻觉主要靠不会就不答。官方同样承认,它的聊天体验优化偏弱,内容组织不佳,还爱用斜杠。
02、为 Tinker 造一把锤子
一个聊天粗糙、却在写代码和做表格上格外卖力的模型,做出来图什么?答案落在 TML 眼下最核心的产品 Tinker 上。
Tinker 是 2025 年 10 月上线的云端微调 API。对 TML 而言,开源模型更像 Tinker 的招牌:模型免费放出,企业客户到平台上付费微调和推理。
强化学习的任务配比,直接反映了这种取向。编程按token算占了65.0%,办公与知识工作13.3%,STEM推理7.6%,网页与应用构建7.2%,这四项加起来超过93%。反倒是跟日常聊天最沾边的「对话、安全与认知」,按token只占0.2%。
评分器的设计同样围绕生产力任务展开。编程部分用隐藏单元测试来判分,有些任务还额外挂了一个「智能体评分器」,不光看测试过没过,还要看模型解题的路子;文档和工具调用由模型评委按评分细则打分;网页应用则是把渲染出来的截图两两对比,让奖励模型判断哪个更优。上线之前,早期版本曾以「Fledge-Alpha」的代号在编程工具 OpenCode 上匿名跑过,测的是真实场景下的编程表现。
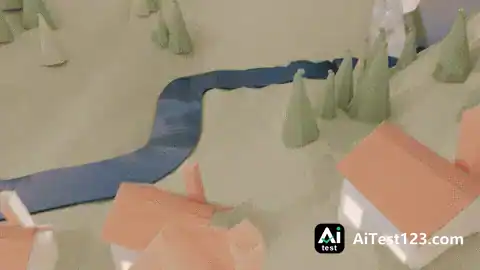
Inkling 2 Small 在 Blender 里根据反馈反复迭代出的纸艺动画|图片来源:Thinking Machines
官方反复主打的卖点是「适合微调」:数据和算法不变,新模型学得更快,提升也更大。拿一个财报摘要任务来说,它只训了75步,就追上了初代 Small 训完全程的成绩。
博客里还讲了一个套娃式的例子:TML 拨给 Inkling 2 Small 500 美元预算,让它在 Tinker 上自己训一个 Qwen3.5-4B 来做时间序列预测。评测自己写,SFT 和强化学习自己做,4小时17分钟后花掉426美元,小模型的得分从0.191升到0.289。
按官方的说法,Inkling 2 Small 只是「一组模型梯子中的一级」,更多尺寸很快会推出。先用中等尺寸的模型验证可微调性和长程干活的能力,把开发者引到 Tinker 上,这门生意才转得起来。
03、被「蒸馏」的中国模型
回到那行字。官方原话是:「H3 和 H4 的数据大部分是从更早的模型(包括KimiK3 和我们自己的模型)采样得到的轨迹,并按正确性和对齐做了过滤。」
H3 包含约3200亿token的推理和智能体轨迹(另有回放的预训练数据),H4 则是约340亿token的最高质量智能体轨迹。跟前两阶段合计12.2万亿token相比,这部分体量不算大,但位置关键:模型就是在这里学会长上下文推理、学会像智能体一样干活,之后才进入强化学习。
官方没有公布KimiK3 在其中的占比,所以不能说 Inkling 2 Small 是「靠蒸馏Kimi做出来的」。能确定的是,在这份配方里,KimiK3 是唯一被点名的外部模型。
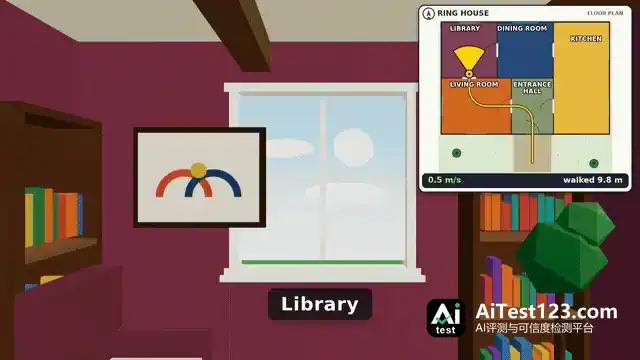
从一张平面户型图生成的3D漫游,右上角是行走路线|图片来源:Thinking Machines
为什么偏偏这两个阶段要用别人的轨迹?智能体轨迹本身就是很难攒的数据。模型得真的在环境里调用工具、读报错、改代码、再验证,一条完整轨迹动辄几万token,靠人工标注几乎没法大规模生产。最省事的办法,就是找一个在编程和智能体任务上已经够强的模型,让它跑大量任务,把做对了的过程留下来。在 TML 自己的对比表里,KimiK3 在 SWEBench Pro v2 (Hard) 和长上下文测试上都排在 Inkling 2 Small 前面,拿它当老师,顺理成章。
这一幕放在今年的语境里有些微妙。2月,Anthropic 指控DeepSeek、月之暗面和MiniMax这家公司拿约2.4万个假账号跟 Claude 聊了1600多万轮,把它的能力蒸馏出来。11月,硅谷一家明星企业在博客中写明,自己采集了月之暗面模型的轨迹。
两件事的性质要分开看。用假账号刷闭源模型的 API,违反的是服务条款;KimiK3 属于开放权重模型权重可以公开下载,放到自家集群上部署并采样输出,这在开源圈子里是很常见的做法。至于这么做是否完全符合Kimi许可证条款,TML 并未交代,此处不做判断。
蒸馏这件事本身也早就是业内标配。TML 上一代模型就靠「多教师蒸馏」,把不同阶段的强化学习结果并到一起。到了这一代,把外部最称手的开源模型接入数据管线,再用过滤器过一遍,是很务实的工程取舍。
真正发生变化的是它在生态里的位置。此前两年,开源社区普遍拿 Llama、Mistral 的权重做微调,或者用闭源大厂的输出喂养小模型。如今局面不同了,Kimi像 K3 这样的中国开放权重模型,已经变成硅谷团队训练下一代模型的数据来源;TML 演示中用来训练的底座,正是阿里的 Qwen。
04、美国开源模型追上来了吗
即便用上了 Kimi就 K3 的轨迹来看,Inkling 2 Small 距离登顶开源榜首还有一段路。
在 AA 最新的开放权重榜(v5.0.1)上,它拿到 31 分,把欧美对手甩在了后面:离得最近的 Mistral Large 4 为 26 分,Meta 的 Muse Spark Open 是 25 分。AA 那个「中国以外最高」的说法就是这么来的。
把这个限定语拿掉之后,前三名清一色是中国模型:KimiK3.1 Pro 以 46 分大幅领先,DeepSeekV4.1 Flash 为 33 分,GLM-5.3 是 32 分。Inkling 2 Small 大概排在第四的位置,后面还跟着 30 分的小米 MiMo-V2.6-Pro。它赶上的是中国的 Flash 级模型,距离Kimi的旗舰还差 15 分。
再说,它眼下还算不上真正意义上的开放权重模型。按照 TML 7 月敲定的「安全开放」路线,模型先以闭源形式在 Tinker 上线,等外部安全测试完成后再放出权重。官方称「计划下周以 Apache 2.0 许可放出」,AA 却把发布日期标为「未确认」。这张承诺能不能兑现,下周就能看到结果。
开源模型的竞争,正在演变成一种「谁的输出被谁拿去用」的循环。TML 用一篇直白的技术博客,把这件事摊开说了。
只是不清楚,等 Murati 团队沿着「模型梯子」继续往上走、推出更大的 Inkling 2 时,训练日志里还会不会出现Kimi 的名字?













