阿里云栖大会:Qwen4已在训练,Qwen4.5、Qwen5将扩至5-10T参数
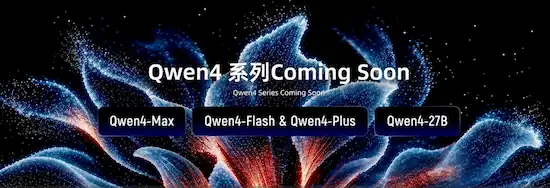
据介绍,大模型递归自我改进已初步进入模型训练、推理及芯模协同等环节中,基于新一代架构的Qwen4已在训练中,未来Qwen4.5、Qwen5等版本将扩展至5-10T参数。这些技术创新将成为新一代千问大模型的基石,据介绍,Qwen4模型正采用全新架构展开训练,Qwen4.5、Qwen5均在稳步推进中。公开数据显示,阿里已开
9月22日,阿里巴巴在云栖大会上披露了千问大模型的多项进展,公布者是阿里巴巴ATH事业群Token Foundry、Qwen LLM项目负责人刘大一恒。
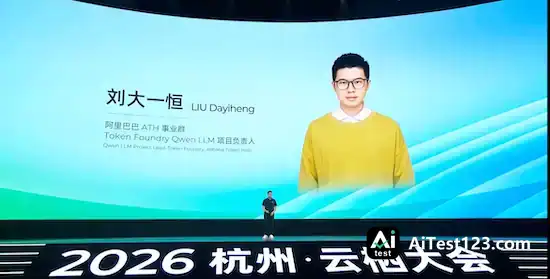
据他介绍,大模型递归自我改进(RSI)已经在模型训练、推理以及芯模协同等环节初步落地。采用新一代架构的Qwen4正在训练当中;后续的Qwen4.5、Qwen5等版本,参数规模将扩展到5-10T。另外,视频生成、语音、图像、世界、音乐以及全模态等模型,也在当天或近期推出了新版本。
为了追求更高的智能水平,Qwen正在加快自我进化的步伐
大模型正在走向自我迭代。这届云栖大会上,阿里集中展示了千问大模型在自我进化方面的最新探索成果。
模型自我训练方面,Qwen3.8-Max自己搭建训练流程、构造训练数据,还自主设计实验、定位缺陷,在人类完全“零参与”的情况下连续迭代超过1个月,完成33轮有效迭代。在RSI、后训练等技术联合优化之下,Qwen3.8-Max新版本在Artificial Analysis上的得分从40涨至45分,与Claude、GPT最强模型同处第一阵营,领先于GLM5.3、Kimi-K3等所有国产模型。
推理优化方面,面对此前从未见过的平头哥新款GPU,Qwen3.8-Max自主适配并优化了下代架构Qwen3.8-Flash新模型的推理框架,单实例推理吞吐量提升96%。
芯片模型协同设计方面,只给一份真实的总线模块规范,Qwen3.8-Max就自主展开了前端、验证、后端的全链路自迭代。自主运行超60小时、调用EDA工具超万次之后,它完成了减少42%面积的物理实现优化。

Qwen LLM项目负责人刘大一恒表示,Scaling是迈向ASI的关键路径,Qwen4.5、Qwen5参数规模计划迈向5到10T
大会现场,阿里展示了在大模型核心领域的多项技术创新。架构优化上,Qwen3.8-Flash提前开源了下一代千问大模型架构,靠注意力机制和模型内信息传递机制等核心技术创新,在前沿模型性能的同时把训练成本压低了近90%;再加上极少的参数激活,推理计算效率被推到全新的帕累托前沿,成了行业性价比“斩杀线”模型。模态扩充上,全模态模型Qwen3.8-Omni正式亮相,音视频等不同模态被高效纳入统一理解框架,为大模型开辟出全新的思考分区。参数扩展上,参数越大依然能带来更强的性能,未来千问大模型总参数量将扩展到5万亿甚至10万亿的规模。这些技术创新将成为新一代千问大模型的基石。据介绍,Qwen4模型正采用全新架构展开训练,Qwen4.5、Qwen5均在稳步推进中。
在探索大模型性能前沿的同时,阿里还以“全模态”“全尺寸”的大模型开源,与全球开发者和企业共享前沿AI技术红利。在全球最大的AI开源社区Hugging Face中,Qwen3.8-27B模型超过了DeepSeek-R1、Meta-Llama3.1等史上热门模型,拿下该平台历史上最受欢迎(Most Likes)的开源大模型。公开数据显示,阿里已开源460余个Qwen大模型,Qwen开源模型下载量突破30亿次,衍生模型数超30万个,稳居全球第一开源模型家族。
视听生成模型迎来升级,全新视频生成模型拟于11月发布
在最讲创意的视觉生成领域,阿里正持续迭代升级视觉生成模型,让AI产出更好的作品,也让用户获得更好的体验。
图像生成模型Qwen-Image-3.1亮相。它面向电商、创意、设计等真实商用场景做了全新优化升级,把原本要数小时的视觉设计压缩到秒级交付,水准堪比专业设计师,并且支持图像精准编辑。
Happy Shrimp 1.1 版音乐生成模型上线,人声质量、音乐表现、多语种演唱以及指令理解这四个专业维度都有提升;曲风支持百余种,主流语言覆盖十余种,人声歌曲和纯音乐两类生成场景都能用。
世界模型最新版本HappyOyster 2.0 Preview亮相。模型架构、训练方法和数据体系全面升级后,智能实时交互、记忆能力、实时响应、物理规律遵循等核心能力显著提升,世界模型真正从实验室走向真实可用。
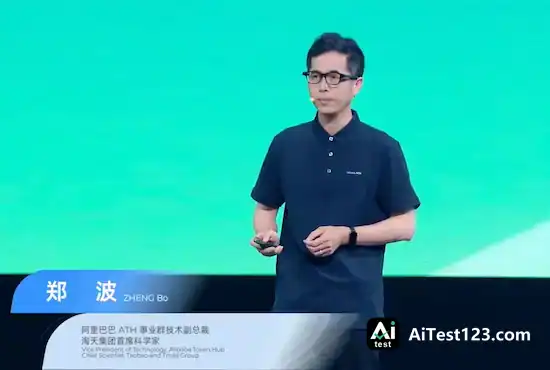
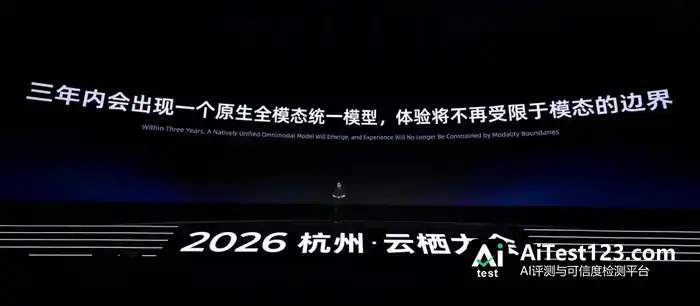
云栖大会现场,阿里巴巴 ATH 技术副总裁、淘天集团首席科学家郑波表示,三年之内会诞生一个原生全模态统一模型,届时体验将突破模态边界的限制。
下一代视频生成模型也会在 11月推出,主打更长、更可控、更完整、更智能:时间拉长后,新模型仍能保持一致性,人物、场景与镜头都在创作者的精准掌控之中;它还能像导演一样思考,从生成单个镜头走到理解完整叙事。
下代语音模型发布,Qwen落地多款智能终端
眼下,语音正成为AI与人之间更自然的交互入口,Qwen模型也在手机、AI眼镜、桌面机器人等硬件领域落地。
语音模型家族Qwen-Audio-3.1全新升级,包含语音转写(ASR)、语音合成(TTS)和实时语音交互(Realtime)三大系列。
基于下代架构的音频理解模型Qwen-Audio-3.1-ASR-Next全新发布,它能理解人物情绪、音乐、环境声与机械声,完成声音描述、事件定位、音频问答与推理,像“这段录音中人的情绪怎样”这样的问题,能够被理解和准确回答。
同时,音频创作模型Qwen-Audio-3.1-TTS-Next全新亮相。它采用全新架构,可根据一段脚本直接生成融合对白和环境声的完整音频,有声书、影视剧和播客等专业创作的效率因此大幅提高。
Qwen-Audio-3.1-Realtime的实时交互能力再度提升,能够边听、边想、边说,并进一步增强了多语言交互、角色扮演和共情能力。目前,该系列模型已应用于千问办公和Qoder,并接入QwenNote A2随身助理、QwenNote Eva桌面机器人和千问AI眼镜等硬件产品。
同声传译方面,Qwen3.8-LiveTranslate首次亮相。人类同传平均时延在4秒以上,这个模型能把时延压到不到2.5秒。新模型已经接入千问AI眼镜、QwenNote A2、钉钉耳机等AI硬件。
阿里大模型正在加快走向终端。AI手机全栈解决方案Qwen Intelligence发布,针对手机场景做了深度优化,给合作伙伴提供基于千问大模型的Agent技术平台,让手机更可靠地完成跨应用的复杂任务。
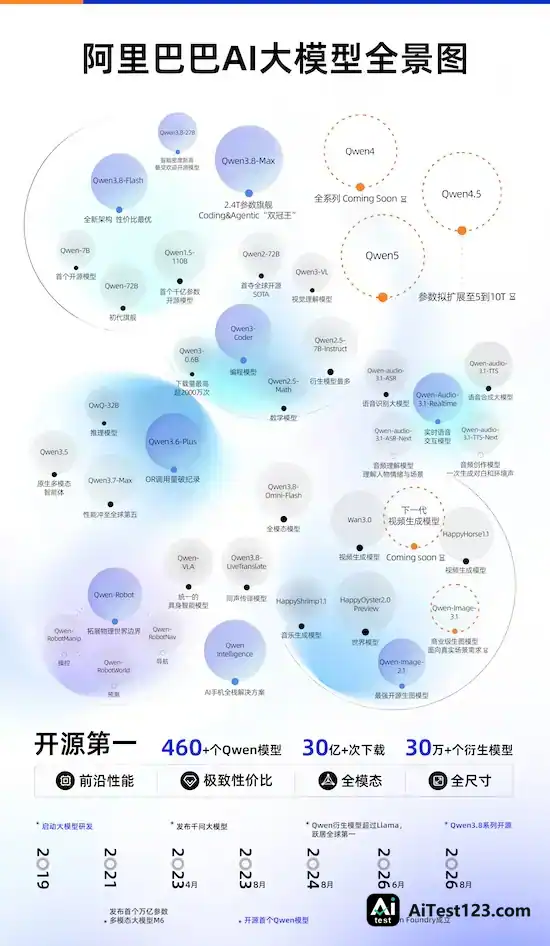
阿里巴巴AI大模型全景图