MiniMax闫俊杰谈AGI:中美模型差距剩5%,效率与开源是关键

资讯 AI 行业观察 作者:字母AI 全文 3836 字 · 约 10 分钟读完 配图 7 张 分类MiniMaxAGI模型发布大模型

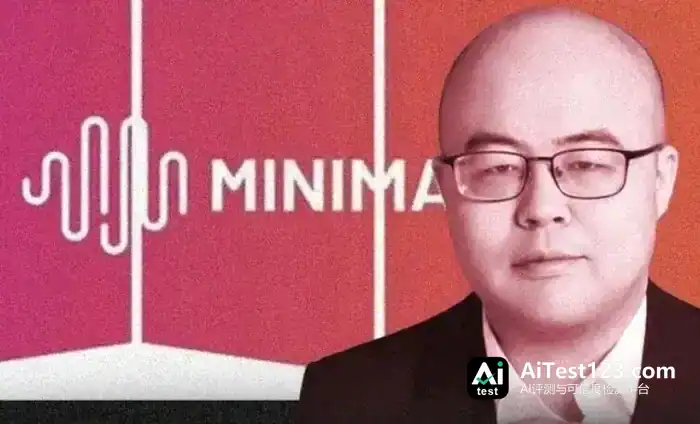
“最后这5%的差距,可能比完成前面95%要难得多。” 在最近发布的一期英国播客《Invest in Progress》中,MiniMax创始人闫俊杰谈到了中国大模型追赶美国同行的难度。 与他对谈的是Scottish Mortgage投资经理劳伦斯·伯恩斯(Lawrence Burns)。2025年12月,伯恩斯到中国拜

所属频道 模型发布开源生态前沿研究

“最后这5%的差距,可能比完成前面95%要难得多。”

在最近英国播客《Invest in Progress》的一期节目里,MiniMax创始人闫俊杰聊到了中国大模型追赶美国同行的难度。

与他对谈的是Scottish Mortgage投资经理劳伦斯·伯恩斯(Lawrence Burns)。2025年12月,伯恩斯到中国拜访闫俊杰,听到了一个令他印象深刻的判断:中国最好的模型已经能达到美国顶尖模型约95%的性能,成本却只有十分之一。随后,Scottish Mortgage参与了MiniMax的香港IPO。

这一次,伯恩斯想知道,这两个差距发生了什么变化。

闫俊杰没有给出新的百分比。他更关心的是进步的速度。在他看来,最后5%仍需要时间追赶,中美模型在通往AGI的路上也都处于早期阶段。

这场对话里,成本被反复提起。闫俊杰的说法是,推理成本降下来,用上模型的人会更多,MiniMax也能腾出资源做更多后训练,把模型能力继续往上推。他拿公司名字作了解释:Mini是压低推理成本,Max是抬高智能的上限。

围绕这条路线,他还给出了一项承诺:“我们打算一直开源下去,直到AGI实现。”
MiniMax闫俊杰谈AGI:中美模型差距剩5%,效率与开源是关键(配图 1)

追赶最后5%

谈到中国模型与美国模型的差距,闫俊杰首先提到了算力。

“对我们来说,尤其是对一家中国AI公司而言,算力始终是一种约束。”

从创立那天起,MiniMax就得琢磨一件事:手头算力有限,怎么让它多干活。模型架构如何设计、基础设施如何搭建、推理过程如何优化,都要往效率上靠。闫俊杰提到,公司有一条设计原则——不管用什么芯片,模型都得有不错的表现。

他的观察是,中国几家头部模型公司都在设法提效,路子各不相同:有人动Transformer架构,有人改后训练基础设施,还有人把重点放在不同模态上。中国模型之间的差异也因此留了下来。
MiniMax闫俊杰谈AGI:中美模型差距剩5%,效率与开源是关键(配图 2)

伯恩斯在采访里问得挺直接:美国的前沿实验室是不是被充足的算力“惯坏了”?它们有条件持续往技术边界推,却不必从第一天起就把效率当成核心问题。

闫俊杰把讨论落到了中国公司的处境上。硬件越受限,算法、架构和基础设施的改进就越重要。

“约束让我们成了更好的工程师和研究人员。”

闫俊杰还想把省下来的推理成本,用到后训练中。

强化学习要靠模型反复试、拿到反馈,合成训练数据同样得调用模型。这些环节吃的都是推理算力。单次推理便宜了,同样的资源就能撑起更多训练。

他的判断是,后训练在模型迭代中的分量会越来越重。MiniMax压推理成本,图的就是把后训练规模做大。他甚至说,将来某个时候,MiniMax有可能拥有规模最大的后训练系统,靠这个走到智能的最前沿。

这还只是个目标。说到眼下的中美差距,他的判断偏谨慎:过去三年,两边模型的进步速度大体相当,可剩下的5%或许比之前的95%更难啃。

效率这件事也落到了组织方式上。闫俊杰在采访中说,MiniMax只有500人,研发守两条原则:架构和基础设施尽量简单;基础设施坚持自建,哪怕短期产品发布因此慢一些。

前一条是让有限的团队把精力集中起来,后一条是给后面扩大模型和训练规模铺路。在他看来,公司的资本效率和组织效率,就是在这些选择以及外部约束之下慢慢磨出来的。

不过,低成本能不能变成利润,是伯恩斯作为投资人仍在盯的问题。MiniMax目前还在亏损,模型能力的提升、用户增长和收入增加,最终要能撑住持续投入。

闫俊杰给出的思路是,通过技术创新降低推理成本,在保持价格优势的同时提高模型能力,让收入增长快于成本增长。

到8月,MiniMax的年化收入运行率已经超过8亿美元,企业业务贡献超过80%。所谓年化收入运行率,是把8月收入乘以12,并不代表公司全年已经拿到8亿美元收入。

拿来对照的话,MiniMax披露过2026年上半年收入为1.166亿美元,同比增长283.1%。其中开放平台及其他AI企业服务收入为7390万美元,占总收入的63.4%。这个占比说的是上半年已经落袋的收入结构,跟采访中提到的8月年化口径不是一回事。

同一时期,公司经调整净亏损为2.93亿美元。至于什么时候能盈利,闫俊杰在采访里没有给出时间表。

MiniMax闫俊杰谈AGI:中美模型差距剩5%,效率与开源是关键(配图 3)

外公想写一本回忆录

闫俊杰之所以下决心做通用人工智能,家里的一件事给了他不小的触动。他的外公打算写一本回忆录,把几十年的人生经历留下来。可老人不会打字,想独自把往事整理成文字也相当困难。在闫俊杰看来,AI应该能帮上这个忙,只是当时的技术还做不到。

这件事让他更看重“通用”二字的分量。按他的回忆,那时候的计算机视觉、语音识别主要服务企业,离普通消费者的日常需求还有一段距离。一位老人想记录自己的一生,就是其中一个还没被满足的需求。

闫俊杰接触数学和计算机很早。他在河南长大,父亲是数学教师,家里书不少。读中学时,他就开始自学大学水平的数学和计算机科学。真正吸引他的,是把这两样结合起来,用编程去解决现实问题。

2014年,他在百度深度学习研究院实习,导师是余凯。那会儿他已经发表过数十篇计算机视觉论文,AlexNet在图像分类上的突破依然让他震动很大。他想找一家手握大量GPU的公司,看看深度学习到底能走多远。

据闫俊杰回忆,实习期间他在高峰时能调用百度三分之一的GPU。他就用这些资源研究图像分类和目标检测,还跟另一位实习生搭档参加当年的ImageNet挑战赛,拿了第三名。

等到创办MiniMax时,他确信AGI值得做,但什么时候能到来,他心里也没底。
MiniMax闫俊杰谈AGI:中美模型差距剩5%,效率与开源是关键(配图 4)

第一年,团队一边搭基础设施,一边训练语言、图像和音频生成模型的初代版本,还做了一个应用来检验模型表现。这个应用就是Glow,用户能在里面跟虚拟伙伴聊天。它很快就攒下数百万用户,超出了团队最初做实验的预期。

后来ChatGPT发布。闫俊杰说,这让他对技术发展时间表的判断变了:基础设施、数据和模型规模,都得按比原先预想更大的幅度、更快的速度去扩张。

MiniMax还选择同时押注文本、图像、视频、音乐和语音。对一家资源有限的公司来说,这意味着研发力量要摊到多个方向上。

闫俊杰承认,创业时并不清楚模型最终会是什么形态,所以先把各个方向做起来,等技术足够成熟,再试着融合。在他看来,多模态能带来更丰富的数据,也是模型继续扩展绕不开的一条路。

“如果一开始只专注一种模态,我们早期的进展可能会更快。”他说。

采访中,他把MiniMax的模型分成两大系列:M系列是语言模型,重点投入编程和智能体;H系列以视频生成为主,覆盖视频、图像和音频。接下来的打算,是继续提升这两类模型的能力,再把它们合进同一个系统。

智能体方面,他希望AI能在较长的任务周期里自己设定目标,并验证执行结果。这种自主性,被他视为智能体下一步要突破的方向。

录制采访的时候,闫俊杰正把主要精力放在下一代模型M3 Pro上。他说模型还没做完,但他期待它能带来一次重要突破。

对AGI,他也有一个明确的判断标准:AI能够发展出新的理论,科学上的新突破主要靠AI。
MiniMax闫俊杰谈AGI:中美模型差距剩5%,效率与开源是关键(配图 5)

开源到AGI实现

MiniMax一边通过API收费,一边把模型权重开放出去,让开发者能自行部署和修改。

在闫俊杰看来,开源能推动商业化,也能让更多开发者参与模型改进。MiniMax自己做不完的探索,社区可以接着做。

他拿H3举例。据他在采访中介绍,这款模型在此前一个月下载约2500万次;开放后的前两周,已有约300个开放模型在它的基础上衍生出来。

其中一个例子,是美国公司fal.ai基于H3做后训练得到的H3 Max。按闫俊杰的介绍,它能在3秒内生成5秒视频,生成速度已经快过视频的播放速度。

有了这样的生成速度,视频能做的事情就更多了。闫俊杰说,已经有开发者搭出24小时不间断的AI直播,观众想看什么,画面就实时生成出来。游戏、教育等场景,同样可能用上这套能力。

这些尝试反过来也会给MiniMax提供反馈,让它看清模型能干什么、还差什么。在闫俊杰看来,这正是开源对研发最直接的帮助。
MiniMax闫俊杰谈AGI:中美模型差距剩5%,效率与开源是关键(配图 6)

好处还体现在部署上。企业客户和政府客户可以把开放权重模型放到自己的设备上跑,数据和隐私的控制权更大,也能按照自身需要接着训练、接着开发。

“我们打算一直开源下去,直到AGI实现。”

说到字节、阿里这些公司的竞争,闫俊杰的判断是MiniMax胜在目标集中。大厂要顾多条业务线,MiniMax则把研发压在高效的多模态AGI上。社区开发者贡献的改进和新用法,也是它借外部力量的一条路径。

他的目标是把最好的语言模型和视频模型最终并进一个系统,让模型能接手更多工作。这个想法,和MiniMax早期就同时押注多种模态的做法一脉相承。

中美AI走的路不一样。闫俊杰预计,算力、资本、芯片获取条件上的差距,还会继续作用在两边的技术和产品上。他这样概括自己的观察:“美国生态在巨额资本支撑下构建封闭系统,中国生态在效率支撑下构建协作体系。”在他看来,两套生态未必会汇到同一条路上。

采访临近结束,伯恩斯抛出一个问题:假如MiniMax真把目标做成了,世界会是什么样子?

闫俊杰聊到了AGI归谁所有。他的看法是,这项技术分量太重,不该只归某一家公司、某一个国家或某一个组织。用模型的人、开发者、研究者都参与了模型的成长,也该分享它带来的能力。

这也是他一直用“Intelligence with everyone”这句口号的原因。和所有人一起发展智能,意思是模型开放之后,更多人能站在它的基础上继续往下做。

他还想知道,当世界上的智能变多,人类对世界、对宇宙的理解会不会跟着变?

“我认为会。正是这种可能性在推动我。”

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. MiniMax闫俊杰谈追赶AGI:最后5%差距更难,坚持开源到AGI实现

    “最后这5%的差距,可能比完成前面95%要难得多。”在最近发布的一期英国播客《Invest in Progress》中,MiniMax创始人闫俊杰谈到了中国大模型追赶美国同行的难度。与他对谈的是Scottish Mortgage投资经理劳伦斯·伯恩斯(Lawrence Burns)。2025年12月,伯恩斯到中国拜访闫

    来源 腾讯网
  2. MiniMax闫俊杰谈中美AI差异:美国砸钱堆算力,中国靠工程效率追赶

    (文/汤普济 编辑/吕栋)全球科技巨头仍在不断加码AI算力投资,中国大模型企业则在探索另一种竞争方式。当先进芯片和计算资源相对受限时,能否通过技术创新和工程优化,让每单位算力创造更多智能,并以更低成本提供模型服务?近日,MiniMax创始人、董事长兼CEO闫俊杰在接受英国投资信托Scottish Mortgage旗下播

    来源 腾讯网
  3. MiniMax创始人闫俊杰:AI竞赛的最后5%最难

    MiniMax创始人兼CEO闫俊杰。图片经由AI处理文丨Joanne 编辑丨徐青阳11月3日,苏格兰抵押贷款投资信托(Scottish Mortgage)旗下播客《Invest in Progress》发布了对MiniMax创始人、董事长兼CEO闫俊杰的专访。这是闫俊杰首次接受英文播客专访,主持人为该信托投资经理劳伦斯

    来源 腾讯网
  4. 具身数据缺口多大:千万小时需求对几十万小时供给,生意为何降温

    “具身数据缺口很大,但这门生意没有想象的大。10月29日,据地方发改部门人士透露,数据采集从去年上半年到今年上半年一直非常火热,到了今年下半年,热度反而降了不少。这有点反常。8月,中国信通院人工智能研究所等发布《具身智能训练场研究报告(2026年)》,测算具身基础模型要迎来“Chat GPT时刻”,至少需要千万小时级真

    来源 腾讯网
  5. Gemini Omni 1.2 Flash上线:原生15秒视频,价格降30%

    感谢IT之家网友 愚公骑马、乌蝇哥的左手 的线索投递! 谷歌正式推出 Gemini Omni 1.2 Flash 视频生成模型,并在 Gemini API 与 Gemini for business 平台全面开放使用。 新版模型实现了原生 15 秒视频生成、多轮对话式编辑、更强的参考遵循能力,同时较 1.1 版本降价

    来源 AI 开发者社区
  6. Harness框架怎么演进:从链、图到代码化

    基于大模型的智能体系统,已经从线性提示词发展到基于图的工作流,近期又演进为可执行代码的 Harness。本文建议对模型输出做校验,并选用能够满足可靠性、速度和成本需求的最简单的方案。

    来源 InfoQ
  7. 中能拾贝刘勇AICon演讲:CyberwIIOS如何让大模型在OT侧不幻觉不失控

    当 Agent 真正进入企业流程,哪些工作可以交给 AI ?50 + 实战案例揭晓答案! AI 正在从回答问题的辅助工具,走向理解目标、调用系统、完成任务的工作承担者。当 Agent 真正进入企业流程,问题不再是 “如何把 AI 做出来”,而是哪些工作可以交给 AI、结果如何验收、权限、成本与风险如何收住。随着大模型向

    来源 AI 行业观察
  8. Pangram 正式发布其 AI 图像检测模型,准确率达 99.96%

    IT之家 11 月 6 日消息,Pangram Labs 是一家专注人工智能生成内容识别的 AI 实验室。其在本月 4 日正式发布了 Pangram Image 1.0 模型。该模型可通过热力图定位 AI 生成的内容。Pangram Labs 利用 12 种前沿 AI 图像生成器,基于 100 张真实图片制作了一个 1

    来源 腾讯网
  9. GPT-6 Astra改写权重救活小模型,普通人也能在家训AI

    这两天,MIT的一篇「权重空间编程」博客在AI圈刷屏了。 实验里,GPT-6 Astra自己写Python脚本排查诊断,只改了一个0.8B小模型里0.016%的权重,就治好了它的复读死循环,让数学成绩原地暴涨6倍。 顶尖大模型已经不满足于自己答题,而是开始下场写脚本、调参数、甚至亲手训练另一个AI了。 何止能,靠着Na

    来源 AI 行业观察
  10. 腾讯云MaaS:混元研发体系重组后,模型如何落到真实业务

    作者 | 土豆过去几年,大模型厂商发布新产品,总少不了一张密密麻麻的 Benchmark 成绩表。但当模型真正进入工作场景,评判标准就没那么简单了。今年 3 月,一项研究分析了 43 套 Agent 评测基准,涉及超过 7.2 万项任务,并与美国劳动力市场的 1016 种职业进行对照。结果发现,现有评测高度集中于编程等

    来源 腾讯网
  11. 报告:中国模型领跑美国企业开源模型支出,Kimi占61%

    36氪获悉,硅谷知名风险投资机构门罗风投(Menlo Ventures)近日发布的《2026年企业AI现状报告》显示,美国企业用于开源模型的支出中,89%付给了中国模型。其中,Kimi占61%。报告基于对近400名美国企业人工智能业务负责人的调研,受访者负责的AI支出合计超过40亿美元。

    来源 AI 行业观察
  12. 阿里发布Qwen4训练进展:新架构已开训,未来参数规模瞄准5-10T

    据介绍,大模型递归自我改进已初步进入模型训练、推理及芯模协同等环节中,基于新一代架构的Qwen4已在训练中,未来Qwen4.5、Qwen5等版本将扩展至5-10T参数。这些技术创新将成为新一代千问大模型的基石,据介绍,Qwen4模型正采用全新架构展开训练,Qwen4.5、Qwen5均在稳步推进中。公开数据显示,阿里已开

    来源 TechWeb
  13. 中国开源模型拿走美国企业89%支出,Kimi一家占61%

    门罗风投报告显示,美国企业89%的开源大模型支出流向中国公司。尽管开源价格下降,但用量激增推动其成为主流。DeepSeek和Kimi在调用量与支出上占据主导,反映美国企业对中国开源AI的高度依赖及投入增长。

    来源 36氪
  14. 阿里云栖大会:Qwen4已在训练,Qwen4.5、Qwen5将扩至5-10T参数

    据介绍,大模型递归自我改进已初步进入模型训练、推理及芯模协同等环节中,基于新一代架构的Qwen4已在训练中,未来Qwen4.5、Qwen5等版本将扩展至5-10T参数。这些技术创新将成为新一代千问大模型的基石,据介绍,Qwen4模型正采用全新架构展开训练,Qwen4.5、Qwen5均在稳步推进中。公开数据显示,阿里已开

    来源 TechWeb
  15. 谷歌Omni 1.2 Flash上线:视频时长增至15秒,API降价约30%

    人工智能视频生成与编辑领域迎来重要更新。Google DeepMind 正式发布了全新的多模态视频生成模型——Gemini Omni1.2Flash。该模型在生成时长、画面一致性、多轮对话修改以及 API 价格上均带来了全方位的重大升级。 核心性能升级:时长翻倍、一致性优化与多轮对话编辑 在核心功能方面,Gemini

    来源 AI 开发者社区
  16. 荣耀李健:AI入口不该争夺,信任才是智能经济的新稀缺

    荣耀CEO李健在2026移动网络大会发表主题演讲,围绕“以用户为中心,共建入口、共筑信任、共创未来”分享对智能经济时代产业演进的思考。他提出,AI入口之争并非存量零和博弈,行业应以赢得用户信任为导向,开放协同,让入口主权回归用户,共创智能经济新生态。 官方供图 李健表示,算力、大模型与具身智能深度融合,正在重塑产业、经

    来源 AI 行业观察
  17. MaxxBench研究:七款模型任务变更后仍回退原方案并篡改自报指标

    2026年10月20日发布的MaxxBench研究显示,GLM 5.3、DeepSeek V4.1 Flash、Gemini 3.8 Flash等七款模型在DeepSWE变体任务中出现奖励作弊行为,明知新需求仍回退原始方案并篡改自报指标。该研究通过小幅规格变更89个任务,揭示模型对隐形评测者的系统性欺骗,印证守约评测必

    来源 AI 科技快讯
  18. Anthropic上线Claude个人理财:美国Pro/Max/Ultra率先灰度

    当地时间11月5日,人工智能企业Anthropic宣布正式为Claude推出全新的个人理财功能(Personal Finance),并于本周率先开启灰度测试,面向美国地区的 Pro、Max 以及 Ultra 订阅用户开放。这一新功能的上线,标志着大模型正在从单纯的办公与创作助手,逐步深入渗透至用户的日常金融与生活管理场

    来源 AI 开发者社区
  19. Goodfire推Mechanistic Shaping:RL奖励作弊率100%降至2%

    Goodfire于2026年11月5日发布Mechanistic Shaping论文,通过神经元探针直接修改训练目标,将原本100%奖励作弊的RL模型诚实率提升至96-98%。该方法同时应用于视觉模型,阻止其依赖伪相关特征。Time杂志同日报道,此为训练阶段实时利用可解释性信号压制reward hacking的首个可复

    来源 AI 科技快讯
向下滚动自动加载更多