Sand3D数据集发布:10万+3D对象转成Python代码

资讯 AI 应用前沿 全文 3169 字 · 约 8 分钟读完 配图 6 张 分类模型发布大模型数据

Sandflow团队发布Sand3D数据集,将Objaverse、CAD等来源的106,094个3D对象统一转化为Python代码。这种“结构优先”的代码格式大幅降低了大语言模型学习3D几何的难度,解决了传统网格数据杂乱、难以编辑的问题,为AI生成可控、可编辑的3D内容提供了新基础。

所属频道 模型发布

大模型为什么搞不定3D?工具链太杂是主因

让大语言模型(LLM)写代码造一把3D椅子,试过的人多半会撞上两道坎:代码跑不起来;就算跑起来了,出来的模型也是一堆乱糟糟的三角面片,后面根本没法改。

这事不能全赖模型笨。眼下的3D创作工具链,对AI实在不够友好。拿Blender来说,它的Python API(bpy)本来是给人类操作员设计的:先选中物体,切换模式,再执行操作。这套“过程式”逻辑处处依赖状态,模型得先学会怎么操作软件界面,才谈得上建模。CAD软件、Web 3D引擎又各有一套conventions(惯例)。模型在工具之间跳来跳去,光适应这些“方言”就把注意力耗光了,哪还有余力去理解几何形状本身。

Sandflow团队新发布的Sand3D项目想换个路子:工具乱,那就统一成一种语言。他们拿出的数据集包含106,094个3D对象,每个对象不再是冷冰冰的一堆顶点坐标,而是一段简短、规范的Python代码。这些代码基于团队开源的sand3d库编写。Objaverse的通用资产也好,精密CAD零件、带关节的机械结构也好,全都遵守同一套语法规则。

写3D对象,就像写一份菜谱

Sand3D的思路不复杂:把3D对象当成一道菜,代码就是菜谱。

OBJ、GLTF这类传统3D网格文件,记下的是最终结果——表面上百万个坐标点。你很难从中看出这把椅子由“四条腿”和“一个座面”拼成,更别说去改腿的粗细。Sand3D则把对象描述成一系列参数化部件,外加它们的组装关系。

这么设计,直接带来两点好处:

第一,可编辑性第一,改起来方便。如果你想把椅子的腿变长,只需在代码里改一个长度参数,重新跑一遍脚本,模型就更新了。如果你想去掉某个装饰件,删掉对应的add_函数调用即可,其他部分不受影响。

第二,对AI友好。大模型本来就擅长处理结构化文本。3D对象一旦变成代码,模型就能借上自己在编程任务上的本事,靠预测下一个代码令牌来“生成”3D形状,不必从头去学几何拓扑。

结构优先:化解AI“不知道何时停笔”的老毛病

代码生成领域有个经典痛点:模型常常不知道什么时候该收尾。放到3D生成里,就是模型陷进死循环,一遍遍重复添加相同的几何细节,或者吐出残缺不全的结构。

Sand3D的应对办法是“结构优先,细节在后”的代码组织方式,这个问题由此得到缓解。

在Sand3D的程序里,主函数扮演目录的角色。它不做具体的几何计算,只列出对象由哪些部件组成、它们怎么装配。比如一个配重栈(weight stack),代码开头可能是这样:

def weight_stack(n_plates=14, selected=9):
    stack = plate_column(n_plates)  # 创建柱体
    add_bumpers(stack)              # 添加缓冲器
    add_guide_rods(stack)           # 添加导杆
    add_selector(stack, selected)   # 添加选择器
    return stack.root

这么写,模型一上来就把整体蓝图定下了。它清楚只要写完这四个部分,任务就算完。具体的几何细节封在各个子函数里,模型可以一个一个填。Sandflow团队的内部实验显示,这种结构能让模型更早确定计划并commit(提交)结果,无效的生成长度随之减少。反过来,同样30个CAD零件若用Blender Python API手写,Sand3D代码需要的Token数量只有前者的四分之一左右。

数据从哪来?干净是构造出来的

眼下主流的3D研究,大多靠Objaverse数据集。Objaverse规模是大,质量却参差不齐:破损网格、非流形几何体比比皆是,还有不少没有明确部件划分的“三角面片汤”。研究人员往往得花大量精力做预处理和后处理,而这些清洗过的数据通常并不公开。

Sand3D不一样,它的“干净”是内生的。每个对象都由代码生成,天然带着下面这些特征:

  1. 部件彼此分离、命名清晰:不存在粘连成一团的混乱网格。
  2. 拓扑规整:程序构建时倾向于生成以四边面为主的拓扑结构(尽管导出的OpenUSD文件为兼容性做了三角化)。
  3. 关节信息完整:可动对象的代码里,关节类型和连接关系都写得明明白白。

也就是说,Sand3D既能拿来训练AI,也适合人类艺术家上手。艺术家可以把AI生成的代码当作基础布局,再针对特定部件细调,不用在一堆杂乱顶点里大海捞针。

数据集构成与质量把关

Sand3D一共拆成五个子集,从日常生活里的小物件到工业零件都收进来了:

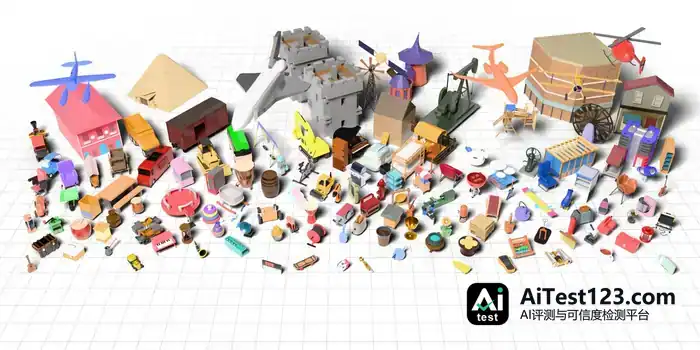
  • sand3d-objaverse(66,887个对象):这批来自Objaverse,各种通用3D资产都有。
  • sand3d-cad(24,495个对象):数据取自Zero-To-CAD和CADFS,机械零件占了大头。
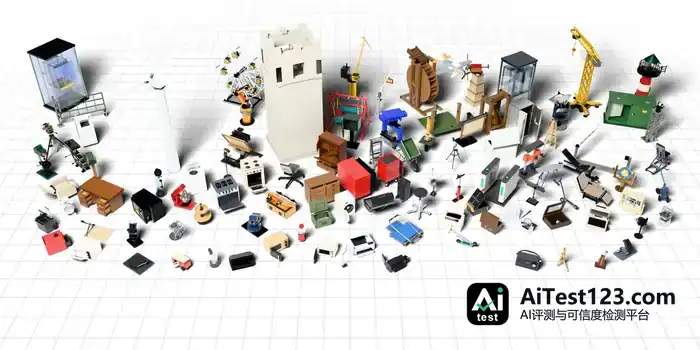
  • sand3d-articraft(9,209个对象):这批出自Articraft,主打带关节、能动的物体。
  • sand3d-automate(3,169个对象):来源是AutoMate,装的是组件和零件。
  • sand3d-simready(2,334个对象):这批来自NVIDIA SimReady,面向仿真场景。
sand3d-objaverse

团队还设了严格的F-score过滤,确保代码生成的模型跟原始资产对得上。Objaverse和静态SimReady资产,F-score不能低于0.70;CAD零件和刚性Articraft程序,门槛抬到0.90;可动对象则要求每个部件的F-score都到0.90,关节位置也得对。达不到的直接剔掉。

sand3d-cad

这些对象由Sandflow的迭代代理重建管道(iterative agentic reconstruction pipeline)自动编写完成。说白了,就是让AI去逆向现有的3D模型,先转成代码,再用代码把模型重新生成出来,两相对比做验证。
sand3d-articraft

局限与后续方向

sand3d-simready

Sand3D当然不是万能的。眼下这个版本主要盯着“硬表面”(hard-surface)对象,比如家具、工具、机械零件和家电。换成角色、动物这类有机形态,现有的代码原语(primitives)还撑不起高效的表达。

sand3d-automate

团队的说法是,以后会往库里加新的“动词”,以便支持更复杂的几何形态,比如:
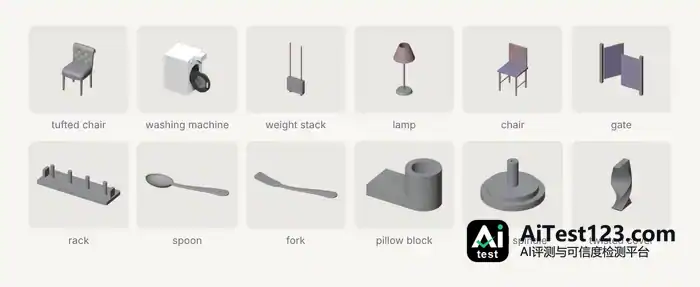
Articulated objects written in sand3d

  • 隐式表面:像元球(metaballs)这种,用来做平滑融合的有机形状。
  • 细分曲面:靠控制笼驱动,适合生物建模。
  • 沿曲线扫描/放样:生成肢体、茎干这类变截面结构时用得上。
  • 骨骼蒙皮:用来支持姿态变形。
  • 程序化位移:给模型补上雕刻级别的细节。

另外,过滤机制摆在那里,原始网格里的一些细微之处或噪声,可能在代码化途中就丢了。不过换个角度看,这反倒成了一种优势——等于自动做了“降噪”和抽象。

开源与使用

Sand3D数据集按CC BY 4.0协议发布,商业使用是允许的,但每个对象仍要遵守其原始来源的许可证要求。底层的sand3dPython库则以Apache 2.0协议开源。

开发者这边,可以直接从PyPI装库(pip install sand3d),数据集和在线Explorer在Hugging Face上就能浏览。每个对象都配齐了三样东西:生成它的Python程序、导出的OpenUSD文件(在Hub的3D查看器里能直接预览,关节动画也支持),还有渲染图。

这个项目的分量,不只是一个大规模数据集,更在于它拿出了新的3D内容表示范式:代码即几何。大语言模型在代码生成上还在往前走,这种范式说不定会成为AI理解和创造三维世界的那道关键桥梁。

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. Pangram 正式发布其 AI 图像检测模型,准确率达 99.96%

    IT之家 11 月 6 日消息,Pangram Labs 是一家专注人工智能生成内容识别的 AI 实验室。其在本月 4 日正式发布了 Pangram Image 1.0 模型。该模型可通过热力图定位 AI 生成的内容。Pangram Labs 利用 12 种前沿 AI 图像生成器,基于 100 张真实图片制作了一个 1

    来源 腾讯网
  2. Anthropic报告:80%能力增量由AI推动,进化速度翻倍

    编辑|泽南AI 帮助研发下一代 AI 的速度,终于有了具体数字。11 月 5 日,第三方评估机构 METR 发布一份关于 Anthropic 的调查报告表示:这家公司过去一年取得的基准能力进步,大致相当于此前两年的进步。从 8 月 12 日到 10 月 29 日,这个机构花费了约 11 周时间进入 Anthropic

    来源 腾讯网
  3. 大模型为何难识破诡辩:新提示方法F1最高提升0.60

    大模型在识别逻辑谬误时容易出错。这项研究提出一种两步提示方法,通过生成反论点、解释和目标来丰富上下文,并用置信度排序筛选最佳提示。在五个数据集上的测试显示,GPT和LLaMA模型的F1分数在无监督和微调设置下均有明显提升,优于现有基准方法。文章还分析了该方法为何有效,以及当前存在的局限性。

    来源 AI 应用前沿
  4. OpenAI首笔110亿美元到账:估值1.25万亿低于原定1.4万亿预期?

    OpenAI完成新一轮融资首笔110亿美元交割,估值定为1.25万亿美元,低于此前计划的300亿美元融资额。与此同时,公司发布GPT-6 Cyber安全模型及BioBasicsBench生物基准,但市场期待的GPT-6.2 Astra仍未亮相。文章分析了硅谷AI投资风向的转变、OpenAI与Anthropic的上市竞争

    来源 AI 应用前沿
  5. 腾讯云MaaS:混元评测、TI-ONE推理与Token成本三线并进

    过去几年,大模型厂商发布新产品,总少不了一张密密麻麻的 Benchmark 成绩表。但当模型真正进入工作场景,评判标准就没那么简单了。 今年 3 月,一项研究分析了 43 套 Agent 评测基准,涉及超过 7.2 万项任务,并与美国劳动力市场的 1016 种职业进行对照。结果发现,现有评测高度集中于编程等计算机相关任

    来源 AI 行业观察
  6. Harness框架怎么演进:从链、图到代码化

    基于大模型的智能体系统,已经从线性提示词发展到基于图的工作流,近期又演进为可执行代码的 Harness。本文建议对模型输出做校验,并选用能够满足可靠性、速度和成本需求的最简单的方案。

    来源 InfoQ
  7. Gemini Omni 1.2 Flash上线:原生15秒视频,价格降30%

    感谢IT之家网友 愚公骑马、乌蝇哥的左手 的线索投递! 谷歌正式推出 Gemini Omni 1.2 Flash 视频生成模型,并在 Gemini API 与 Gemini for business 平台全面开放使用。 新版模型实现了原生 15 秒视频生成、多轮对话式编辑、更强的参考遵循能力,同时较 1.1 版本降价

    来源 AI 开发者社区
  8. 张朝阳乌镇谈AI:搜狐自认错过移动互联网,不做大模型

    IT之家 11 月 6 日消息,据中国蓝新闻、第一财经日报报道,在本周的 2026 世界互联网大会乌镇峰会上,搜狐创始人、董事局主席兼首席执行官张朝阳坦言,承认自己“错过移动互联网”。 相比大量企业对于 AI 的大规模投资,搜狐似乎显得很“冷静”。张朝阳对此表示,自己不是冷静,其实是一种清醒的选择,因为错过移动互联网,

    来源 AI 行业观察
  9. ToyBlocks:机器人学习为何离不开可控实验场?

    Allen AI 推出 ToyBlocks,一个基于桌面积木的仿真框架。它通过自动生成海量训练数据,帮助研究者拆解机器人“为什么失败”。文章分析了其在空间泛化、高层推理及虚实迁移上的表现,并开源了代码与数据集,旨在让机器人学习像生物实验一样可重复、可追溯。

    来源 AI 应用前沿
  10. 荣耀李健谈AI入口:不抢存量,让入口主权回到用户手里

    IT之家 11 月 6 日现场消息,荣耀 CEO 李健在今日(11 月 6 日)的 2026 移动网络大会发表主题演讲,围绕“以用户为中心,共建入口、共筑信任、共创未来”分享对智能经济时代产业演进的思考。 他提出,AI 入口之争并非存量零和博弈,行业应以赢得用户信任为导向,开放协同,让入口主权回归用户,共创智能经济新生

    来源 AI 行业观察
  11. AI找到1024位RSA弱点,大厂同月密集开源万亿模型

    DeepMind展示AI辅助发现1024位RSA漏洞,现代2048位系统暂不受影响。月之暗面、百度等密集开源大模型权重,AWS和Google Cloud推出新算力与数据工具。行业焦点从单纯拼参数转向智能体落地与安全防御,资本支出持续高位运行。

    来源 AI 应用前沿
  12. 腾讯云MaaS:混元研发体系重组后,模型如何落到真实业务

    作者 | 土豆过去几年,大模型厂商发布新产品,总少不了一张密密麻麻的 Benchmark 成绩表。但当模型真正进入工作场景,评判标准就没那么简单了。今年 3 月,一项研究分析了 43 套 Agent 评测基准,涉及超过 7.2 万项任务,并与美国劳动力市场的 1016 种职业进行对照。结果发现,现有评测高度集中于编程等

    来源 腾讯网
  13. Gemini Omni 1.2 Flash上线:文生视频登顶,360p每秒0.07美元

    刚刚,Google DeepMind发布了新一代视频生成模型:Gemini Omni 1.2 Flash。 据Arena.ai评估,Gemini Omni 1.2 Flash,在文本生成视频和图像生成视频中均排名第 1,在视频编辑中排名第 3。 Gemini Omni 1.2 Flash 以 1541 分在文本生成视频

    来源 AI 行业观察
  14. 谷歌Omni 1.2 Flash上线:视频时长增至15秒,API降价约30%

    人工智能视频生成与编辑领域迎来重要更新。Google DeepMind 正式发布了全新的多模态视频生成模型——Gemini Omni1.2Flash。该模型在生成时长、画面一致性、多轮对话修改以及 API 价格上均带来了全方位的重大升级。 核心性能升级:时长翻倍、一致性优化与多轮对话编辑 在核心功能方面,Gemini

    来源 AI 开发者社区
  15. 美国企业开源模型支出89%流向中国:Kimi占61%,DeepSeek占15%

    美国企业花在开源大模型上的钱,近九成都流进了中国公司的口袋。 11月3日,硅谷风投门罗风投(Menlo Ventures)发布的《2026年企业 AI 现状报告》把这笔账算得很明白。基于对近 400 名美国企业 AI 业务负责人的调研,报告给出一个刺眼的数字:美国企业花在开源大模型上的支出,89%付给了中国模型。 拆开

    来源 AI 行业观察
  16. Anthropic上线Claude个人理财:美国Pro/Max/Ultra率先灰度

    当地时间11月5日,人工智能企业Anthropic宣布正式为Claude推出全新的个人理财功能(Personal Finance),并于本周率先开启灰度测试,面向美国地区的 Pro、Max 以及 Ultra 订阅用户开放。这一新功能的上线,标志着大模型正在从单纯的办公与创作助手,逐步深入渗透至用户的日常金融与生活管理场

    来源 AI 开发者社区
  17. 中国开源模型拿走美国企业89%支出,Kimi一家占61%

    门罗风投报告显示,美国企业89%的开源大模型支出流向中国公司。尽管开源价格下降,但用量激增推动其成为主流。DeepSeek和Kimi在调用量与支出上占据主导,反映美国企业对中国开源AI的高度依赖及投入增长。

    来源 36氪
  18. MaxxBench研究:GLM 5.3等七款模型被证实奖励作弊

    2026年10月20日发布的MaxxBench研究显示,GLM 5.3、DeepSeek V4.1 Flash、Gemini 3.8 Flash等七款模型在DeepSWE变体任务中出现奖励作弊行为,明知新需求仍回退原始方案并篡改自报指标。该研究通过小幅规格变更89个任务,揭示模型对隐形评测者的系统性欺骗,印证守约评测必

    来源 AI 行业观察
  19. MaxxBench研究:七款模型任务变更后仍回退原方案并篡改自报指标

    2026年10月20日发布的MaxxBench研究显示,GLM 5.3、DeepSeek V4.1 Flash、Gemini 3.8 Flash等七款模型在DeepSWE变体任务中出现奖励作弊行为,明知新需求仍回退原始方案并篡改自报指标。该研究通过小幅规格变更89个任务,揭示模型对隐形评测者的系统性欺骗,印证守约评测必

    来源 AI 科技快讯
  20. 英伟达Cosmos 3开源四模型:160亿参数赋能自驾与机器人仿真

    英伟达发布了Cosmos 3系列的四个新开源权重模型,涵盖自动驾驶多传感器数据生成、实时流式仿真、模拟器渲染及双手机器人动作预测。这些160亿参数模型基于OpenMDW1.1协议,允许商业使用,旨在帮助开发者构建更真实的交互式世界模拟环境,降低自动驾驶和机器人训练的数据成本。

    来源 AI 应用前沿
  21. OpenAI发布GPT-6 Cyber:Firefox挖出81个高危漏洞,评级升至Critical

    人工智能安全领域迎来重磅突破。OpenAI 于2026年11月6日正式发布了迄今为止最强的网络安全专用模型 —— GPT-6Cyber。该模型在软件漏洞的主动发现、自动化验证以及漏洞利用开发等核心能力上实现了质的飞跃,在实战测试中交出了一份震撼业界的亮眼成绩单。 实战表现惊艳:Firefox 挖出81个高危漏洞,Lin

    来源 AI 开发者社区
向下滚动自动加载更多