阿里发布Qwen4训练进展:新架构已开训,未来参数规模瞄准5-10T

资讯 TechWeb 作者:Techweb 全文 2574 字 · 约 7 分钟读完 配图 6 张 分类Qwen开源模型阿里模型发布开源开源生态

据介绍,大模型递归自我改进已初步进入模型训练、推理及芯模协同等环节中,基于新一代架构的Qwen4已在训练中,未来Qwen4.5、Qwen5等版本将扩展至5-10T参数。这些技术创新将成为新一代千问大模型的基石,据介绍,Qwen4模型正采用全新架构展开训练,Qwen4.5、Qwen5均在稳步推进中。公开数据显示,阿里已开

所属频道 大厂动态模型发布开源生态

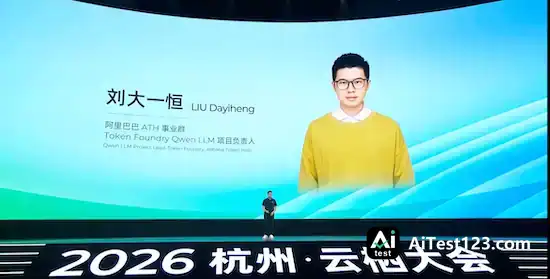
9月22日云栖大会上,阿里巴巴ATH事业群Token Foundry、Qwen LLM项目负责人刘大一恒对外介绍了千问大模型的多项新进展。
阿里发布Qwen4训练进展:新架构已开训,未来参数规模瞄准5-10T(配图 1)

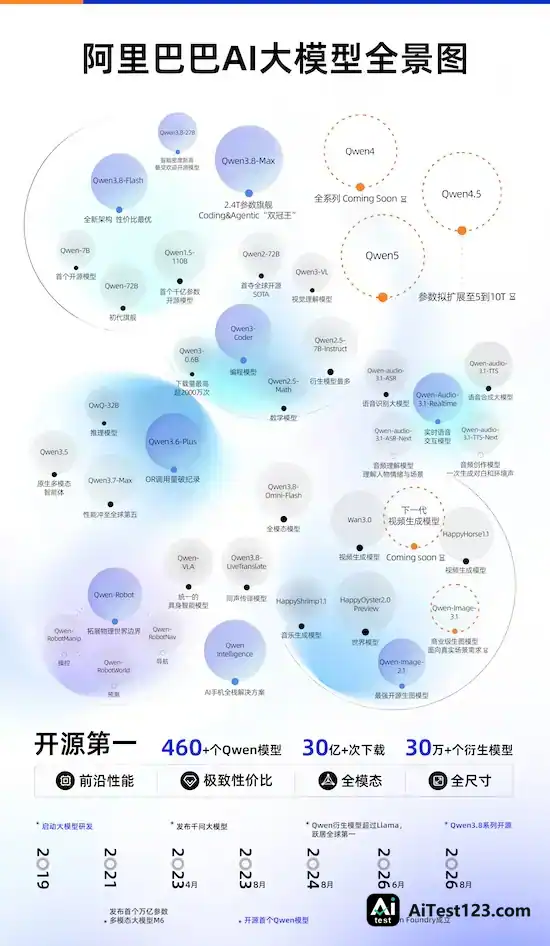
据他介绍,大模型的递归自我改进(RSI)已经在模型训练、推理以及芯模协同等环节初步落地。采用新一代架构的Qwen4目前正在训练,后续Qwen4.5、Qwen5等版本参数规模将扩展到5-10T。视频生成、语音、图像、世界、音乐以及全模态等模型,也都在当天或近期推出新版本。
阿里发布Qwen4训练进展:新架构已开训,未来参数规模瞄准5-10T(配图 2)

围绕更高智能,Qwen正加快自我进化

大模型正在朝自我迭代的方向走。这届云栖大会上,阿里集中展示了千问大模型在自我进化方面的最新成果。

模型自我训练方面,Qwen3.8-Max自己搭训练流程、造训练数据,还自己设计实验、找缺陷,在人类完全不参与的情况下连续迭代超过1个月,完成33轮有效迭代。RSI、后训练等技术联合优化之后,Qwen3.8-Max新版本在Artificial Analysis上的得分从40分升到45分,与Claude、GPT的最强模型同处第一阵营,排在GLM5.3、Kimi-K3等所有国产模型之前。

推理优化方面,面对此前没见过的平头哥新款GPU,Qwen3.8-Max自主完成下代架构Qwen3.8-Flash新模型推理框架的适配优化,单实例推理吞吐量提升96%。

芯片与模型协同设计方面,只给一份真实的总线模块规范,Qwen3.8-Max就自主跑完了前端、验证、后端的全链路自迭代。自主运行超过60小时、调用EDA工具超过万次之后,它完成了面积减少42%的物理实现优化。

阿里发布Qwen4训练进展:新架构已开训,未来参数规模瞄准5-10T(配图 3)

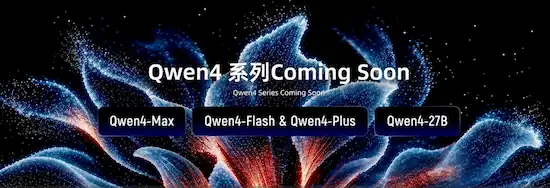
Qwen LLM项目负责人刘大一恒表示,Scaling是通往ASI的关键路径,Qwen4.5、Qwen5的参数规模计划迈向5到10T。

大会现场,阿里还展示了模型核心领域的多项技术创新。架构优化上,Qwen3.8-Flash提前开源了下一代千问大模型架构,靠注意力机制和模型内信息传递机制等核心创新,在做前沿模型性能的同时把训练成本压低近90%;加上极少的参数激活,推理计算效率被推到新的帕累托前沿,成了行业性价比的“斩杀线”模型。模态扩充上,全模态模型Qwen3.8-Omni正式亮相,音视频等不同模态被高效纳入统一理解框架,为大模型开辟新的思考分区。参数扩展上,参数越大性能依然越强,未来千问大模型总参数量将扩展到5万亿甚至10万亿规模。这些技术创新会成为新一代千问大模型的基石。据介绍,Qwen4正以全新架构展开训练,Qwen4.5、Qwen5也在稳步推进。

一边探索性能前沿,一边通过“全模态”“全尺寸”的开源,阿里把前沿AI技术红利分享给全球开发者和企业。在全球最大AI开源社区Hugging Face上,Qwen3.8-27B超过DeepSeek-R1、Meta-Llama3.1等史上热门模型,拿下该平台历史上最受欢迎(Most Likes)的开源大模型。公开数据显示,阿里已开源460余个Qwen大模型,Qwen开源模型下载量突破30亿次,衍生模型数超过30万个,稳居全球第一开源模型家族。

视听生成模型升级,全新视频生成模型拟11月发布

在创意最集中的视觉生成领域,阿里正持续迭代视觉生成模型,让AI产出更好的作品,也让用户获得更好的体验。

图像生成模型Qwen-Image-3.1亮相。它针对电商、创意、设计等真实商用场景做了全新优化,原本要数小时的视觉设计被压缩到秒级交付,水准堪比专业设计师,还支持图像精准编辑。

音乐生成模型Happy Shrimp推出1.1版,人声质量、音乐表现、多语种演唱和指令理解这四个专业维度都有升级,能生成人声歌曲和纯音乐两类内容,曲风超过百种,主流语言支持十余种。

世界模型最新版本HappyOyster 2.0 Preview亮相,模型架构、训练方法和数据体系全面升级,智能实时交互、记忆能力、实时响应、物理规律遵循等核心能力明显提升,世界模型开始从实验室走向真实可用。
阿里发布Qwen4训练进展:新架构已开训,未来参数规模瞄准5-10T(配图 4)
阿里发布Qwen4训练进展:新架构已开训,未来参数规模瞄准5-10T(配图 5)

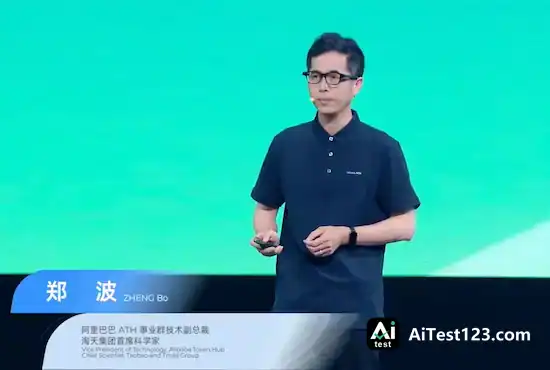
阿里巴巴ATH技术副总裁、淘天集团首席科学家郑波在云栖大会现场提到,三年内会出现一个原生全模态统一模型,体验将不再受模态边界的限制。

全新的下一代视频生成模型也将在11月发布,朝更长、更可控、更完整、更智能的方向演进:时间拉长之后,新模型依然能保持一致,创作者可以精准掌控人物、场景与镜头;模型还具备导演级的创作思维,从生成单个镜头走向理解完整叙事。

下代语音模型发布,Qwen落地多款智能终端

眼下,语音正成为AI与人之间更自然的交互入口,Qwen模型也在手机、AI眼镜、桌面机器人等硬件领域落地。

语音模型家族Qwen-Audio-3.1全面升级,包含语音转写(ASR)、语音合成(TTS)和实时语音交互(Realtime)三大系列。

基于下代架构的音频理解模型Qwen-Audio-3.1-ASR-Next全新发布。它能理解人物情绪、音乐、环境声与机械声,完成声音描述、事件定位、音频问答与推理,像“这段录音中人的情绪怎样”这样的问题也能被理解和准确回答。

音频创作模型Qwen-Audio-3.1-TTS-Next同时全新亮相。它采用全新架构,给一段脚本就能直接生成融合对白和环境声的完整音频,有声书、影视剧和播客等专业创作的效率由此大幅提高。

Qwen-Audio-3.1-Realtime的实时交互能力再进一步,能够边听、边想、边说,多语言交互、角色扮演和共情能力也有增强。目前,该系列模型已用于千问办公和Qoder,并接入QwenNote A2随身助理、QwenNote Eva桌面机器人和千问AI眼镜等硬件产品。

同声传译模型Qwen3.8-LiveTranslate这次是第一次亮相。人类同传的平均时延在4秒以上,这个模型能压到不到2.5秒。新模型已经装进千问AI眼镜、QwenNote A2、钉钉耳机等AI硬件里。

阿里的大模型正在往终端走。面向手机的AI全栈解决方案Qwen Intelligence已经发布,针对手机场景做了深度优化,给合作伙伴提供一个基于千问大模型的Agent技术平台,让手机更可靠地完成跨应用的复杂任务。
阿里发布Qwen4训练进展:新架构已开训,未来参数规模瞄准5-10T(配图 6)
这是阿里巴巴AI大模型的全景图。

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. 报告:中国模型领跑美国企业开源模型支出,Kimi占61%

    36氪获悉,硅谷知名风险投资机构门罗风投(Menlo Ventures)近日发布的《2026年企业AI现状报告》显示,美国企业用于开源模型的支出中,89%付给了中国模型。其中,Kimi占61%。报告基于对近400名美国企业人工智能业务负责人的调研,受访者负责的AI支出合计超过40亿美元。

    来源 AI 行业观察
  2. 门罗风投报告:美企开源模型支出89%流向中国AI

    (文/赖家琪 编辑/吕栋)在美国企业日益增长的人工智能(AI)开源模型需求中,中国模型已经占据绝对主导地位。美国知名风险投资机构门罗风投(Menlo Ventures)当地时间11月3日发布的《2026年企业AI现状报告》显示,在美国企业开源AI模型支出中,中国模型占比高达89%。其中,月之暗面的Kimi以61%的份额

    来源 腾讯网
  3. 美国企业开源模型支出89%流向中国:Kimi占61%,DeepSeek占15%

    美国企业花在开源大模型上的钱,近九成都流进了中国公司的口袋。 11月3日,硅谷风投门罗风投(Menlo Ventures)发布的《2026年企业 AI 现状报告》把这笔账算得很明白。基于对近 400 名美国企业 AI 业务负责人的调研,报告给出一个刺眼的数字:美国企业花在开源大模型上的支出,89%付给了中国模型。 拆开

    来源 AI 行业观察
  4. DeepSeek与GLM免费开放,黑客能力逼近OpenAI未公开模型

    据WIRED报道,一项模拟网络入侵实验显示,中国免费开放的AI模型DeepSeek与GLM在网络攻击技能上已逼近OpenAI最先进的网络安全模型,而后者并未公开。这一结果引发业界对开源模型“双刃剑”效应的担忧:能力越易获取,攻防之间的门槛就越模糊。

    来源 AI 科技快讯
  5. Thinking Machines 二代模型用上 Kimi 数据,400亿估值背后藏了什么

    OpenAI前CTO创立的Thinking Machines Lab发布Inkling 2 Small,技术博客坦承采样自月之暗面Kimi K3。这款594B参数模型在长程任务上表现强劲,但编程能力仍落后于DeepSeek和Kimi旗舰版。文章解析其“为微调而生”的商业逻辑,以及中国开源模型如何成为硅谷巨头的数据源。

    来源 AI 应用前沿
  6. ERNIE-5.5-Flash-Base开源:280B总参数,激活仅14B

    今天,我们发布 ERNIE-5.5-Flash-Base,开放 ERNIE 5.5 Flash 预训练终点的权重。 它是一个稀疏 MoE 语言模型,总参数 280B,每 token 激活 14B,在 33.5T tokens 上从零完成预训练;最长训练上下文为 128K,微调与推理支持 1M tokens 上下文。本次

    来源 AI 开发者社区
  7. Kimi 61%、DeepSeek 15%、GLM 11%:中国AI模型占企业开源支出89%

    IT之家 11 月 8 日消息,据《南华早报》前天报道,一项新研究显示,以月之暗面 Kimi 系列为代表的中国 AI 模型,在全球企业开源模型支出的占比为 89%,接近九成。 IT之家从原报道获悉,硅谷风投公司 Menlo Ventures 近期发布的报告指出上述观点。其中月之暗面 Kimi 以 61% 份额,在全球企

    来源 AI 行业观察
  8. Harness Adapters:用安全强化学习提升智能体开发效率

    Hugging Face 团队发布了 Harness Adapters,这是一种基于 LoRA 的轻量级适配器,通过强化学习(RL)在 pi、opencode 和 hermes 等智能体框架中训练。核心创新在于引入 safeagents 代理,实时拦截并阻断模型试图“作弊”的工具调用,确保训练安全。实验显示,该方案能在

    来源 AI 应用前沿
  9. WinUI 3 原生注册表编辑器亮相:界面告别 Win95 风格

    IT之家 11 月 8 日消息,科技媒体 Windows Latest 今日发文,报道称微软开源项目仓库 Microsoft.UI.Reactor 中出现一款原生 WinUI 3 注册表编辑器。该媒体编译后发现,这款注册表编辑器确实能使用,界面告别了 Win95 时代设计,看起来非常现代。IT之家从原报道获悉,微软仅在

    来源 腾讯网
  10. 英伟达Cosmos 3开源四模型:160亿参数赋能自驾与机器人仿真

    英伟达发布了Cosmos 3系列的四个新开源权重模型,涵盖自动驾驶多传感器数据生成、实时流式仿真、模拟器渲染及双手机器人动作预测。这些160亿参数模型基于OpenMDW1.1协议,允许商业使用,旨在帮助开发者构建更真实的交互式世界模拟环境,降低自动驾驶和机器人训练的数据成本。

    来源 AI 应用前沿
  11. 姚顺雨执掌混元后首度大招聘:青云课题165岗、社招60余岗

    “这会不会是腾讯AI史上非常重要的一年?”伴随新模型Hy4发布,讨论声涌来。在此之前,腾讯混元发布模型时表述都较平实谦逊,但这一次发布博客中却颇有信心写道:Hy4已跻身全球第一梯队开源模型行列。底气聚焦在姚顺雨身上。这位1998年出生的年轻人,2025年底正式任腾讯首席AI科学家,彼时接手能力尚缺的Hy2,主导推出Hy

    来源 腾讯网
  12. 腾讯云MaaS:混元评测、TI-ONE推理与Token成本三线并进

    过去几年,大模型厂商发布新产品,总少不了一张密密麻麻的 Benchmark 成绩表。但当模型真正进入工作场景,评判标准就没那么简单了。 今年 3 月,一项研究分析了 43 套 Agent 评测基准,涉及超过 7.2 万项任务,并与美国劳动力市场的 1016 种职业进行对照。结果发现,现有评测高度集中于编程等计算机相关任

    来源 AI 行业观察
  13. Gemini Omni 1.2 Flash上线:原生15秒视频,价格降30%

    感谢IT之家网友 愚公骑马、乌蝇哥的左手 的线索投递! 谷歌正式推出 Gemini Omni 1.2 Flash 视频生成模型,并在 Gemini API 与 Gemini for business 平台全面开放使用。 新版模型实现了原生 15 秒视频生成、多轮对话式编辑、更强的参考遵循能力,同时较 1.1 版本降价

    来源 AI 开发者社区
  14. 腾讯云MaaS:混元研发体系重组后,模型如何落到真实业务

    作者 | 土豆过去几年,大模型厂商发布新产品,总少不了一张密密麻麻的 Benchmark 成绩表。但当模型真正进入工作场景,评判标准就没那么简单了。今年 3 月,一项研究分析了 43 套 Agent 评测基准,涉及超过 7.2 万项任务,并与美国劳动力市场的 1016 种职业进行对照。结果发现,现有评测高度集中于编程等

    来源 腾讯网
  15. MiniMax闫俊杰谈AGI:中美模型差距剩5%,效率与开源是关键

    “最后这5%的差距,可能比完成前面95%要难得多。” 在最近发布的一期英国播客《Invest in Progress》中,MiniMax创始人闫俊杰谈到了中国大模型追赶美国同行的难度。 与他对谈的是Scottish Mortgage投资经理劳伦斯·伯恩斯(Lawrence Burns)。2025年12月,伯恩斯到中国拜

    来源 AI 行业观察
  16. 淘宝MNN 团队开源 MNN-Pocket-0.3B,iPhone 18 Pro 离线解码飙升至 350 token/s

    人工智能端侧部署领域迎来重磅进展。淘宝旗下 MNN 团队正式宣布开源面向手机应用的轻量化大语言模型 —— MNN-Pocket-0.3B。该模型拥有约3亿参数,专为手机等移动设备的资源预算与任务需求量身打造,在极低的内存占用和能耗下,实现了媲美云端的高速响应与出色的综合任务能力。 极致轻量化设计:体积缩减近半,峰值内存

    来源 AI 开发者社区
  17. 中国开源模型拿走美国企业89%支出,Kimi一家占61%

    门罗风投报告显示,美国企业89%的开源大模型支出流向中国公司。尽管开源价格下降,但用量激增推动其成为主流。DeepSeek和Kimi在调用量与支出上占据主导,反映美国企业对中国开源AI的高度依赖及投入增长。

    来源 36氪
向下滚动自动加载更多