门罗风投报告:美企开源AI支出,89%流向中国模型
另一个原因在于,报告提到,开放权重模型为开发者提供了闭源模型难以给予的控制权,企业可以在此基础上进行后训练,使模型适配自身业务,以降低成本并减少对头部模型公司的依赖。
门罗风投(Menlo Ventures)在11月3日(当地时间)发布了《2026年企业AI现状报告》,观察者网赖家琪、编辑吕栋对相关内容进行了梳理。
美国企业在开源AI模型上的需求持续走高,而在这一领域,中国模型已占据绝对主导位置。
上述报告给出的数字是:美国企业的开源AI模型支出中,中国模型拿走了89%的份额。
从具体厂商看,月之暗面Kimi以61%排在首位;DeepSeek紧随其后,占15%;智谱GLM为11%,阿里巴巴通义千问(Qwen)为3%。西方开源模型中用量最高的Meta旗下Llama,份额只有7%。
报告的核心数据来自门罗风投委托Morning Consult做的调查。调查时间为今年9月8日至9月26日,对象是400名美国企业决策者,这些人掌管的AI支出合计超过40亿美元。
调查结果显示,2026年企业在AI应用上的开销从上一年的330亿美元涨到1770亿美元。其中流向Anthropic、OpenAI和谷歌三家模型的钱为1227亿美元,占比由去年的50%升至69%。
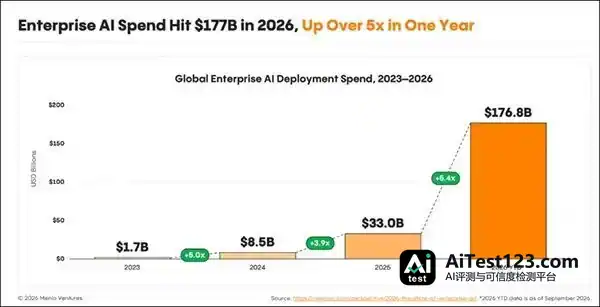
开源模型的涨势同样突出,占比从11%提高到19%。使用量方面,2025年9月至2026年9月,开源模型的Token消耗量增长22.5倍,达到每月约2900万亿个Token,这一增速高于闭源模型的12.1倍。
价格是开源模型用量猛增的原因之一。其平均Token价格下降3.3倍,来到每百万Token约0.13美元;闭源模型的平均价格则为每百万Token约0.70美元。
报告还提到另一层原因:开放权重模型给了开发者闭源模型难以提供的控制权。企业能在此基础上做后训练,让模型贴合自身业务,既压低成本,也减少对头部模型公司的依赖。
不过这个市场还处在早期。2026年,采用后训练技术的AI开发者比例只从2025年的6%升到10%;已经开展后训练的开发者里,91%要依靠外部合作伙伴。
报告专门举了一个例子:美国AI编程公司Cursor以中国开源模型为基础,由Fireworks提供推理基础设施,支撑强化学习过程中的模型调用。
这说明中国模型的影响不只在直接服务海外用户这一层,其开源模型也正成为美国AI企业开发自家产品的底层技术基础。
报告还认为,智能体(Agent)发展很快,正在改变企业调用AI模型的方式,也是拉动需求增长的一个重要因素。
智能体和传统聊天机器人不一样,它能独立完成复杂的多步骤任务,并行处理工作,人工干预很少也能持续运行。智能体承担的实际工作越多,企业调用模型的频率和Token消耗量也就跟着大幅上升。
数据可以佐证:在OpenRouter平台上,智能体贡献的Token使用量已占80%,约为人类用户使用量的7倍。智能体流量自今年2月超过人类用户以来,已增长37倍。换句话说,AI模型的主要使用者正从向AI提问的人,变成用AI自主执行任务的机器。
报告指出,智能体的运行机制决定了AI支出更多取决于实际完成的工作量,而不是企业员工或用户的数量。
这一趋势给开源模型带来了新的市场机会。智能体运行会产生大量Token消耗,开源模型在推理成本上的优势,使其更适合承接规模化、高频次的模型调用。企业若想控制AI运营成本、减少对少数头部模型供应商的依赖,中国开源模型的应用范围有望进一步扩大。
对于未来,报告预计,随着智能体能执行时间跨度更长的任务、更多使用计算机,以及多智能体协同工作的实现,由智能体驱动的企业AI市场会继续增长。