淘宝MNN开源0.3B手机模型:iPhone 18 Pro离线解码350token/s
淘宝旗下 MNN 团队今日发布了 MNN-Pocket-0.3B 模型,面向手机应用的任务需求与资源预算,在有限算力、内存和能耗下,兼顾任务能力、响应速度与持续运行体验。
11月6日,淘宝旗下MNN团队发布MNN-Pocket-0.3B模型。这款模型针对手机应用的任务需求和资源预算设计,要在算力、内存、能耗都有限的前提下,把任务能力、响应速度和持续运行体验一并照顾到。
团队面向淘宝这类综合型手机应用,把「手机应用原生大模型」拆成四个维度的设计目标。
速度方面,要求在指定设备与上下文配置下,解码吞吐超过200token/s。这个目标参照的是高速云端模型服务的生成吞吐,目的是让本地生成也足够流畅。
内存方面,指定测试条件下峰值内存要低于300MB。手机即使有8~16GB内存,也得由系统和多个应用分着用。按约500MB的模型模块预算来算,把推理峰值压到300MB以下,就能给上下文增长和集成开销留出余量。
功耗方面,典型推理负载(输入512~1024token、输出128token)下,单次推理的增量能耗目标不超过参考手机电池能量的万分之一,也就是100次推理的耗能不超过电池总量的1%,以此控制高频调用带来的续航开销。
能力方面,目标是在指定业务场景上达到8B级模型的效果,中英文理解、世界知识与数学、代码推理都要兼顾,重点强化指令遵循,同时为长上下文和多步骤任务留出扩展空间。
这个约3亿参数、重点支持中英文的轻量语言模型由MNN团队从零设计并训练。模型结构、词表、训练数据、预训练与后训练方法,以及量化和推理引擎都做了协同优化,目的是给淘宝业务和开源社区开发者一个能理解任务、响应快、容易适配和集成的模型底座。
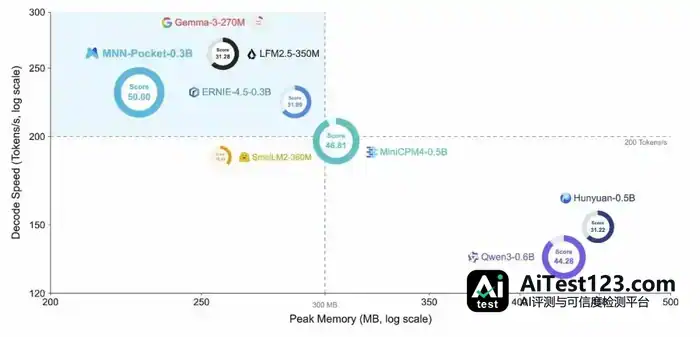
真机实测在苹果iPhone 18 Pro上进行,模型经MNN推理引擎完全离线运行,平均解码(Decode)速度约350token/s。

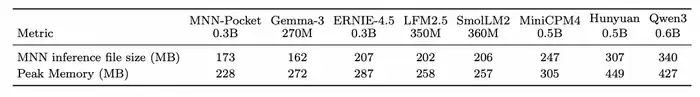
MNN-Pocket-0.3B的INT4 MNN部署文件只有173MB,模型权重、分词器、计算图和推理配置都包含在内。
在iPad Pro M5、Metal后端、512token测试配置下,模型加载与推理期间的峰值Metal驻留内存,比加载前的基线多出228MB。
同一测试里,Qwen3-0.6B的部署文件为340MB,峰值内存增量427MB。两相比较,MNN-Pocket-0.3B部署体积少约49%,峰值内存增量少约47%。
对手机应用原生大模型来说,部署体积小,模型下载与更新的成本就低;运行内存占用少,页面、图片、视频等业务模块就能多留一些空间,应用集成的资源负担也随之下降。
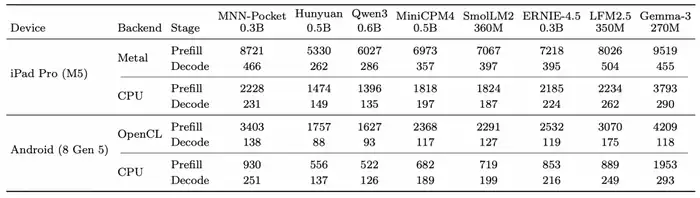
团队在苹果与Android设备上,用Metal、OpenCL和CPU后端评估推理吞吐。测试统一采用MNN 3.6.2、INT4量化和相同的运行设置,每组配置预热一次、测量五次取吞吐中位数,Prefill与Decode分开测量。
在iPad Pro M5/Metal、512token测试配置下,MNN-Pocket-0.3B的Prefill吞吐为8,721token/s,Decode吞吐为466token/s,约是同条件下Qwen3-0.6B(286token/s)的1.63倍。换到Snapdragon 8 Gen 5的CPU后端,Decode吞吐为251token/s。
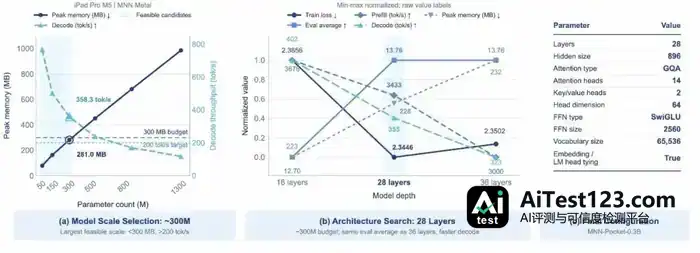
团队把峰值内存低于300MB、解码吞吐高于200token/s定为手机应用原生大模型的架构选型目标,想在资源预算内尽量保住模型容量。为此构建了约50M至1.3B参数的稠密(Dense)模型配置,在iPad Pro M5、统一推理设置下测试。约300M是这组实验里同时满足两项约束的最大候选规模。
规模定下来后,团队又在相近参数预算内联合调整模型深度、隐藏层宽度、前馈网络与注意力配置。层数从16层加到28层,能力有提升;再加到36层,评测均分不再上涨,解码吞吐反而从355token/s掉到323token/s。这里的吞吐只用于架构选型对比,和前面最终部署版本的测试配置并不相同。
最终MNN-Pocket-0.3B采用28层结构,搭配分组查询注意力(GQA)等配置,在模型能力、运行内存与推理效率之间取得平衡。
面向中文互联网手机应用,MNN-Pocket-0.3B把中英文列为重点支持语言,其他语言的分词效率则降低了优先级。团队基于Qwen3分词器,把词表从约151K精简到64K,词条数量缩减约57%,词嵌入与输出层的参数和存储需求随之减少,逐Token生成时的输出投影开销也降了下来。
能耗测试在一加13(骁龙8至尊版)上进行,团队用MNN对MNN-Pocket-0.3B的4-bit模型做了功耗测试。CPU4线程、输入1024和输出128的基准负载下,采集电池电流与电压并扣除闲置基准耗电,三轮测试折算的平均增量能耗约2.7J/轮。按该手机6000mAh电池容量计算,执行100次同等负载任务,累计增量能耗约占电池总电量的0.3%。
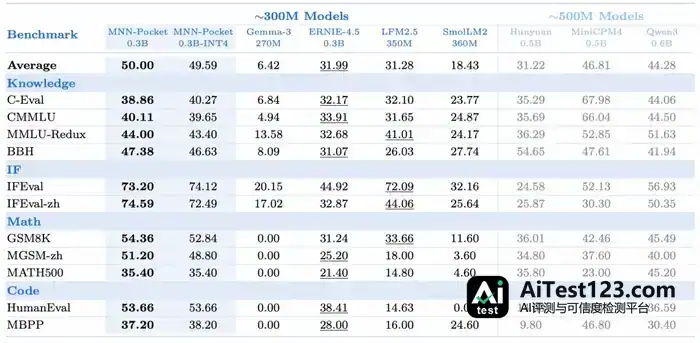
模型能力上,按技术报告采用的评测设置,MNN-Pocket-0.3B的英文IFEval得分为73.20,团队构建的中文指令遵循IFEval-zh得分为74.59,在所比较的模型里都是最高分。
在覆盖中英文知识、推理、数学、代码与指令遵循的11项评测中,模型平均得分50.00,高于报告列出的同规模模型,也高于MiniCPM4-0.5B、Qwen3-0.6B等规模更大的对比模型。其中中文数学MGSM-zh得分51.20,代码生成HumanEval得分53.66。
端侧原生大模型到底有多少用,还得看任务适配和应用集成做得怎么样。MNN-Pocket-0.3B 为此放出了预训练、后训练、端侧部署等多个版本,研究者和开发者可以挑一个合适的起点,接着训练、评测,再搭自己的应用。
从研究到部署,MNN 团队把不同阶段的模型入口都开源了:
| 模型版本 | 主要用途 |
MNN-Pocket-0.3B-Base | 继续预训练、领域适配与基础能力研究 |
MNN-Pocket-0.3B-SFT | 后训练研究、强化学习、蒸馏与消融实验 |
MNN-Pocket-0.3B | 通用指令调用与业务任务适配 |
MNN-Pocket-0.3B-MNN | W4A16 QAT 端侧部署版本,配合 MNN 推理引擎的低比特算子与硬件后端优化,在特定设备上解码吞吐可达 466 token/s |
MNN-Pocket-0.3B-DFlash2 | DFlash2 投机解码草稿模型,配合 MNN 推理引擎的块级生成与验证实现,在特定任务下解码吞吐可达常规自回归解码的 2.06 倍 |
MNN-Pocket-0.3B-Dec | 通过决策头完成候选选择类任务 |
开源地址如下: