美团LongCat-2.5开源:1.6万亿参数、百万上下文,商用免授权

资讯 IT之家 全文 614 字 · 约 2 分钟读完 配图 1 张 分类美团开源算力网络

模型总参数 1.6 万亿,每个 token 激活约 480 亿参数,支持一百万上下文。针对显存与带宽受限的国产算力芯片,团队在模型架构、芯片适配与部署策略上也进行了深度协同优化。

所属频道 大厂动态算力与芯片开源生态

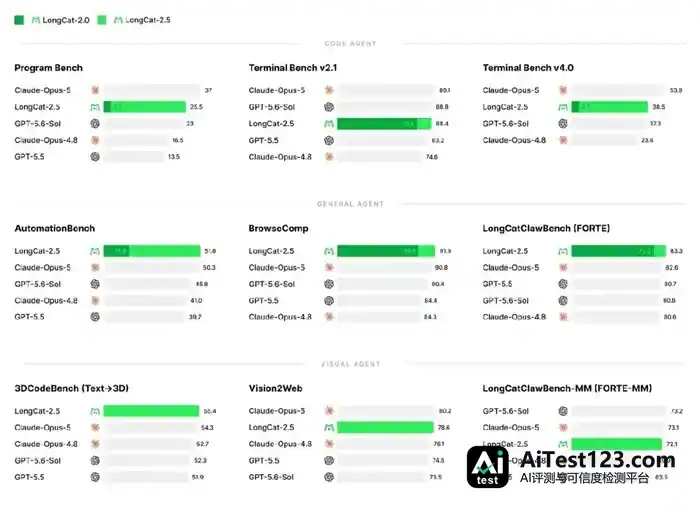
美团龙猫在11月2日推出LongCat-2.5,这是一款面向长程智能体任务的原生多模态模型。到了11月9日,美团宣布该模型正式开源。模型采用MIT协议,商用推理部署和二次训练都不需要额外授权。在复杂代码库开发、完整项目构建、Visual Coding以及专业办公等场景里,它的端到端交付能力都有明显提升。

参数规模上,LongCat-2.5总参数为1.6万亿,每个token激活约480亿参数,上下文长度支持一百万。针对显存与带宽受限的国产算力芯片,团队还在模型架构、芯片适配和部署策略上做了深度协同优化。
图片

按照官方介绍,LongCat-2.5在Visual Coding上表现突出,能支持创意设计、3D等任务。这些提升源于视觉表征层的改造:视觉信号被表示为多层级离散token,跟文本一样交给主干模型统一处理,而不是另挂一个视觉模块。具体做法是,对原生分辨率视觉特征做残差向量量化,逐级补足细节;视觉token可以离线预计算并缓存,在线计算量因此减少,分布式训练的负载也更均衡;视觉码本与主干联合训练,视觉和文本共用同一套主干参数,在同一语义空间里协同完成视觉理解与代码生成。

推理方面,LongCat-2.5采用W4A4高效方案,专家权重与激活同时量化到4 bit,计算通过原生INT4矩阵乘法单元执行。

有关链接如下:

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. OpenAI们成苹果真正对手,Siri落后或重演诺基亚剧本

    按照规划,苹果将在明年推出可执行复杂任务的自主型Siri,以追赶OpenAI、Meta等头部大厂的脚步。外界则认为,苹果正在耐心等待AI泡沫破灭后进场抄底,以低价收购潜在竞争对手的模型与算力设施——否则,它的Siri将永远由第三方驱动。

    来源 TechWeb
  2. OpenAI们成了苹果真正的对手,Siri落后或重演诺基亚困局

    按照规划,苹果将在明年推出可执行复杂任务的自主型Siri,以追赶OpenAI、Meta等头部大厂的脚步。外界则认为,苹果正在耐心等待AI泡沫破灭后进场抄底,以低价收购潜在竞争对手的模型与算力设施——否则,它的Siri将永远由第三方驱动。

    来源 TechWeb
  3. 马斯克携手黄仁勋:StarMind太空算力2027年Q3入轨

    在纽约举行的第33届巴伦投资者大会上,马斯克公布了一份时间表:SpaceX与黄仁勋的NVIDIA联合设计的首批StarMind太空计算设备,计划于2027年第三季度发射入轨,并在2028至2029年进入大规模部署阶段。

    来源 TechWeb
  4. 马斯克与黄仁勋合作StarMind:2027年Q3发射入轨

    【TechWeb】在纽约举行的第33届巴伦投资者大会上,马斯克公布了一份时间表:SpaceX与黄仁勋的NVIDIA联合设计的首批StarMind太空计算设备,计划于2027年第三季度发射入轨,并在2028至2029年进入大规模部署阶段。 这一合作的核心硬件并非地面常见的通用服务器,而是NVIDIA的Vera Rubin

    来源 AI 行业观察
  5. 数据中心建设遇阻:纳指跌5.52%,新云公司股价腰斩

    北京时间11月6日凌晨,纳指收跌5.52%。AI芯片股遭到抛售,几家做数据中心生意的公司跌了两位数。市场担心,原先计划中的数据中心,可能没法按时开工了。 大厂还在花大价钱抢算力,可随着数据中心在各地推进项目,阻力也越来越大了。动辄几十亿、上百亿美元的项目,原本是地方政府抢着要的。数据中心到底触犯了什么“天条”? 起初,

    来源 AI 行业观察
  6. 长电科技领衔400亿扩产,先进封装还卡在哪?

    AI算力和高端存储的需求增长,带动了国内外先进封装行业的一轮大规模扩产。长电科技、通富微电、华天科技、甬矽电子、盛合晶微、深科技、佰维存储等中国大陆厂商在内的全行业,投资总额已超400亿元。扩产方向....

    来源 腾讯网
  7. 阿里云栖大会:Qwen4已在训练,Qwen4.5、Qwen5将扩至5-10T参数

    据介绍,大模型递归自我改进已初步进入模型训练、推理及芯模协同等环节中,基于新一代架构的Qwen4已在训练中,未来Qwen4.5、Qwen5等版本将扩展至5-10T参数。这些技术创新将成为新一代千问大模型的基石,据介绍,Qwen4模型正采用全新架构展开训练,Qwen4.5、Qwen5均在稳步推进中。公开数据显示,阿里已开

    来源 TechWeb
  8. 阿里发布Qwen4训练进展:新架构已开训,未来参数规模瞄准5-10T

    据介绍,大模型递归自我改进已初步进入模型训练、推理及芯模协同等环节中,基于新一代架构的Qwen4已在训练中,未来Qwen4.5、Qwen5等版本将扩展至5-10T参数。这些技术创新将成为新一代千问大模型的基石,据介绍,Qwen4模型正采用全新架构展开训练,Qwen4.5、Qwen5均在稳步推进中。公开数据显示,阿里已开

    来源 TechWeb
  9. 腾讯优图DSpine开源:并行草稿逐层接力,SGLang吞吐最高提升4.01倍

    在大型语言模型(LLM)的无损推理加速中,推测解码(Speculative Decoding)已成为工业界标配。以 EAGLE-3 为代表的自回归草稿模型虽然预测准,但每多猜一个 token 就要多跑一步串行前向;而受扩散语言模型启发的 DFlash 将草稿生成彻底并行化 —— 一次骨干网络前向即可同时吐出整块候选 t

    来源 腾讯网
  10. 谷歌伦敦数据中心遭骑行者和昆虫爱好者联合阻挠

    欧洲数据中心抗议潮再添新案例。在伦敦以东,一群看似毫不相干的抗议者——骑行者、昆虫爱好者和当地居民——组成联盟,试图阻止谷歌建设一座大型数据中心。这场不对称的对抗,折射出AI算力扩张与社区利益之间日益尖锐的矛盾。

    来源 AI 科技快讯
  11. 微软数据中心工地遭闯入150人被捕,欧洲多国抵制扩张

    11月6日,阿姆斯特丹郊外,微软数据中心的工地乱作一团。 图为荷兰微软AI数据中心工地遭抗议者闯入 图源:社交媒体截图 数百名抗议者冲破围栏闯入施工现场,有人爬上起重机吊臂悬挂标语,警方现场介入,拘留了150余人。 这场冲突不是孤立事件。 短短几天内,欧洲多国同步发起示威,美国中期选举把数据中心的建设节奏推到竞选台面,

    来源 AI 行业观察
  12. 欧美数据中心建设受阻:算力扩张遇成本难题,行业走向生变?

    AI的尽头是什么?是房地产。 如果说两年前还有人质疑这个说法,那么两年后的今天,数据中心建在哪里?怎么建?已经成为头部AI企业们最头疼的问题。11月6日至7日,由“停止肮脏数据中心”联盟发起的抗议席卷欧洲,欧洲多个国家都有大量民众走上街头抗议AI数据中心的建设,谷歌欧洲总部所在地都柏林,数千人走上街头,游行至爱尔兰议会

    来源 AI 行业观察
  13. 算力许可冻结叠加SpaceX退出条款:AI产业格局面临洗牌

    Chamath认为,SpaceX与Anthropic合同中藏有“90天双向退出条款”——一旦算力供给收紧,马斯克可将算力重新定价至原合约2-3倍,直接决定Anthropic生死及整个AI格局走向。此外,吉瓦级数据中心项目出走风险陡升,美国或从算力出口国沦为Token进口国。

    来源 华尔街见闻
  14. 德意志银行研报:SpaceX政治风险被高估,算力越紧张越赚钱

    德银认为,SpaceX政治风险被市场高估——核心合同由联邦行政机构签订,国会干预空间极为有限,且多数业务领域无可替代供应商。最直接风险来自得州候任州长对数据中心的强硬表态,但算力供给收紧反可能推高SpaceX定价能力与收入。

    来源 华尔街见闻
  15. AI扩张卡在电工荒:燃气轮机排到2031,变压器交期128周

    AI 基建瓶颈几经转移:从 GPU、电力、电气设备,如今落到电工等施工人力。资本可买断设备排期,却无法压缩技工数年培养周期。这场 AI 竞赛,正从资本密集转向人力密集,人力供给约束,或将决定算力扩张长期上限。

    来源 AI 行业观察
  16. Anthropic 34亿美元购入1.7吉瓦发电机,IPO前自建电力

    Anthropic于2026年9月与OnePWR Solutions签署34亿美元合同,购入1.7吉瓦重型燃气发电机及工程安装能力。该交易在IPO前夕披露,是已知AI实验室最大单笔自建电力采购。公司已承诺到2045年算力支出接近9000亿美元,此举标志其从依赖合作方转向能源自主。媒体报道聚焦AI竞赛向能源主权延伸,反映

    来源 AI 科技快讯
  17. 华为昇腾+深圳大数据研究院:ASP调度让RL训练提效222%

    在 LLM RL 训练里,生成正在变成最耗时的环节。当模型输出越来越长,训练阶段面对的是算力约束,增加训练卡数可以有效缓解算力压力,但推理部分是受限于显存带宽,往单个推理实例上继续堆卡,很快就会撞上扩展性的天花板。在训推混合的框架上,继续堆算力只会造成更多的算力资源浪费。深圳市大数据研究院团队与华为联合研发的 ASP(

    来源 腾讯网
向下滚动自动加载更多