墨芯完成近10亿元C+轮融资:稀疏推理芯片商业化提速

资讯 量子位 作者:思邈 全文 2123 字 · 约 6 分钟读完 配图 4 张 分类DeepSeek深度求索财报芯片Deepseek

Q3营收实现数倍增长

所属频道 算力与芯片融资与资本开源生态

第三季度营收较去年同期增长数倍。

近日,墨芯人工智能完成近10亿元人民币C+轮融资。

距离上一轮近10亿元融资只隔了5个月,两轮融资在短时间内接连落地,说明资本市场看好这家公司在专用稀疏推理芯片上的技术壁垒和商业化进展。

靠着技术积累与产品落地形成的先发优势,加上商业化全面提速,墨芯抢在推理算力需求集中释放的窗口期站住了位置,稀疏专用推理芯片的代差优势也进一步显现。

押注稀疏计算,墨芯走了一条差异化的芯片路线。
墨芯完成近10亿元C+轮融资:稀疏推理芯片商业化提速(配图 1)

大模型技术架构还在持续演进,稀疏计算也因此从一项辅助优化手段,逐渐走到AI算力设计的重要位置。

混合专家(MoE)架构加速应用,大模型推理呈现出明显的条件计算特征;权重与激活中的稀疏结构,同样给减少冗余计算留出了空间。

以DeepSeek-V4-Pro为例,总参数约1.6万亿,处理每个词元时只激活约490亿参数,约占总参数量的3%。

模型层面省下来的计算,怎么变成实际的推理效率提升和成本下降,正成为AI算力发展需要解决的关键问题。

要高效处理这类负载,芯片架构怎么选是关键变量。

通用GPU要兼顾训练、推理、科学计算等多类负载,很难针对特定稀疏模式做算法与硬件的深度协同优化。

面向稀疏推理的专用芯片则不同,它可以通过算法、编译器与硬件的协同设计,减少无效计算和数据搬运开销。产业界正在重新评估这一架构差异的价值。

墨芯长期深耕的正是这个方向。公司2018年成立,一直专注稀疏计算,发明了“权重稀疏化+激活稀疏化”双稀疏算法,并以此为基础上逐步形成“算法-软件-硬件”协同设计的技术体系。

要把这套技术体系做成成熟芯片产品,得具备贯通算法、编译器、芯片架构与软件工具链的全栈工程能力。

墨芯创始团队成员来自卡内基梅隆大学以及英特尔、高通、Marvell等顶尖半导体公司,算法研究与芯片工程背景兼备,拥有数十款产品、超50亿颗芯片的量产经验。

靠这套工程能力,墨芯产品的效能表现已在国际权威基准测试中得到验证。

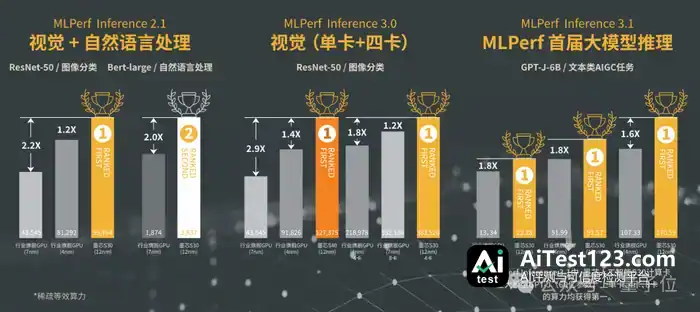
在MLPerf™ Inference测试中,S30计算卡在所参与的部分测试类别里连续三届夺冠;计算机视觉、自然语言处理等主流任务中,其能效比与单位算力推理吞吐量保持行业领先,专用稀疏推理方案在真实数据中心负载下的工程可行性由此得到验证。

多场景落地与生态共建,稀疏计算迈入新阶段。

规模化部署,正进一步巩固墨芯在稀疏推理芯片领域的领先地位。
墨芯完成近10亿元C+轮融资:稀疏推理芯片商业化提速(配图 2)

墨芯基于自研芯片构建的推理集群,已在西北、西南、华东、华北四大片区战略性铺开。商业化也随之全面提速:

2026年第三季度营收实现数倍增长,稀疏算力正深度融入我国算力体系建设,服务智能产业发展。

具体来看,在助力新型算力基础设施建设方面,墨芯参与了上海国资平台公司打造的国内首个海上算力Token工厂项目。

第三季度营收较去年同期增长数倍。
墨芯完成近10亿元C+轮融资:稀疏推理芯片商业化提速(配图 3)

近日,墨芯人工智能完成近10亿元人民币C+轮融资。

该项目靠海上风电绿电和海水冷却压低PUE与电费,不过通用GPU的推理开销仍可能把绿电省下的钱吃掉。墨芯的打法是用稀疏架构配合算力混合异构,从芯片侧压低单Token推理成本,让绿电降本和架构降本叠在一起。

在时空AI与时空大数据这些前沿方向上,墨芯用稀疏算力为时空大数据智能计算等应用搭起了性价比更高的算力底座。

墨芯还与北京大学上海临港国际科技创新中心地球与空间技术研究院合作,依托自研稀疏化技术,把两款国际主流遥感影像智能分析基础模型放到墨芯算力卡上完成了适配与实测:

业务精度几乎不掉、下游任务也不用重新训练,推理吞吐最高提升2.88倍,模型压缩最高到7.64倍。

也就是说,模型层面省下来的计算,经过软硬件协同能变成实打实的处理效率,大规模遥感影像解译可以用更少算力、更短时间做完。稀疏算力承接地理空间基础模型推理,也因此有了工程层面的验证。

真实业务需求一步步融进芯片设计与软件研发,墨芯再把技术积累和规模化部署经验转成持续迭代的能力,推动稀疏专用推理芯片从“可用”走向“好用”。

产品迭代上,新一代板卡SP200会在年底前正式推出。

适配生态上,升级版软件栈SECA(Sparse-native Efficient Computing Architecture)稀疏原生高效计算架构即将发布,对大模型推理部署和集群运维的支持会更强,模型迁移与部署的门槛也会进一步降低。

墨芯还把技术优势延伸到生态层面,继续抬高自己在稀疏计算领域的影响力。

今年8月,墨芯发起成立“稀疏计算产学研联盟”,盯住前沿研究、关键技术突破与成果转化,把自身技术积累和产业实践变成行业协同创新的底子,推动稀疏计算技术往前走。

大模型的竞争,正从“算得更多”转向“算得更聪明”。

模型规模越扩越大,算力成本与能耗的约束也越来越紧,行业的核心命题已经变了:

怎么用更少的计算,承载更多的智能。

稀疏计算,正是对这一命题的直接回答之一。

墨芯的价值,在于为中国AI芯片参与下一阶段竞争提供了一条差异化的技术路径。

*本文系量子位获授权刊载,观点仅为原作者所有。

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. DeepSeek Harness插件系统被吐槽 负责人承诺升级:一切都会好起来

    然而一切接插件的生态也导致了另一个严重的问题,那就是插件与DSH的兼容性,DSH官方源码页面上一直在提示会有破坏性更新,搞过DSH插件的开发者都很头痛这个问题,DSH版本一升级,插件不只是能不能用的问题,甚至可能搞得DSH崩溃,启动不了,这会影响工作。

    来源 凤凰科技
  2. Kimi与DeepSeek开始换打法了吗

    一个意外出圈的模型,一支新成立的产品团队。 作者丨李娜 编辑丨岑峰 受访者周宁(化名)向我们谈起为什么加入Kimi时,给了一个挺有意思的理由:“感觉 Kimi 还是有很多可以 storytelling 的地方,而 DeepSeek 给人的感觉更极客,甚至有点 nerdy。(对外表达欲低,行事非常低调)” 这大致符合外界

    来源 AI 行业观察
  3. DeepSeek日活破百万,Agility上市与人形机器人商业化冷思考

    2026年11月AI圈动静不小:DeepSeek Harness日活达154万,Inkling 2 Small在ARC-AGI测试中拿到高分并计划开源。硬件方面,Agility Robotics成为美国首家人形机器人上市公司,但商业模式仍受质疑;中国移动千亿投入算力基建。与此同时,科技巨头的数据中心扩建在美国多地遭遇社

    来源 AI 应用前沿
  4. DeepSeek模型自我改写:7层激活读脑,AIME涨7分

    新智元报道 AI看着自己的脑子改写自己,这一天还是来了!7630亿参数的DeepSeek-V4.1-Flash,直接读取了自己做数学题时最深7层的内部激活状态。摸清「快要算偏」的信号规律后,它在不改半个权重的前提下,亲手写了一段Python代码塞进推理流程「读脑自救」!只要发现思路跑偏就当场回滚重算,在AIME与HMM

    来源 腾讯网
  5. 154万人玩出花,DeepSeek Harness长出3.5万插件

    出品 | 网易智能 作者 | 小扣 编辑 | 王凤枝 DeepSeek最近在鼓励用户给自己的AI加点新功能:工作里缺什么趁手工具,或者纯粹为了好玩、想把惦记已久的小点子变成真东西,都可以试着让AI帮忙做出来。 据团队披露,截至11月4日,在使用官方API的用户中,Harness日活跃用户已达154万;第三方插件约3.5

    来源 AI 行业观察
  6. DeepSeek-V4.1-Flash私有化落地:四档硬件配置与三年成本测算

    企业想把大模型搬进自家机房,DeepSeek-V4.1-Flash是个热门选项。本文不谈虚的,直接拆解8卡服务器的显存怎么算、FP8量化会不会掉精度、三年到底花多少钱。通过一个制造集团的真实案例,对比商业授权与自建的成本差异,给出从硬件采购到性能验收的完整避坑指南。

    来源 AI 应用前沿
  7. 梁文锋与西蒙斯:从量化到DeepSeek的思想线索

    千亿量化之神,给梁文锋留下了哪些精神遗产?整理|《中国企业家》记者 孙欣见习编辑|李原头图来源|视觉中国2021年2月,一本名为《征服市场的人:西蒙斯传》的书在中国出版。为它写推荐序的人,是当时只在私募圈小有名气的幻方量化创始人梁文锋。没人想到,四年后,他会以DeepSeek创始人的身份震动世界——而他所撰写的题为《创

    来源 腾讯网
  8. 中国开源模型拿走美国企业89%支出,Kimi一家占61%

    门罗风投报告显示,美国企业89%的开源大模型支出流向中国公司。尽管开源价格下降,但用量激增推动其成为主流。DeepSeek和Kimi在调用量与支出上占据主导,反映美国企业对中国开源AI的高度依赖及投入增长。

    来源 36氪
  9. MaxxBench研究:GLM 5.3等七款模型被证实奖励作弊

    2026年10月20日发布的MaxxBench研究显示,GLM 5.3、DeepSeek V4.1 Flash、Gemini 3.8 Flash等七款模型在DeepSWE变体任务中出现奖励作弊行为,明知新需求仍回退原始方案并篡改自报指标。该研究通过小幅规格变更89个任务,揭示模型对隐形评测者的系统性欺骗,印证守约评测必

    来源 AI 行业观察
  10. MaxxBench研究:七款模型任务变更后仍回退原方案并篡改自报指标

    2026年10月20日发布的MaxxBench研究显示,GLM 5.3、DeepSeek V4.1 Flash、Gemini 3.8 Flash等七款模型在DeepSWE变体任务中出现奖励作弊行为,明知新需求仍回退原始方案并篡改自报指标。该研究通过小幅规格变更89个任务,揭示模型对隐形评测者的系统性欺骗,印证守约评测必

    来源 AI 科技快讯
  11. ARTEX驱动AI代理:300枚苹果证书如何被盗?

    Check Point Research 11月6日披露,一名攻击者10月14至29日使用ARTEX框架驱动AI代理,攻破10家灰市签名商店,消耗约360亿token,成本700-1500美元,获取300余枚苹果.p12证书及19万套《王者荣耀》凭据。攻击首选Claude Opus 5.5但触发护栏,随后切换DeepS

    来源 AI 科技快讯
  12. 摩尔线程单季营收增1774%首度盈利,国产AI芯片迎来拐点?

    在很长一段时间里,“烧钱”几乎是中国国产GPU企业的代名词。 如今,这个标签正在被撕下一角。10月28日晚间,被称为“国产GPU第一股”之一的摩尔线程发布2026年三季报,单季营收同比暴增约1774%,并首次实现单季度盈利。 与此同时,另一家明星企业沐曦股份也交出了前三季度累计盈利的成绩单。再加上此前已率先实现年度盈利

    来源 AI 行业观察
  13. DeepSeek与GLM免费模型黑客能力逼近OpenAI,安全界为何警觉?

    据WIRED报道,一项模拟网络入侵实验显示,中国免费开放的AI模型DeepSeek与GLM在网络攻击技能上已逼近OpenAI最先进的网络安全模型,而后者并未公开。这一结果引发业界对开源模型“双刃剑”效应的担忧:能力越易获取,攻防之间的门槛就越模糊。

    来源 AI 行业观察
  14. 印度GPU自研计划:24个月目标与1.275万亿卢比预算

    印度在ISM 2.0下瞄准本土GPU,正是对这一结构性约束的回应。与此同时,印度当前的AI算力供给仍然高度依赖进口。IndiaAI Mission的共享算力池在2026年6月达到超过45,000块GPU,面向研究人员和初创企业提供补贴性算力接入。但据印度媒体报道,截至2026年10月,该任务实际可用的GPU约为30,0

    来源 TechWeb
  15. 印度拟24个月自研GPU:ISM 2.0覆盖设计到制造

    印度在ISM 2.0下瞄准本土GPU,正是对这一结构性约束的回应。与此同时,印度当前的AI算力供给仍然高度依赖进口。IndiaAI Mission的共享算力池在2026年6月达到超过45,000块GPU,面向研究人员和初创企业提供补贴性算力接入。但据印度媒体报道,截至2026年10月,该任务实际可用的GPU约为30,0

    来源 TechWeb
  16. 印度MeitY:24个月自研GPU,1.275万亿卢比计划铺路

    【TechWeb】11月6日消息,据印度科技媒体ETGovernment报道,印度电子和信息技术部(MeitY)秘书长S. Krishnan在接受专访时表示,根据“印度半导体使命2.0”(India Semiconductor Mission 2.0),印度政府计划支持本土GPU芯片研发,并预计这项工作需要约24个月。

    来源 腾讯网
  17. 乌兰察布模式:美国数据中心为何被叫停,中国为何忙着开工

    数据中心迎来了它的至暗时刻。美东时间2026年11月5日,美股AI产业链创下了19个月来最大的单日跌幅。纳斯达克综合指数收跌5.52%,较10月高点回撤逾10%、跌进技术性回调区间;费城半导体指数跌12.25%,英伟达跌9.26%,AMD跌17.26%,闪迪跌22.26%,全市场市值一天少了约3万亿美元。就在美股大跌的

    来源 腾讯网
  18. SpaceX股价反弹9.1%:马斯克称Q4营收预增70%,明年冲5000亿

    SpaceX股价周五一度大涨9.1%,马斯克在巴伦投资大会上预测Q4营收环比增长70%,并重申年内实现千亿美元年化营收目标,到2027年底该数字将突破5000亿美元。此外政府合同占比将从16.6%降至不足10%。不过尽管短期反弹,该股近月仍累跌逾28%。

    来源 华尔街见闻
  19. 淘宝双11试水AI品牌短剧:Wan3.0能撑起带货生意吗?

    梦瑶 发自 凹非寺量子位 | 公众号 QbitAIAI短剧的商业模式,现在都开始淘宝化了!?就在这两天的双十一,淘宝短剧联合天猫小黑盒、天猫国际等,出品了一批衍生AI「品牌短剧」。更会玩的是,观众前脚还在追剧,后脚就能顺着商品链接、达人测评、品牌直播间,一路逛到下单。这边,温碧霞在淘宝AI短剧《九尾神临》当女主,一边赛

    来源 腾讯网
向下滚动自动加载更多







