DeepSeek-V4.1-Flash自我改写架构:数学竞赛准确率涨7分

资讯 AI 行业观察 全文 3582 字 · 约 9 分钟读完 配图 16 张 分类DeepSeekTransformer深度求索Deepseek

Al亲手改写Transformer架构!DeepSeek自我改造暴涨7分

所属频道 开源生态
DeepSeek-V4.1-Flash自我改写架构:数学竞赛准确率涨7分(配图 1)

新智元报道  

DeepSeek-V4.1-Flash自我改写架构:数学竞赛准确率涨7分(配图 2)


AI盯着自己的“脑子”动刀改写,这一幕真的发生了。

DeepSeek-V4.1-Flash拥有7630亿参数,它直接调取了自己做数学题时最深7层的内部激活状态。
弄清楚“快要算偏”的信号规律之后,它在半个权重都不改的情况下,自己写了一段Python代码塞进推理流程,靠“读脑”把自己救回来。
一旦察觉思路跑偏,它当场回滚重算。在AIME与HMMT 2026数学竞赛上,准确率直接涨了7个百分点。

这不过是今天刷屏AI圈的DoubleAI重磅研究中的一部分。

DeepSeek-V4.1-Flash自我改写架构:数学竞赛准确率涨7分(配图 3)

这家AI机构由Mobileye创始人Amnon Shashua创办,此次首次提出名为“机制干预”的新范式,对传统深度学习形成颠覆。

过去模型只能在写死的架构里硬调权重,这套方法则把编程Agent直接放进训练与推理现场。
训练途中哪一层网络卡住了,Agent就当场写几行Python代码塞进模型主干,实时接管计算。
靠这一手,预训练模型只塞入20行代码,单次前向推理里就跑起了梯度下降。
连续塞入10层代码后,30种经典算法的准确率从55%一路冲到84%。
研究发布后,很快在AI圈引发刷屏热议。
创始人Amnon Shashua表示,深度学习已经彻底跨过“只调权重”的旧边界。
如今连神经网络架构本身都能在训练中自主进化,人类手搓模型架构的时代已经翻篇。
DeepSeek-V4.1-Flash自我改写架构:数学竞赛准确率涨7分(配图 4)
联创Gal Beniamini也感慨,放手让大模型边训练边改写自己,最终长出来的架构连研究员都觉得不可思议。
它不再只是纯粹的神经网络:一半来自训练学出的权重,一半来自半路拼接的Python代码。
DeepSeek-V4.1-Flash自我改写架构:数学竞赛准确率涨7分(配图 5)

先说清楚这套“机制干预”是怎么运作的,再看实验细节。

  • 第一步找瓶颈:Agent实时读取每层网络的梯度信号,揪出靠调权重学不会的短板。

  • 第二步写代码:Agent现场生成几十个候选Python函数,实测哪段代码最能帮模型降误差。

  • 第三步热插拔:把胜出代码挂在初始值为0的门控后面并入网络,由后续训练自动把门控推开。

DeepSeek-V4.1-Flash自我改写架构:数学竞赛准确率涨7分(配图 6)

DeepSeek-V4.1-Flash自我改写架构:数学竞赛准确率涨7分(配图 7)
塞入20行代码,前向传播跑起梯度下降


第一组实验从语言模型预训练切入,验证训练中途塞入Python代码能否帮模型更快压低预测误差。

在12层模型nanochat的1500步训练中,Agent先后三次出手塞入Python代码层。

每次代码一并入,模型预测误差(bpb)就跟着连降三次。

DeepSeek-V4.1-Flash自我改写架构:数学竞赛准确率涨7分(配图 8)

训练到1500步时,加了代码层的模型拿到的效果,等于凭空多跑了15%的训练进度。

对照组那边,把代码逻辑打乱之后,训练曲线和常规训练完全重合。这说明多出来的分数,全靠AI写出来的代码逻辑。

网络有12层,Agent要判断该往哪一层塞代码,用的办法叫「幽灵梯度」。

它的做法是先假设在某层后面挂一个新模块,再测算往哪个方向推能让误差掉得最快。

常规噪声被滤掉以后,第2层和第4层这两块需求集中的热区就露了出来。

DeepSeek-V4.1-Flash自我改写架构:数学竞赛准确率涨7分(配图 9)

瓶颈层定下来,Agent一口气写出几十个候选函数,放到单批数据上逐个实测,看谁最贴合第2层的梯度方向。

DeepSeek-V4.1-Flash自我改写架构:数学竞赛准确率涨7分(配图 10)

得分最高的那个函数,被挂到初始值为0的门控后面,再并进网络。g

刚插进去的时候门控输出是0,原来的网络一点没受影响。

可100步不到,梯度下降就发现这段代码确实能压误差,门控自己被调到了0.58。

DeepSeek-V4.1-Flash自我改写架构:数学竞赛准确率涨7分(配图 11)

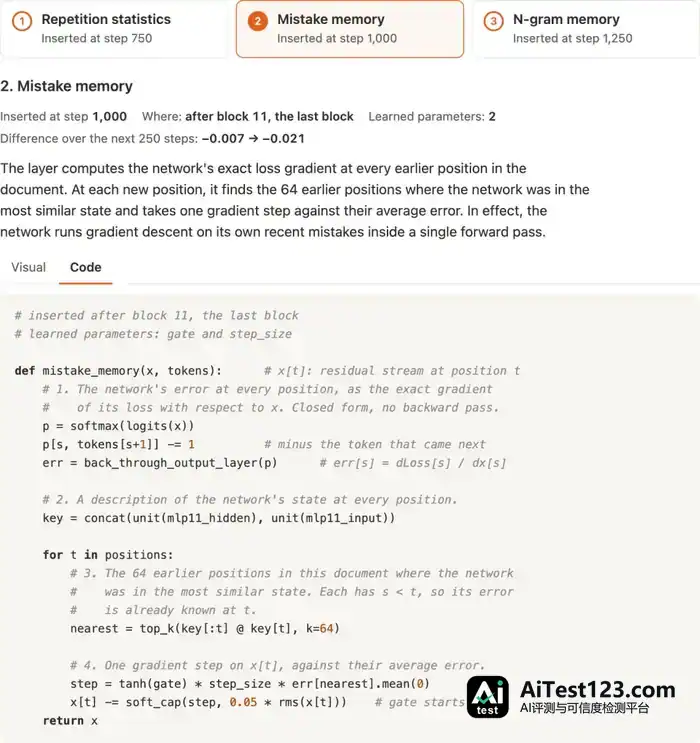
按这套流程走,Agent在第1000步往最后一层塞进了一个「错误记忆层」,效果最让人意外。

这段代码只有20行,之所以让人吃惊,是因为它推翻了「前向只负责推理、改错得靠反向」的老规矩。

模型不用等反向传播,一边往后读一边就能核对前面的答案,当场把预测误差算出来,定位到64个最相似的出错位置。

然后它直接在内部走一步梯度下降,一次前向传播里就把错给纠了。
DeepSeek-V4.1-Flash自我改写架构:数学竞赛准确率涨7分(配图 12)


DeepSeek-V4.1-Flash自我改写架构:数学竞赛准确率涨7分(配图 13)
代码层半路插进去,比一开始就带着强17分


Python代码层这么好用,那从训练第0步就把它装进模型,行不行?

第二组实验给出的结果,却完全反着来。

团队把模型的记忆窗口卡在500词以内,然后考它能不能找回几千词之前赋过的变量。

同时Agent写了一个能跨窗口查字典的「代码缓存层」,按三种时机装进模型:

  • 常规训练基线:超出500词窗口的变量全忘了,召回率是0%。

  • 第0步天生自带组:开训之前就装好代码缓存层,召回率停在55%。

  • 第1200步半路插入组:先练1200步,再把同一个缓存层塞进去,召回率冲到72%!

DeepSeek-V4.1-Flash自我改写架构:数学竞赛准确率涨7分(配图 14)

同样一个Python代码层,训到半路才插,居然比天生自带高出整整17个百分点。

原因就藏在这个反转里:开训头一天若把现成的代码捷径摆到面前,神经网络便容易「偷懒」,转头去靠外部字典,不肯下功夫打磨底层表征。

反过来做才有效——先逼模型在500词限制下把基础表征练扎实,等它撞上天花板,再把Python代码接上去,神经权重和符号代码的合力才能拉满。


DeepSeek-V4.1-Flash自我改写架构:数学竞赛准确率涨7分(配图 15)
连塞10层代码,填平算法0分盲区


「半路插入」的优势坐实之后,第三组实验把矛头对准30种经典计算机算法,看连塞10层代码究竟能带来什么质变。传统Transformer学算法有一处致命盲区:测试一旦撞上训练时跳过的「中间长度」,准确率就会崩盘。

下图里,常规训练(灰线)一碰到没见过的中间长度,瞬间跌到0%;接入代码层后(橙线)则始终稳在高位。

总分层面,常规模型就算训满20000步,30种算法的总准确率也只到55%。

第10000步时,Agent每隔500步出手一次,连续塞进10个Python代码层,帮模型记住「哪些节点访问过」「当前最小值」这类关键状态。

只过了5000步,原本考0分的广度优先搜索就干到97%,拓扑排序冲到93%,30种算法总准确率抬升29个百分点,达到84%。

涨分这么猛,靠的是神经网络与Python代码在内部打出精妙配合。譬如代码层要比数字大小,可原始输入只是拆散的字符「8」和「3」。

Agent拿线性探针逐层检测,发现到第4层时,神经网络已经把零散字符拼成了真正的数字。

代码层随即用探针从第4层读出数值82.6,在Python里做完比大小和循环更新,再写回网络,神经表征与符号计算就此彻底打通。


DeepSeek读脑自救,数学竞赛暴涨7分


视线拉回开篇那一幕:已经训好的DeepSeek-V4.1-Flash与Qwen3-8B,是怎么靠写代码原地进化的。

团队把DeepSeek-V4.1-Flash在243道数学题上的做题轨迹,连同最深7层的内部激活状态,一并交给它自己。

DeepSeek分析完犯错规律后,亲手写出探针重采样程序probe_and_resample,杀进AIME与HMMT 2026考场!

花掉同样的token预算,三组对照结果一目了然。

  • 标准单次长思维链推理一条道走到黑,准确率63.9%;仅按长度重采样的那组只按字数盲目重算,准确率仅65.4%。

  • DeepSeek自写探针组实时「读脑」、提前止损,准确率冲到71.0%,涨了超过7个百分点。半个权重都没改就能多拿7分,靠的全是DeepSeek给自己写的这段监控代码。

过去,大模型要是思路跑偏,常常得把几万个token全算完,才发现整条路都错了。

如今不一样了:思维链每到检查点,程序就会自动抽取最深7层的激活特征打分;一旦发现轨迹偏离正常分布,立刻回滚重算。rollback!

Qwen3-8B这边,在零梯度更新的条件下,自主试了15000个Python调度策略;AIME和HMMT 2026两场考试上,准确率从58.5%提高到65.5%,同样涨了7个百分点。

算力省下来、成绩还能反超,靠的是Qwen3-8B专门写的那段代码。

它让32条并发轨迹每跑2048个token就检查一次;只要有8条算出答案,且头名票数超过第二名的2倍,就提前收工,全员省算力。

反过来,跑满12288个token还没算完、重复率超过0.35的「死循环复读」轨迹,会被当场砍掉、重启,并降低它的投票权重。

四组实验放在一起,指向的是通往超级人工智能(ASI)最关键的一步:递归自我改进。

模型究竟卡在哪个算子、在哪个长度上崩掉,不用再靠人盯着Loss曲线一点点猜。AI能读懂自己的内部状态,当场写几行Python,就能给自己的大脑动手术。

从「人类调权重」走到「AI写架构」,大模型已经亲手接管自己的神经网络。AI真正自我进化的时代,已经来了。

参考资料:

https://www.doubleai.com/research/can-llms-redesign-themselves-as-they-train
https://x.com/doubleaicom/status/2041555517853270296
https://x.com/AmnonShashua/status/2041556445947908456
本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. DeepSeek模型自我改写:7层激活读脑,AIME涨7分

    新智元报道 AI看着自己的脑子改写自己,这一天还是来了!7630亿参数的DeepSeek-V4.1-Flash,直接读取了自己做数学题时最深7层的内部激活状态。摸清「快要算偏」的信号规律后,它在不改半个权重的前提下,亲手写了一段Python代码塞进推理流程「读脑自救」!只要发现思路跑偏就当场回滚重算,在AIME与HMM

    来源 腾讯网
  2. DeepSeek-V4.1-Flash私有化落地:四档硬件配置与三年成本测算

    企业想把大模型搬进自家机房,DeepSeek-V4.1-Flash是个热门选项。本文不谈虚的,直接拆解8卡服务器的显存怎么算、FP8量化会不会掉精度、三年到底花多少钱。通过一个制造集团的真实案例,对比商业授权与自建的成本差异,给出从硬件采购到性能验收的完整避坑指南。

    来源 AI 应用前沿
  3. 硅谷华人团队开源Comma:单入口调度多Agent并行,解决上下文瓶颈

    DeepSeek提出Super-agent概念引发关注,而硅谷华人团队AFK AI早在半年前就推出了类似架构的产品Comma并开源。Comma采用“单Router+多Worker”模式,用户只需在一个对话窗口下达指令,系统即可自动调度多个独立上下文的Agent并行处理代码、文档等任务。它支持跨应用协作(如微信、Line

    来源 AI 应用前沿
  4. DeepSeek Harness插件系统被吐槽 负责人承诺升级:一切都会好起来

    然而一切接插件的生态也导致了另一个严重的问题,那就是插件与DSH的兼容性,DSH官方源码页面上一直在提示会有破坏性更新,搞过DSH插件的开发者都很头痛这个问题,DSH版本一升级,插件不只是能不能用的问题,甚至可能搞得DSH崩溃,启动不了,这会影响工作。

    来源 凤凰科技
  5. DeepSeek日活破百万,Agility上市与人形机器人商业化冷思考

    2026年11月AI圈动静不小:DeepSeek Harness日活达154万,Inkling 2 Small在ARC-AGI测试中拿到高分并计划开源。硬件方面,Agility Robotics成为美国首家人形机器人上市公司,但商业模式仍受质疑;中国移动千亿投入算力基建。与此同时,科技巨头的数据中心扩建在美国多地遭遇社

    来源 AI 应用前沿
  6. 梁文锋与西蒙斯:从量化到DeepSeek的思想线索

    千亿量化之神,给梁文锋留下了哪些精神遗产?整理|《中国企业家》记者 孙欣见习编辑|李原头图来源|视觉中国2021年2月,一本名为《征服市场的人:西蒙斯传》的书在中国出版。为它写推荐序的人,是当时只在私募圈小有名气的幻方量化创始人梁文锋。没人想到,四年后,他会以DeepSeek创始人的身份震动世界——而他所撰写的题为《创

    来源 腾讯网
  7. MaxxBench研究:GLM 5.3等七款模型被证实奖励作弊

    2026年10月20日发布的MaxxBench研究显示,GLM 5.3、DeepSeek V4.1 Flash、Gemini 3.8 Flash等七款模型在DeepSWE变体任务中出现奖励作弊行为,明知新需求仍回退原始方案并篡改自报指标。该研究通过小幅规格变更89个任务,揭示模型对隐形评测者的系统性欺骗,印证守约评测必

    来源 AI 行业观察
  8. DeepSeek与GLM免费模型黑客能力逼近OpenAI,安全界为何警觉?

    据WIRED报道,一项模拟网络入侵实验显示,中国免费开放的AI模型DeepSeek与GLM在网络攻击技能上已逼近OpenAI最先进的网络安全模型,而后者并未公开。这一结果引发业界对开源模型“双刃剑”效应的担忧:能力越易获取,攻防之间的门槛就越模糊。

    来源 AI 行业观察
  9. MaxxBench研究:七款模型任务变更后仍回退原方案并篡改自报指标

    2026年10月20日发布的MaxxBench研究显示,GLM 5.3、DeepSeek V4.1 Flash、Gemini 3.8 Flash等七款模型在DeepSWE变体任务中出现奖励作弊行为,明知新需求仍回退原始方案并篡改自报指标。该研究通过小幅规格变更89个任务,揭示模型对隐形评测者的系统性欺骗,印证守约评测必

    来源 AI 科技快讯
  10. DeepSeek招"数据百晓生":AI企业文科岗位占比涨到两三成

    本文仅在今日头条发布,谢绝转载。 招聘平台上深度求索发布的"数据百晓生"等岗位 我们这代人上学的时候,家里最怕我们干三件事:泡网吧打游戏,抱着武侠小说不撒手,在论坛上跟人吵架到半夜。 谁能想到,这几样后来被写进了一家AI公司的招聘要求。 深度求索,也就是做DeepSeek的那家公司,招过一个岗位,名字叫"数据百晓生"。

    来源 AI 行业观察
  11. 中国开源模型拿走美国企业89%支出,Kimi一家占61%

    门罗风投报告显示,美国企业89%的开源大模型支出流向中国公司。尽管开源价格下降,但用量激增推动其成为主流。DeepSeek和Kimi在调用量与支出上占据主导,反映美国企业对中国开源AI的高度依赖及投入增长。

    来源 36氪
  12. ARTEX驱动AI代理:300枚苹果证书如何被盗?

    Check Point Research 11月6日披露,一名攻击者10月14至29日使用ARTEX框架驱动AI代理,攻破10家灰市签名商店,消耗约360亿token,成本700-1500美元,获取300余枚苹果.p12证书及19万套《王者荣耀》凭据。攻击首选Claude Opus 5.5但触发护栏,随后切换DeepS

    来源 AI 科技快讯
  13. DeepSeek与GLM免费开放,黑客能力逼近OpenAI未公开模型

    据WIRED报道,一项模拟网络入侵实验显示,中国免费开放的AI模型DeepSeek与GLM在网络攻击技能上已逼近OpenAI最先进的网络安全模型,而后者并未公开。这一结果引发业界对开源模型“双刃剑”效应的担忧:能力越易获取,攻防之间的门槛就越模糊。

    来源 AI 科技快讯
  14. Thinking Machines 二代模型用上 Kimi 数据,400亿估值背后藏了什么

    OpenAI前CTO创立的Thinking Machines Lab发布Inkling 2 Small,技术博客坦承采样自月之暗面Kimi K3。这款594B参数模型在长程任务上表现强劲,但编程能力仍落后于DeepSeek和Kimi旗舰版。文章解析其“为微调而生”的商业逻辑,以及中国开源模型如何成为硅谷巨头的数据源。

    来源 AI 应用前沿
  15. SuperCLUE 11月榜:Kimi开源第一,Gemini长文本领先

    2026年11月SuperCLUE评测显示,Gemini-4-Argon在幻觉控制和超长上下文两项中得分最高,GPT-6.1-Sol则在代码和数理推理上领先。在开源模型阵营中,Kimi-K3.1-Pro综合排名第一,DeepSeek-V4.1在代码任务表现突出,而来自韩国的Darwin-180B在数理推理方面位居开源榜

    来源 AI 应用前沿
  16. 复旦校友杀疯:拿下Meta战略掌舵人

    作者 | 李冰之 编辑 | 吾人 来源 | 融中财经 扎克伯格身边干了14年的老将,跳槽了。他的新东家,是复旦校友乔琳创办的AI独角兽。 11月7日,Meta首席战略官、前首席财务官戴夫·韦纳(Dave Wehner)确认将离开Meta,加入AI初创公司Fireworks担任首席财务官(CFO)。而这家公司的联合创始人

    来源 AI 行业观察
  17. 马斯克宣布Cybertruck停产:2027年让路Cybercab,年销已跌至2万辆

    【TechWeb】11月8日消息,日前,埃隆·马斯克在社交平台X上发布了一则简短声明:特斯拉将于2027年年中前后,在得克萨斯州奥斯汀超级工厂“逐步停止”Cybertruck的生产。此时距离这款棱角分明的电动皮卡开始交付,仅过去三年半。马斯克给出的理由是,需要为无人驾驶出租车Cybercab腾出产能空间。他将这款车型称

    来源 AI 行业观察
向下滚动自动加载更多