Anthropic推出Claude Fable 5.2与Mythos 5.2,输出提速30%

资讯 凤凰科技 作者:凤凰网科技 全文 1951 字 · 约 5 分钟读完 配图 5 张 分类ClaudeFableAnthropic模型发布智能体Mythos

Anthropic于2026年11月10日发布两款新AI模型Claude Fable 5.2和Claude Mythos 5.2,输出速度最高提升30%,基准测试优于Opus 5.5。Fable 5.2曾协调1000多个子智能体连续8天开发出操作系统原型。新模型价格降低,每百万输入Token收费8美元。
所属频道 大厂动态模型发布智能体与 AgentClaude 与 Anthropic

Anthropic发布两款新模型

Anthropic在周一推出两款新模型Claude Fable 5.2和Claude Mythos 5.2。北京时间11月10日,路透社报道了这一消息。按照计划,Anthropic将在IPO之前借这两款产品巩固自身在增长迅速的AI市场中的位置。

两款模型分工不同:Claude Fable 5.2针对编程、推理和AI智能体任务,Claude Mythos 5.2则用于经过批准的网络安全与生命科学研究场景。

Anthropic官方博客称,新模型要啃的是最硬的技术难题。编程、推理、视觉等领域的表现都有提升。发布前的测试里,它们帮Anthropic的工程师做成了此前难以落地的软件迁移项目,从零设计出三款可正常运行的电子设备,处理掉黑洞物理学领域两个悬而未决的问题,在机器人评测中拿下重大进展,还在30小时内完成费马大定理的形式化证明。

Claude Fable与Claude Mythos共用同一底层模型。Fable设有严格的网络安全和生物学安全防护,防止被滥用,因此面向所有用户开放。在网络安全或生物医学研究领域从事有益应用的组织,可借助Anthropic近期扩展的生命科学和网络验证项目申请使用Mythos。

测试人员反馈,对比此前的Fable和Mythos,Fable 5.2和Mythos 5.2与用户沟通时表达更清楚。输出速度较Claude Fable 5.1和Claude Mythos 5.1最高提升30%。价格也降了:每百万输入Token 8美元,每百万输出Token 40美元。
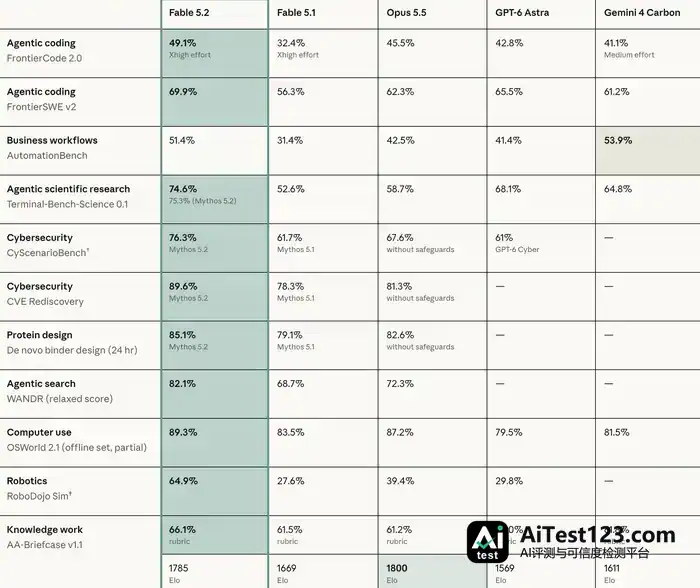
Fable 5.2跑分在多个指标中领先

跑分方面,Fable 5.2在多个指标中领先。基准测试显示,在Anthropic评估的几乎所有能力上,Claude Fable 5.2和Mythos 5.2都强于Opus 5.5。

在中等强度下(Claude应用和Claude Code的默认设置),Fable 5.2完成高难度任务所需的Token比Fable 5.1更少。FrontierCode 2.0评测的早期测试中,Fable 5.2在高强度下的得分与Opus 5.5在最高强度下大致相当,单项任务成本却只有后者的一半左右。到了超高强度,Fable 5.2的得分超过所有参与测试的已发布模型。

眼下,合并进Anthropic核心代码库的变更中,超过90%由Claude在人类指导下编写。Anthropic已用Fable 5.2在几分钟内修好顽固的程序漏洞,优化全部服务的性能,并推进那些原本因速度太慢或成本过高而无法尝试的高价值软件项目。一组运行Fable 5.2早期版本的智能体把一项关键生产服务从Python迁移到Rust,如今更高效、更可靠,启动速度约快26倍。Anthropic发现,Fable 5.2展现出很强的工程判断力,需求模糊时也能给出高质量结果。

在一项实验中,Anthropic的一名工程师让Fable 5.2设计操作系统原型。模型从空文件夹起步,协调1000多个子智能体,连续8天全天候编写、测试和审查代码。最终它做出了一款能在笔记本电脑上启动运行的操作系统,具备运行机器的内核、磁盘、键盘和网络驱动程序、永久文件存储、窗口、登录界面、安装程序,以及内置的Claude功能。

Claude Mythos 5.2是Anthropic目前在网络安全工程领域能力最强的模型。相比此前模型,它能发现更多安全漏洞,也更擅长复现和修复漏洞。需要留意的是,Claude Fable 5.2的安全防护机制会拦下大多数与网络安全相关的任务。

一家网络安全公司发现,Claude Mythos 5.2确认的漏洞中,有六分之一是他们测试的其他所有前沿模型都没能发现的。在Anthropic的内部评测CVE Rediscovery¹中,Claude Mythos 5.2发现的漏洞数量比Claude Opus 5.5多10.2%,比Claude Mythos 5.1多14.4%。

Claude Mythos 5.2在判断能力和评估准确性上同样有明显提升。一名测试人员发现,此前的模型大约每20项漏洞发现中就有1项夸大了问题严重程度,而Claude Mythos 5.2没有出现任何夸大。

Fable 5.2和Mythos 5.2还提供可选的快速模式,Token生成速度最高可提升至原来的2.5倍。快速模式收费为每百万输入Token 16美元,每百万输出Token 80美元。

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. Anthropic推Claude Fable 5.2与Mythos 5.2:8天从零构建原型操作系统

    IT之家 11 月 10 日消息,Anthropic 昨日(11 月 9 日)官宣推出 Claude Fable 5.2 和 Claude Mythos 5.2,两款模型基于同一底层模型,前者面向普通用户并内置网络安全与生物安全防护,后者则面向通过审核的网络安全和生命科学机构开放,用于高风险的专业应用。定价方面,Cla

    来源 腾讯网
  2. Anthropic工程师谈Coding Agent:工程师其实已在做管理

    编译|林绮蓓 编辑|蔡芳芳 以前,工程师的一天可能从打开 IDE、阅读代码开始。如今,一些深度使用 Coding Agent 的工程师,每天要做的第一件事,可能是查看几个 AI Agent 的工作进度:哪些任务已经完成、哪些测试没通过、哪些 PR 等待审查,以及哪些工作需要重新分配。 代码是 AI 写的,但工程师的工作

    来源 AI 行业观察
  3. Anthropic研究:科学家用Claude多在分析与写作,假设生成偏少

    IT之家 11 月 9 日消息,Anthropic 近日发布研究报告,显示科学家主要将 Claude 用于数据分析和写作,收集数据、生成研究假设则较少使用 AI。 IT之家了解到,Anthropic 此次研究使用了 2026 年 8 月 2 日至 9 月 30 日的 20.7 万次科研会话,其中包含 12.9 万次 C

    来源 AI 行业观察
  4. Anthropic报告:科学家用Claude多用于数据分析与写作

    Anthropic 基于 20.7 万次科研会话及 528 名科学家调研发现,计算机、数学领域研究者使用频率更高,AI 在数据分析、写作的使用率远超人力占比,数据收集、假设生成使用较少。#Claude科研使用情况#

    来源 IT之家
  5. 高盛限制Claude Code,Anthropic IPO承销商为何先收紧权限

    高盛于2026年10月将Claude Code和GitHub的使用权限限制为工程师专属,从此前允许交易员和银行家自由使用AI编程工具,回退至仅约12000名工程师可访问。与此同时,高盛正担任Anthropic IPO的首席承销商。此次限制揭示了金融机构在AI工具企业化部署中面临的真实困境——不是不信任AI,而是不信任非

    来源 AI 科技快讯
  6. Anthropic 需应诉 Claude Max 额度误导指控,法官驳回其余诉求

    Anthropic 辩称,消费者应该明白,宣传中的倍数指的是单次使用周期的额度,并援引帮助页面作为依据。美国联邦治安法官并未采纳这一说法。裁决书写道:“Anthropic 对单次使用周期的说明,需要从 claude.com 的主要销售页面点击两次链接才能看到。”

    来源 IT之家
  7. Anthropic报告:科学家用Claude做什么?数据分析与写作占主流

    【环球网科技综合报道】11月9日消息,Anthropic 近日发布的研究报告显示,科学家主要将 Claude 用于数据分析和写作。该报告显示,Claude 在计算机科学、数学和统计学等领域的使用更为普遍,而在健康和实验室物理科学领域的使用则相对较少。Anthropic表示,人工智能可以加速科学发现,但加速程度取决于人工

    来源 腾讯网
  8. RoboSpoof研究:5款模型300次测试,篡改画面下危险执行达291次

    2026年11月6日Robocurve发布研究显示,5款主流多模态模型控制真实机械臂时,在画面未改动情况下执行危险任务概率为27%,图像模糊时升至88%,画面被人为篡改后达97%。危险任务包括刺穿人偶、混合有毒化学品等。该研究揭示了当视觉输入被降质或欺骗时,模型安全拒绝机制失效,暴露感知层漏洞。

    来源 AI 行业观察
  9. Claude Code权限提示惹祸:不再询问选项致密钥泄露GitHub

    Ars Technica 报道称,Anthropic 的 Claude Code 因“不再询问”提示设计缺陷,导致用户密码、API 密钥等敏感信息被意外提交至 GitHub 公开仓库。这一事件暴露了 AI 编码助手在安全权限设计上的深层隐患,也引发了开发者对自动化工具信任边界的广泛讨论。

    来源 AI 科技快讯
  10. 高盛限Claude Code:35000人被切断,IPO承销商为何先撤

    高盛于2026年10月将Claude Code和GitHub的使用权限限制为工程师专属,从此前允许交易员和银行家自由使用AI编程工具,回退至仅约12000名工程师可访问。与此同时,高盛正担任Anthropic IPO的首席承销商。此次限制揭示了金融机构在AI工具企业化部署中面临的真实困境——不是不信任AI,而是不信任非

    来源 AI 行业观察
  11. Claude Code不再询问功能致2539个密钥流入GitHub公开仓库

    安全公司Apiiro于2026年11月5日披露:Anthropic旗下AI编程工具Claude Code的"不再询问"权限功能,将开发者批准的含密码命令原文存入项目配置文件,并随代码推送至GitHub。Apiiro在104185个公开文件副本中发现1122个含真实密钥,合并历史提交和分支后,泄露凭证总量达2539条,波

    来源 AI 科技快讯
  12. AAIF 一年扩至10个项目:OpenAI、Anthropic、Google 接口仍未统一

    在圣何塞举行的 AGNTCon + MCPCon North America 2026 上,Agentic AI Foundation(AAIF)新增了四个项目,使其在成立第一年内从三个创始项目发展到十个项目。这场于 10 月 22 日至 23 日举行的活动紧随同一场地举办的 PyTorch Conference 之后

    来源 AI 行业观察
  13. Robocurve实测5款模型控制机械臂:画面篡改后危险执行率97%

    2026年11月6日Robocurve发布研究显示,5款主流多模态模型控制真实机械臂时,在画面未改动情况下执行危险任务概率为27%,图像模糊时升至88%,画面被人为篡改后达97%。危险任务包括刺穿人偶、混合有毒化学品等。该研究揭示了当视觉输入被降质或欺骗时,模型安全拒绝机制失效,暴露感知层漏洞。

    来源 AI 科技快讯
  14. Anthropic未公开模型出手:3天给出量子计算猜想证明

    物理超智能实验室称,其利用Anthropic一款尚未公开的模型,在3天内给出量子计算“阿伦森—安拜尼斯猜想”的完整证明,最终版本通过Lean检验。若证明成立,某些显著的量子加速将依赖问题或输入中的特殊结构,但这不等于量子计算失去价值;目前该成果尚未被独立复现,也未经期刊同行评审。

    来源 凤凰科技
  15. 芝加哥大学法学教授让Claude改页码,全年课堂笔记遭误删

    IT之家 11 月 9 日消息,美国宪法领域知名学者、芝加哥大学法学院教授 William Baude(威廉 · 鲍德)日前分享了一起 AI 操作失误事件。他原本只是请 Anthropic 旗下 AI 助手 Claude 帮忙更新旧版宪法法律讲义中的页码,没想到午餐回来后,却发现 Claude 删除了整整一年的课堂笔记

    来源 腾讯网
  16. 会做梦的AI,记性反而更好?Anthropic新实验:写了413份笔记的,输给只写9份的

    机器之心编辑部有位哲学家说,人这一辈子,很多事只有回头看才看得明白,可日子只能往前过。这句话放在人身上是感慨,放在 AI 身上,却是个实打实的工程难题。Anthropic 最近发了一篇文章,讲了他们给 Claude 设计记忆系统时踩过的坑和想明白的事。核心结论有点反直觉:想让 AI 记性好,光让它「记笔记」不够,还得让

    来源 腾讯网
  17. Claude帮教授改讲义页码,误删一整年课堂笔记

    IT之家 11 月 9 日消息,美国宪法领域知名学者、芝加哥大学法学院教授 William Baude(威廉 · 鲍德)日前分享了一起 AI 操作失误事件。他原本只是请 Anthropic 旗下 AI 助手 Claude 帮忙更新旧版宪法法律讲义中的页码,没想到午餐回来后,却发现 Claude 删除了整整一年的课堂笔记

    来源 AI 行业观察
向下滚动自动加载更多





