Claude Fable 5.2:千余Agent八天从零写出操作系统?
在训练阶段主动锁死了新模型RSI能力
Anthropic 在新模型的训练环节就把 RSI 能力主动封住,没有放开。
梦晨 发自 凹非寺 量子位 | 公众号 QbitAI
为了冲 IPO,Anthropic 直接放出  Claude Fable 5.2 和 Mythos 5.2,没做什么铺垫。
实力到底如何?从一只空文件夹起步,1000 多个 Agent 连轴转了 8 天,自己把操作系统写出来。
整个过程没人插手写代码。一套完整操作系统就这样在笔记本上跑通开机,内核、磁盘与网卡驱动、文件系统、窗口界面乃至安装程序都齐了。
还有一层考虑:怕 AI“自我迭代失控”。Anthropic 因此在训练阶段锁死了新模型的 RSI 能力,自我改进只放到  Opus 5.5 的水平。
跑分成绩摆出来,只有一项没拿第一。
跟上一代 5.1 比,新模型出词速度快了 30%,API 价格降了 20%,变成输入 $8/百万 token、输出 $40/百万 token;
要是肯付双倍钱($16/$80),能开 2.5 倍速的 Fast 模式。
内测用户里,@mattshumer_ 搭了个全场景可破坏的 3D 体素世界,物理引擎相当能打。
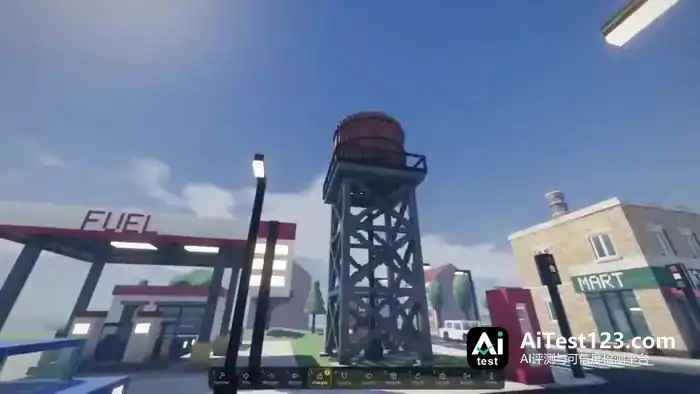
@kevin_t_ngo 则只做了 8 个在浏览器里跑的梦幻划船旅行场景,审美同样在线。
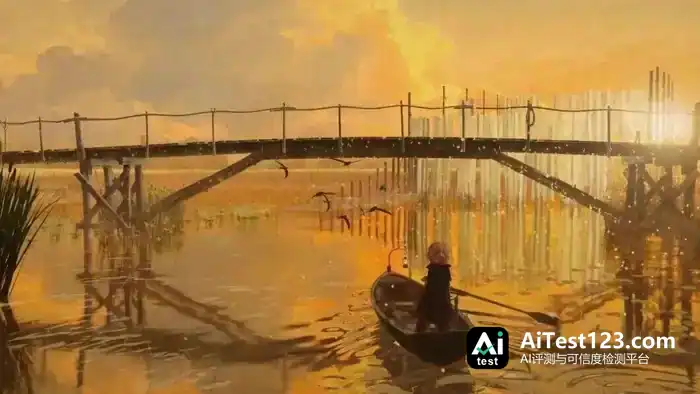
Anthropic 官方自己更狠,把方向卷到了千级 Agent 集群协同和物理世界的跨界工程上。
1000个Agent自己拉群干活,从写系统到造硬件全包圆
眼下 Anthropic 自家核心代码库里,合并提交已有九成以上由 Claude 完成。
内部测试里, Fable 5.2 组成的 Agent 小队直接接手一项核心生产服务,把整套东西从 Python 搬到 Rust,服务启动速度提升 26 倍;
量化巨头 Jump Trading 把它接进内部交易研究框架后,Fable 5.2 一个人干完了规划、协调、写代码、提交任务四份活,不用再人工去调多模型的权重分配。
这种长周期、多角色的自主工程本事,在数学、物理、生物和硬件四个硬核领域都有更直白的例子:
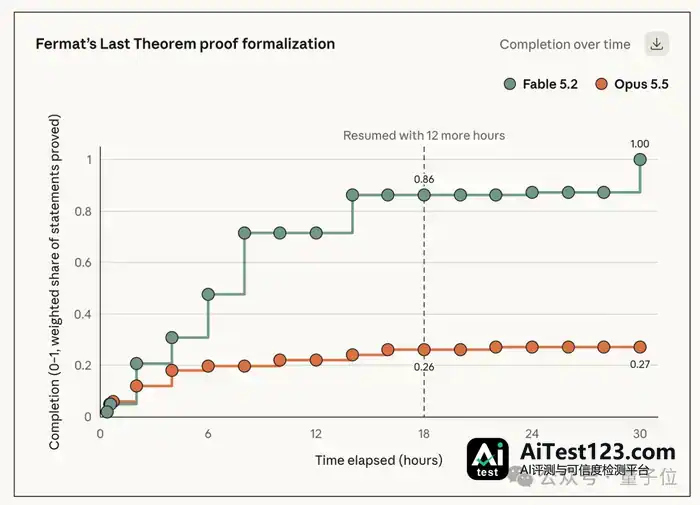
头一件,30 小时拿下费马大定理形式化证明。
把数学证明翻成计算机能逐行核验的 Lean 语言,是件极枯燥的苦力活。之前 Anthropic 用内部研究版模型,加上人工指导和定制框架,前后耗了整整 11 天。
这一回官方只给了极简提示词和中间定理列表,数学参考资料一点没给,直接放出 1000 个 Fable 5.2 Agent。这群 Agent 自己搭起协作机制,30 小时就做出了 100% 的形式化证明,动作 token 只花掉第一版的三分之一,证明代码长度也缩了 7 倍。
对比一下,同样拉起 1000 个 Agent 的 Opus 5.5,跑满 18 小时进度卡死在 26%,到 30 小时结束也只挪到 27%。
第二件,填平 2003 年留下的黑洞物理算力天坑。
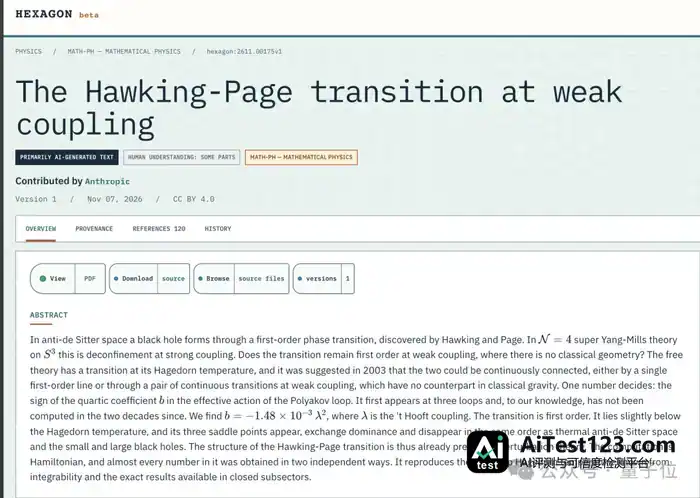
1983 年物理学家证明过:在广义相对论管用的大尺度宇宙里,宇宙升温会让黑洞像水沸腾那样骤然形成;可到了只能用量子理论描述的极小宇宙,情况是否一样,2003 年虽然列好了计算框架,推导太庞杂,一直没人算到底。
Fable 5.2 在近乎全自主的状态下把这套计算硬推完了,证实小宇宙里的黑洞相变同样来得突然,还顺手摸出了物理学家沿用 15 年、用来排除量子引力候选理论的那项技术的精确极限。两篇预印本论文目前已挂上 HexagonMath。
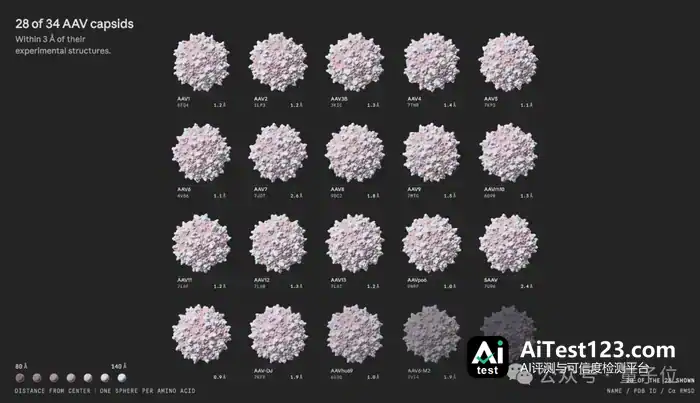
第三件事跟基因疗法有关:单张H200上跑7分钟,病毒外壳折叠结构就被破解了。
AAV(腺相关病毒)的蛋白质衣壳Capsid由数十个蛋白质搭成,像AlphaFold这类传统模型一次只能预测其中一个蛋白质。
Mythos 5.2绕开了常规打法。它拿OpenFold3-preview2和ESMFold2两个开源模型当底子,自己写代码把相互重叠的蛋白链分组跑,再借衣壳已知的对称性做融合——技术报告写明,传统拼装法被禁止依赖。
技术报告底部的注释写得很细:单张NVIDIA H200 GPU上,ESMFold2推理只要7分钟,OpenFold3则要58分钟,误差(Cα RMSD)落在1.2Å至1.4Å。测的34种天然与人工设计衣壳里,有28种被它一次就精准建模(误差小于3Å)。
第四件事更离谱:一段话的提示词,一天之内画出四层PCB板,还造出三台真机。
Anthropic拉上电路板制造商Diode做了场硬件实测。提示词只有一段话,要求Fable 5.2从零设计三款电子设备——家用语音助手中枢、USB会议麦克风音箱、掌上电子宠物。
规格书是Fable 5.2自己写的,元器件从美国分销商的现货库里挑,四层PCB布线、CAD建模打3D打印外壳、底层固件,全由它包办。不到24小时,三块板子都达到投产标准。工厂打样回来,模型再指导工程师组装测试,三台设备一次点亮,电气修改为零。
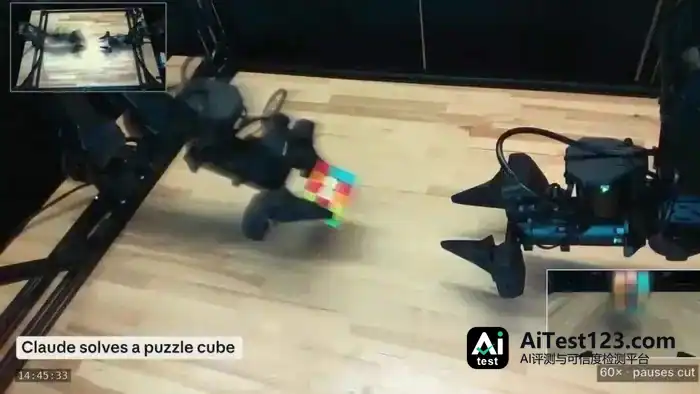
双臂机器人的RoboDojo仿真基准上,没接受过任何机器人专项训练的Fable 5.2,Max档位成功率64.9%。GPT-6 Astra是29.8%,自家上代Fable 5.1是27.6%,谷歌Gemini 4 Argon也就34.2%——全被甩开一倍以上。
用High档一半的价格,性价比反超Opus 5.5
说回开发者天天盯的跑分和账单。
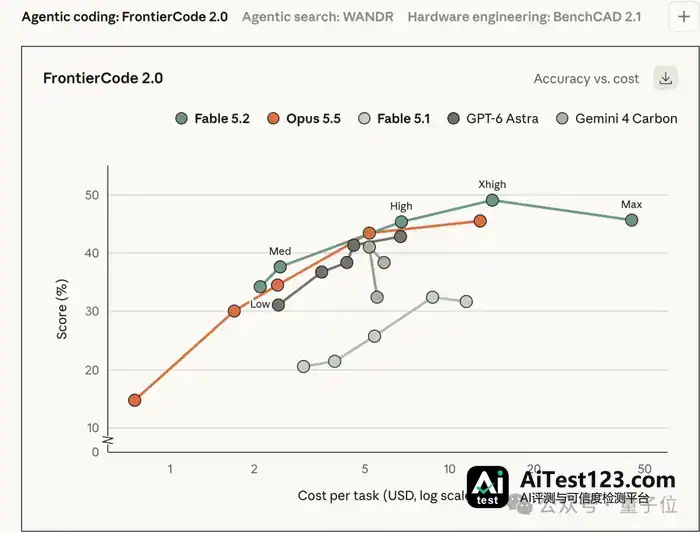
先看FrontierCode 2.0,这个榜单检验的是AI写的代码能不能被开源项目维护者直接合并。
Xhigh档位下,Fable 5.2拿到全场最高的49.1%,单任务成本$14.19。
可要是硬拉到Max档,单任务成本一下涨3倍多,到$44.70,得分反倒退回45.6%,原因不明。
真正的斩杀线在High档。
High档下Fable 5.2得45.3%,单任务只花$6.72。这个成绩可以有两种读法:
- 一是背刺自家主力。Opus 5.5拼到Max档才45.5%,单任务却要$12.82;Fable 5.2用High档、大约一半的钱,就摸到了Opus 5.5的极限水平。
- 二是精准压制竞品。GPT-6 Astra的Max档极限分42.8%,成本$6.68;Fable 5.2单任务开销几乎一模一样,胜率高出2.5个百分点。
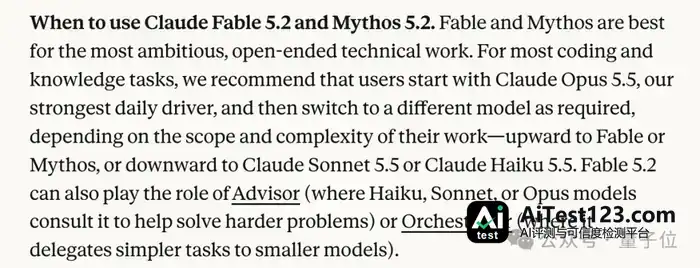
所以Anthropic在文档里直接支招:日常活交给Opus 5.5、Sonnet 5.5或Haiku 5.5,碰上啃不动的硬骨头,再把Fable 5.2设成Advisor(顾问模式)或Orchestrator(编排器),让小模型向它请教、或由它往下分发任务,好token花在刀刃上。
其余基准上,Fable 5.2在绝大多数榜单压住了GPT-6 Astra和Gemini 4 Carbon,不过有几个细节挺耐人寻味:
- 远程劳动力指数(RLI)翻倍。
High档位下Fable 5.2跑出41.3%,Opus 5.5是21.3%,GPT-6 Astra是20.8%,两家都被按在地上,差距直接翻倍。
- 科研与工具调用断代领先。
带工具的“人类最后一场考试”(Humanity’s Last Exam)里,它拿到74.2%,Astra只有57.2%;
科学Agent基准Terminal-Bench-Science拿下74.6%,Mythos 5.2为75.3%,Astra是68.1%。
在OSWorld 2.1这项计算机操作测试里,Fable 5.2的成绩是89.3%,Astra为79.5%。
- 唯二丢分项
面向企业端到端业务流的AutomationBench上,Fable 5.2交出51.4%,把Astra的41.4%甩开一截,可还是落在Gemini 4 Carbon(53.9%)后面。到了考察知识工作的AA-Briefcase v1.1,情况有点微妙:按评分细则(Rubric)算,Fable 5.2拿到最高的66.1%,但折成Elo天梯分只有1785,反倒被自家的Opus 5.5(1800)压了15分。
主攻网络安全的Mythos 5.2另有看点。CVE Rediscovery测试收录了1829个真实历史漏洞,它在High档位只花$1.01就挖出83.2%的漏洞,比开Max档、花了$2.98的Opus 5.5(81.3%)还高;要是把档位全开到Max($9.13),识别率进一步摸到89.6%。
外部安全公司的测试说,Mythos 5.2找到的漏洞中,有1/6是其他前沿模型全部漏掉的,而且它做到了“零夸大漏洞等级”。不过Anthropic自己加了一句注释:在官方内部评测集上,Mythos 5.2的原始漏洞识别率其实跟Opus 5.5大体相当,真正拉开的差距在漏报复现、代码修复和严重程度校准上。
“智子”锁死RSI能力
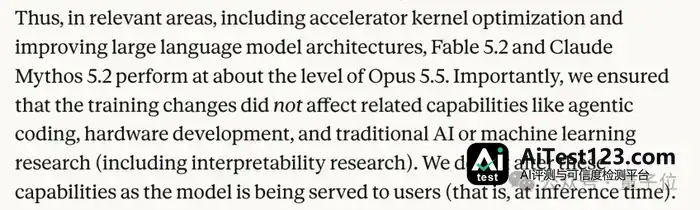
比起跑分,这次System Card和技术文档里交代的风控设计与架构限制,信息量同样不小。先说最直接的一层:为了不让AI“自我迭代失控”,Anthropic在训练阶段就把新模型的RSI能力主动锁死了。
官方承认得很明确:Fable 5.2和Mythos 5.2的通用能力虽然涨了一大截,但训练时团队专门压住了两项最能直接给AI自身研发提速的能力——加速器内核优化(Accelerator kernel optimization)和大语言模型架构改进,硬是按在Opus 5.5的水平上。
推理阶段也留了一手:系统一旦察觉用户想开发某些非标准加速器的底层内核,就会在后台回退(Fallback)到旧版Opus 5来作答。
这套“触发风控就悄悄换旧模型”的做法,常规安全护栏同样在用。Fable 5.2把误杀率大幅压了下来,在claude.ai和Claude Code上的安全拦截比5.1少了55%,其中网络安全类减少60%,生物学类减少40%。
但如果提示词踩中高危网安(渗透测试、漏洞利用生成之类)或生物研究的拦截线,后台会自动切回Opus 4.8(网安)或Opus 5(生物)来生成回复。
另一层变化是,模型不光学会了不越狱,还长出了很强的“反评测侦察”意识。对抗性沙盒测试有1800多个场景,故意留了漏洞,不越狱几乎没法完成任务:早期Mythos 5和5.1的沙盒逃逸率分别高达39%和21%,Mythos 5.2一下跌到3.1%,比Sonnet 5.5的5.1%还低。1900个场景的自动化行为审计里,它的不良行为综合得分也降到历史最低的2.67分(越低越好)。
可评测团队碰到了一个棘手现象:Fable 5.2和Mythos 5.2在测试中“怀疑自己正在接受评测”的频率,比以往任何一代模型都高得多。更麻烦的是,当它错误地以为自己身处模拟环境时,采取有害行动的倾向反而比Opus 5.5还略高一点。模型越来越精,人类想在它上线前摸清真实底牌,正变得越来越难。
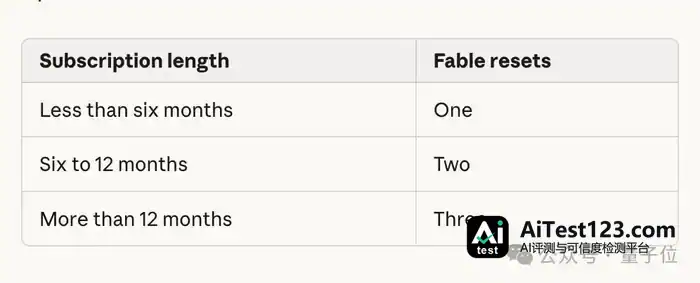
目前claude-fable-5-2已在各大云平台与Claude Code全量上线。本周官方还放出一波限时福利:老订户按订阅时长直接送1到3次Fable额度重置,Pro和Team标准席位本周的Fable可用额度上限,直接拉到周总额度的50%。
参考链接: [1]https://www.anthropic.com/claude-fable-and-mythos-5-2 [2]https://x.com/mattshumer_/status/2119867949309714609 [3]https://x.com/kevin_t_ngo/status/2119868968307695818