

Anthropic发布Fable 5.2与Mythos 5.2:token降20%,长任务能力大涨
赶在IPO之前,Anthropic发布了Claude Fable 5.2和Mythos 5.2。 两者采用同一底座,核心差异为安全权限:Fable 5.2面向通用用户,带有网络安全与生物领域的安全防护限制;Mythos 5.2仅向经审核的机构开放,解除相关限制以支持合规的网络安全、生命科学研究。 新版本最大的升级在长任
 Anthropic赶在IPO前推出了Claude Fable 5.2和Mythos 5.2。
两款模型共用同一底座,区别落在安全权限上: Fable 5.2面向普通用户,在网络安全和生物两个领域设有防护限制;Mythos 5.2只开放给通过审核的机构,相关限制被解除,用来支撑合规的网络安全与生命科学研究。
长任务能力是这次升级的重头,机器人训练方向尤其明显。与此同时,Fable 5.2的token价格比Fable 5.1低了20%。
在审美和设计方面,Fable 5.2相较Fable 5.1也有不小的进步。
模型上线半小时,就有人拿它做出了一款画面相当精致的FPS游戏。
不过独立测评机构Artificial Analysis发了长文吐槽:Fable 5.2的智能水平确实上去了,token单价也确实降了,可摊到每个任务上的平均成本反而更高。最让这家机构受不了的是,Fable 5.2比以前“话痨”得多。
性能到底涨在哪?
先看评分。
机器人控制RoboDojo Sim从27.6%升到64.9%,涨了2.35倍;图表识别由44.8%到73.4%;远程职业任务从17.9%到41.3%;科研终端由52.6%到74.6%;FrontierCode 2.0从32.4%到49.1%;带工具的HLE由65.6%到74.2%。
电脑操作(Computer Use)OSWorld 2.1仅从83.5%走到89.3%,幅度有限;知识工作AA-Briefcase也只由61.5%(ELO 1669)升到66.1%(ELO 1785)。
也就是说,越耗时、调用工具越多的长任务,Fable 5.2的涨幅越大;一轮就能答完的题目,基本原地踏步。
那所谓的长任务,究竟有多长?
Anthropic做了一组对照试验:1000个Fable 5.2的agent跑了将近30个小时,把费马大定理的形式化证明做完了。此前有个未发布的版本,配上专用的定制化工具调度框架(purpose-built harness),再加上研究员全程引导,完成同样的工作仍要11天。
而且Fable 5.2消耗的action token,只有那个未发布版本的三分之一。
换成1000个Opus 5.5的agent,结果是18小时完成26%,30小时27%,之后任务就卡住不动了。
数学推理这类显而易见的长任务之外,在Anthropic性能表列出的全部长任务基准里,RoboDojo Sim是涨幅最大的一项。博主@himanshu专门发文提醒,Fable 5.2要重点看机器人和蛋白质设计这两项。
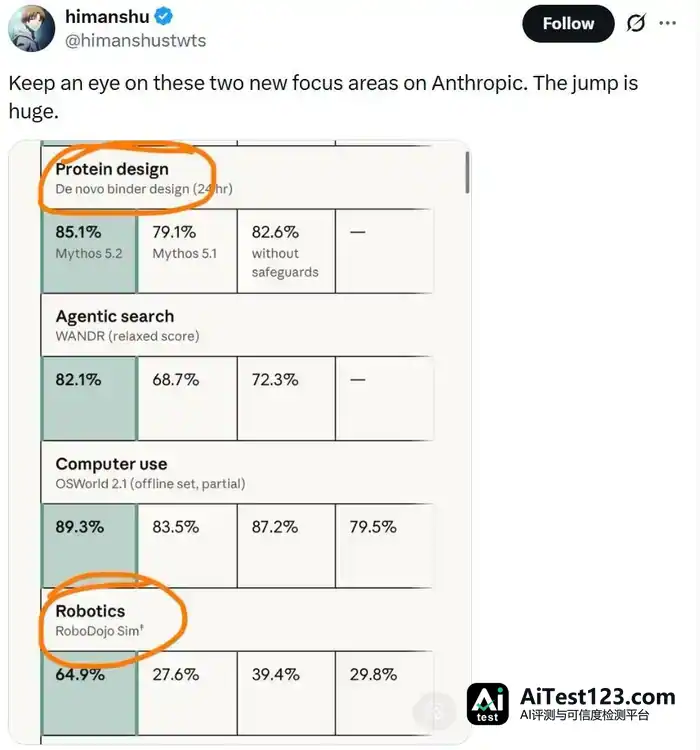
这个公开基准包含42个仿真任务和18个真机任务,双臂操作,模型只能从摄像头画面读取环境。评分分五个维度:泛化、记忆、精度、长程执行和开放词汇指令。
它考的是看画面、记前面、把一串动作连续走完;中途机器人“歪了”,得自己纠正回来。
Anthropic官方称,它超过了“大多数专为控制机器人而建的AI系统”,原因是这些任务机器人在现实世界里完全没见过。
以往的观点是,机器人得专门训练具身智能模型,才能解决空间理解、动作规划这些问题。Fable 5.2是通用模型,任何公司都能直接拿它训练机器人,具身智能公司的训练门槛因此被大幅拉低。
在Anthropic最擅长的编程领域,官方博客放了一张图,列出几个当下最强的大模型在FrontierCode 2.0基准上的跑分。
Anthropic还让Fable 5.2在不同effort档位下分别跑分,结果出人意料,甚至让人一度怀疑是填表时写错了。
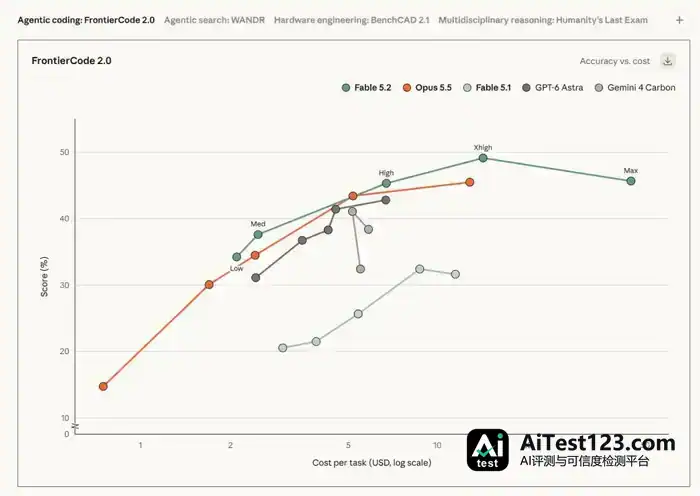
Fable 5.2的Xhigh模式全球最强,得分49.1%,每个任务14.19美元。effort拉到最高的max档,得分反倒掉下来,为45.6%,平均每个任务44.70美元。
也就是说,思考时间更长、token花得更多,效果却不如Xhigh模式。
Anthropic官方给的解释是:高effort制造的是过度斟酌。
在Anthropic看来,effort调高之后,模型处理常规任务时容易“搜集超出任务所需的上下文并过度斟酌”,官方为此还准备了专门防“过度规划”的提示词。FrontierCode测的却是补丁能不能合格地合进真实仓库,上下文本来就摆在diff里,把两行就能修好的东西写成带主张的重构,放到这套基准里自然不合格,得分也就落在Xhigh之下。
还有一种可能,Anthropic提到,模型思考时间太长,交卷就会超时,而超时是要扣分的。
Fable最大特点是……便宜?
价格方面,Fable 5.2每百万token输入从10美元砍到8,输出从50美元砍到40,降幅20%;输出速度则比5.1最多快30%。
fast mode单独计价,输入16、输出80,相当于价格翻倍,换来token生成最多再快2.5倍。
缓存读只要0.20美元,Fable 5那边是1美元。
Anthropic称,Fable 5.2的effort开到High,成绩就大致追平Opus 5.5拉满(Max)的水平,而每个任务的成本只有后者的一半左右。
只是降价的原因,Anthropic官方从头到尾没有给出解释。
那这20%到底从哪来?
9月12日,阿莫迪发文“We Must Pace the Frontier”,文中说放慢“不意味着停止模型训练或技术进步,而是确保公司有足够时间对齐并给模型加防护”。
10天后的9月22日,Anthropic发布Opus 5.5,标价下调20%至4和20,并称运行成本比Opus 5低约40%。大约两小时后,OpenAI拿出GPT-6 Sol和Luna,价格比GPT-5.6促销价低约50%。
Ramp经济学家阿拉·哈拉齐安(Ara Kharazian)的说法是:“这不是什么技术革新,这其实是一种价格战,压低AI价格,也压低了自己的利润率。”
还有一处让人很在意:版本序号写的是5.2,可此前的Opus已经迭代到5.5了。The New Stack表示,“竟然没叫Fable 5.5,真让人有点意外”。对于版本序号,Anthropic没有作任何解释。
Fable 5.2发布不到一个小时,打脸的就来了。
独立评测机构Artificial Analysis发了一篇长帖。他们把Fable 5.2放进Intelligence Index v5,max档拿下65分登顶,比Opus 5.5的59分高6分,比上一代Fable 5.1的49分高约15分,九项评测中有五项拿了最高分。
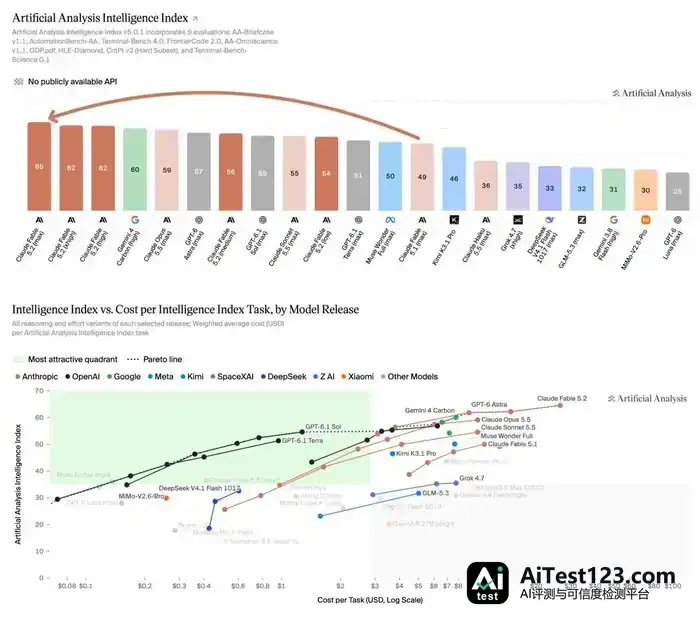
别急,Fable系列一直是智力天花板,这点没什么疑问。Artificial Analysis接着写道,max档平均每个任务要花26.5美元,是Opus 5.5在max档10美元的约2.6倍,也是Fable 5.1的两倍左右。
单价是降了20%,总成本反倒翻了一番。Artificial Analysis还“补了一刀”:Fable 5.2在评测里生成了约2.75亿token,同类模型中位数只有7280万,“它话太多了”。
最后一点,性能跑分可以用数值衡量,而Anthropic表示Fable 5.2在设计方面也做了升级迭代。
结果Fable 5.2发布不到半个小时,社区就有人拿它试着开发FPS游戏。
演示里枪械、射击反馈和场景都齐了。评论区有网友看完,觉得这都能直接发布了。
如果你只知道自己想玩一款什么样的游戏,连第一行代码都还没写,这时候倒可以让Fable多想几步。














