Anthropic推Claude Fable 5.2:编程超GPT-6 Astra
IT之家 11 月 10 日消息,Anthropic 今天(11 月 10 日)发布 Claude Fable 5.2 与 Claude Mythos 5.2 两款前沿 AI 模型。官方称,新模型在编码、推理、科学研究、网络安全及机器人等领域均有显著提升,同时输出速度最高提高 30%,成本下降 20%。 根据官方披露的
 Anthropic 在 11 月 10 日推出 Claude Fable 5.2 和 Claude Mythos 5.2 两款前沿 AI 模型。按官方说法,新模型在编码、推理、科学研究、网络安全、机器人这些方向上都有明显进步,输出速度最高提升 30%,成本则降低 20%。
官方公布的跑分里,面向“智能体编码”的 FrontierCode 2.0 基准测试上, Claude Fable 5.2 拿到 49.1%。这一成绩高于 OpenAI 的 GPT-6 Astra(42.8%)、Google 的 Gemini 4 Carbon(41.1%),也高于 Anthropic 自己的 Opus 5.5(45.5%)。
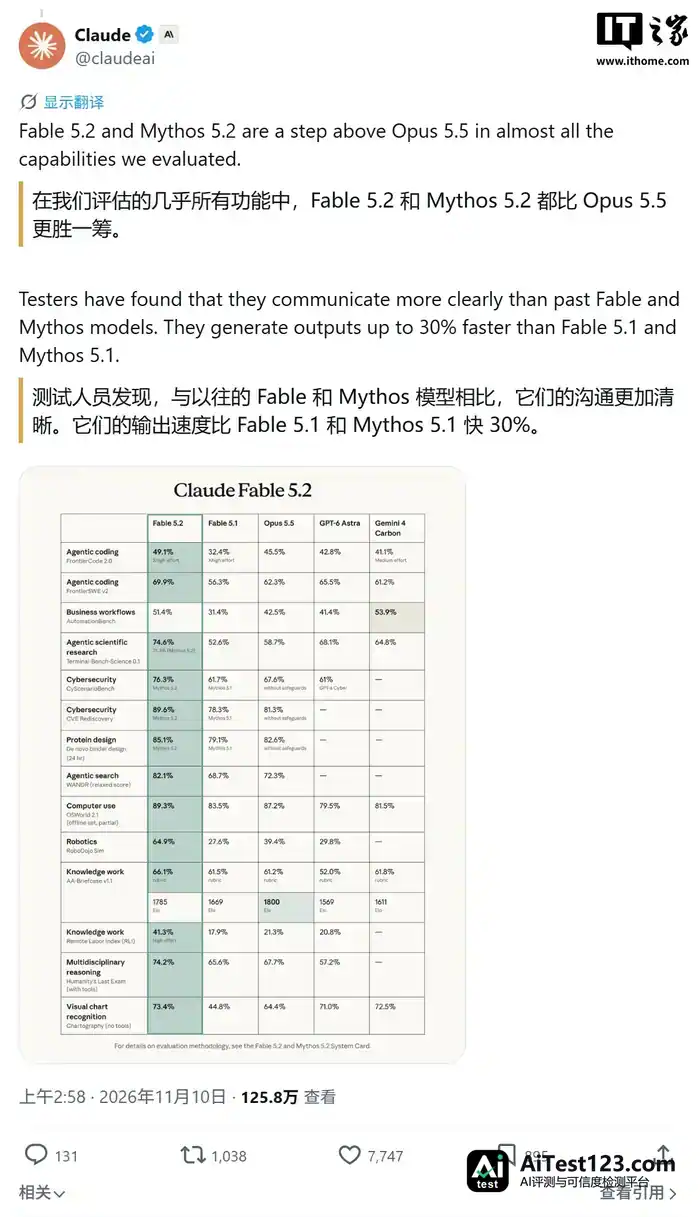
多学科推理测试“Humanity's Last Exam”中, Fable 5.2 同样领先,成绩为 74.2%,GPT-6 Astra 则是 57.2%。
长程协作能力方面,Anthropic 演示了一个案例:Fable 5.2 调度超过 1,000 个 AI 智能体,用 8 天时间从零做出一个能启动的操作系统,设备驱动、文件存储、窗口系统和安装程序都包含在内。
科学视觉推理基准 VIALS-AA 上,Claude Fable 5.2 的工具调用次数更多;OpenAI 的模型则是智能提升后工具调用次数减少,两者走势相反。相关视频如下:
得分上,Claude Fable 5.2(最高配置,with fallback)在 VIALS-AA 拿到 67%,Gemini 4 Carbon(high)为 64%, GPT-6 Astra(max)为 63%。

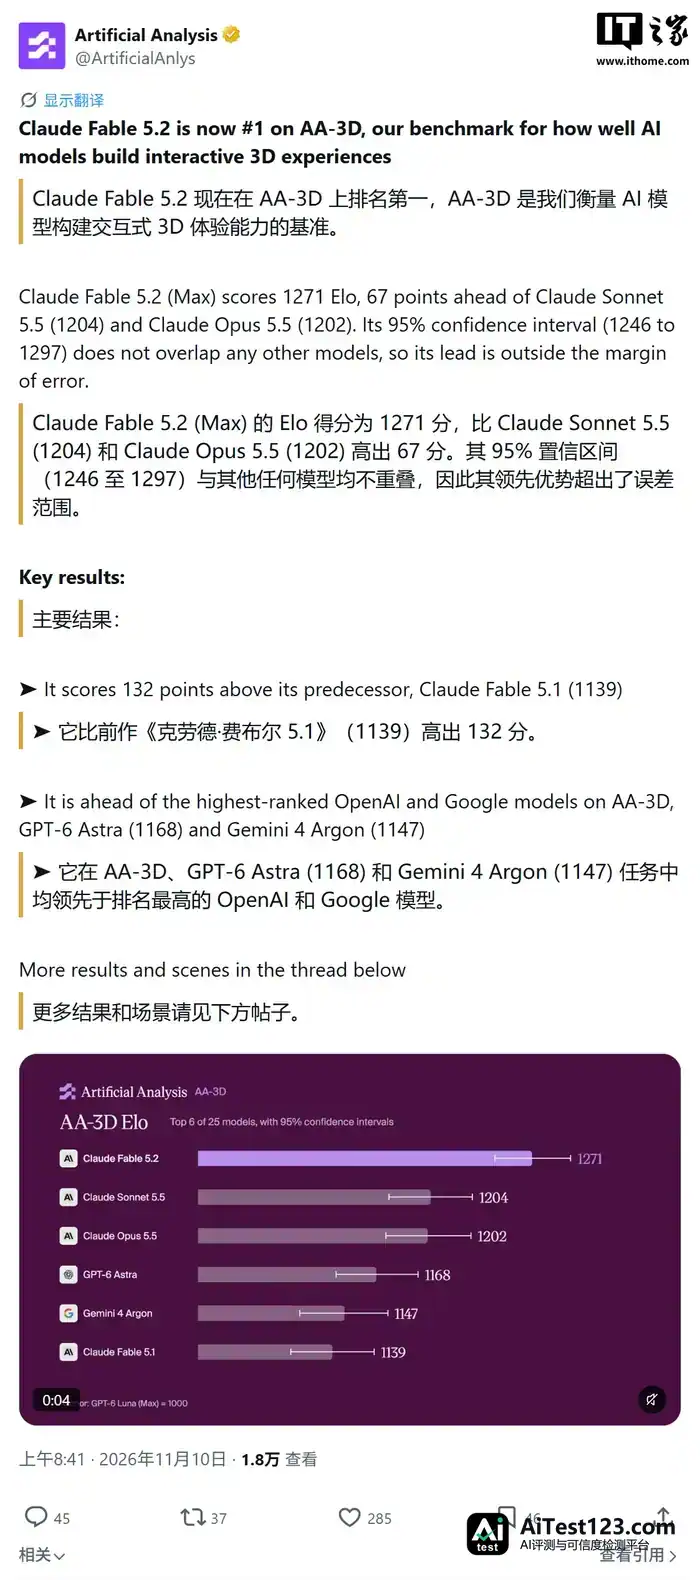
AA-3D 基准衡量的是 AI 模型构建交互式 3D 体验的能力,Claude Fable 5.2(Max)在此的 Elo 得分为 1,271 分,比 Claude Sonnet 5.5(1,204)和 Claude Opus 5.5(1,202)高出 67 分。其 95% 置信区间为 1,246 至 1,297,与其他任何模型都不重叠,领先幅度因此超出误差范围。