李飞飞World Labs开放Atlas:注册送10000积分,一句话生成3D世界
世界模型的竞争要开始了吗
李飞飞团队那个靠「一张图片生成整个 3D 世界」刷屏的世界模型,如今向所有人敞开了大门。
就在今天,由「AI 教母」李飞飞创办的 World Labs 正式开放世界模型  Atlas,网页应用和开发者 API 同步上线,新用户注册即送 10000 积分。
体验地址:
atlas.worldlabs.ai
曾经只在演示视频里出现的能力,现在普通人也能上手:随手画几栋房子、一条小路,AI 就能把草图变成一个可以自由探索的 3D 世界。场景布局能调,镜头能规划,视频能生成,最后还能导出到 Blender 或游戏引擎里接着加工。
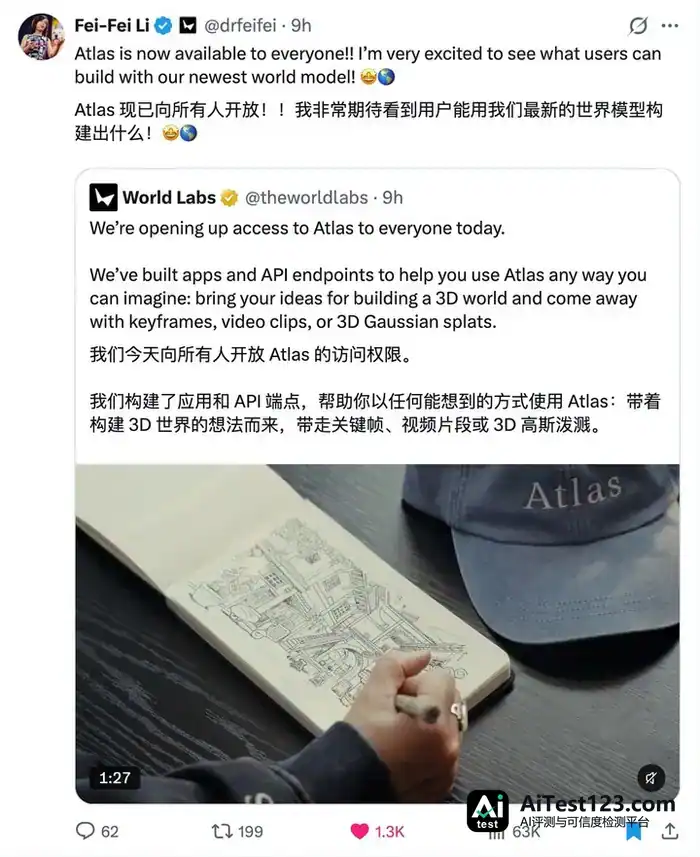
这次开放还带来两款全新的 Web 应用 Viewfinder 和 Chisel,进 Atlas 网页就能直接上手。李飞飞转发 World Labs 宣布开放的推文时难掩兴奋,表示「Atlas 现已向所有人开放!!我非常期待看到用户能用我们最新的世界模型构建出什么!🤩🌎」
a16z 合伙人 Martin Casado 同样给出超高评价,他认为这是自生成式 AI 兴起以来,3D 生成/重建领域最大的一步。

完整的世界模型工具链
登录 Atlas 需要手机号验证,我们测试用 +86 手机号也能正常收到验证码。不过之后选择使用区域时,要记得选美国或加拿大,后续体验才能正常。
新用户登录后,首页有四个工具:Viewfinger、Chisel、Relight 和 Splat to mesh。名字看着都很专业,其实做的是「世界」从生成到工程化的完整链路。
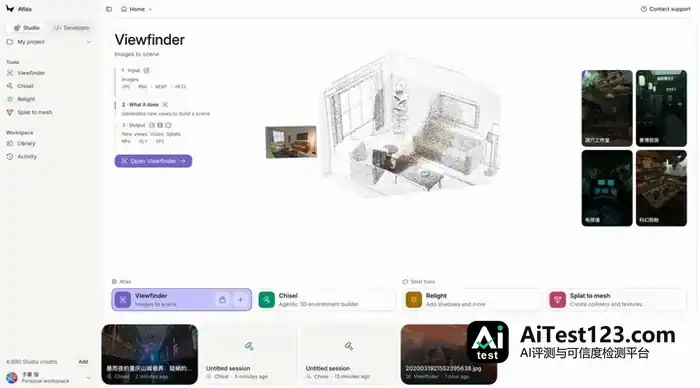
Viewfinder 管的是从图片到场景。给它照片,或者文生图,它就能建起场景,让人探索新视角、设置相机路径,再渲染成视频。原本固定在图片里的画面,于是有了被重新取景的可能。
只要有一张客厅照片,就能拿它当 Viewfinder 的起点——画面可以是从窗边看沙发,也可以是顺着房间缓缓推过去的一段镜头。
问题是这张照片没拍到沙发背面,模型得推测那里长什么样;画面之外还有多大空间,也要补全。Viewfinder 从单张图片往外扩,生成的是一个能延展的场景,里面包含大量想象。
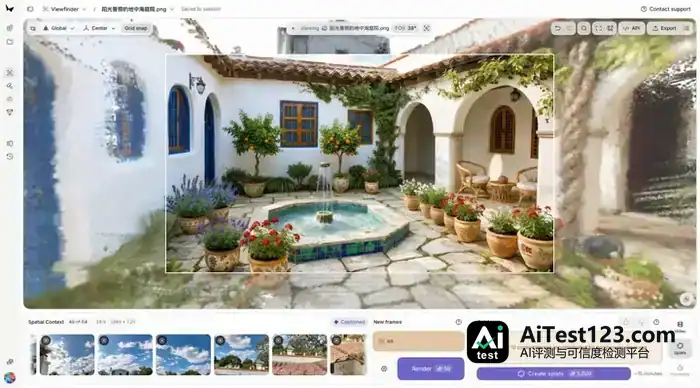
要重建现实中存在的地方,就得多给几个视角。官方提到,Viewfinder 支持从单张图片生成场景,也可以用最多 64 个输入来重建现实环境。
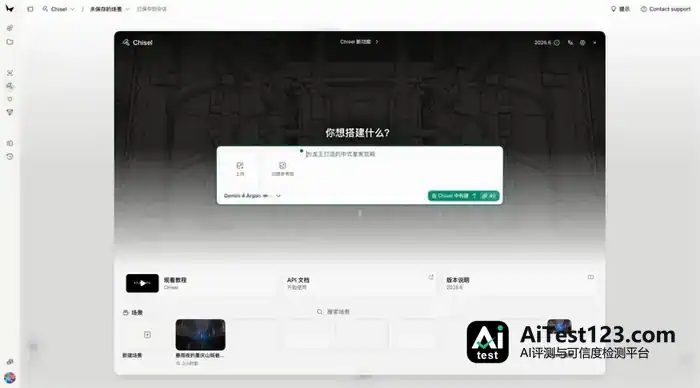
但创作很快会撞上下一个问题:生成的房间确实好看,布局却不符合拍摄需要。沙发离窗户太远,走廊太窄,想要的镜头根本摆不进去。这时候第二款工具 Chisel 就派上用场了:先用简单的三维形状搭出场景结构,确定物体位置,再让模型照着这些结构生成视觉效果。
这套流程更像简化版布景:墙在哪儿、家具怎么摆要先定下来,材质、光线和整体风格随后再考虑。World Labs 的开发者在演示里把这种工作方式说成先搭空间,再自由调整视觉风格,同时保持墙壁的位置。
四项工具的功能合起来,世界模型需要用的能力基本都覆盖了。
- Viewfinder:图片 → 场景。输入 JPG/PNG/WEBP/HEIC,生成新视角(MP4)或高斯溅射点云(PLY/SPZ)。
- Chisel:智能体驱动的 3D 环境搭建器。支持图片、文档、网页 URL、网格模型(GLB/glTF/OBJ/FBX)混合输入,用自然语言指挥 AI 搭白模,再由 Atlas 渲染出图、出 splat。
- Relight:给 splat 场景重新打光,加阴影。
- Splat to mesh:把 splat 点云转成带贴图的 GLB 网格,直接对接游戏引擎。
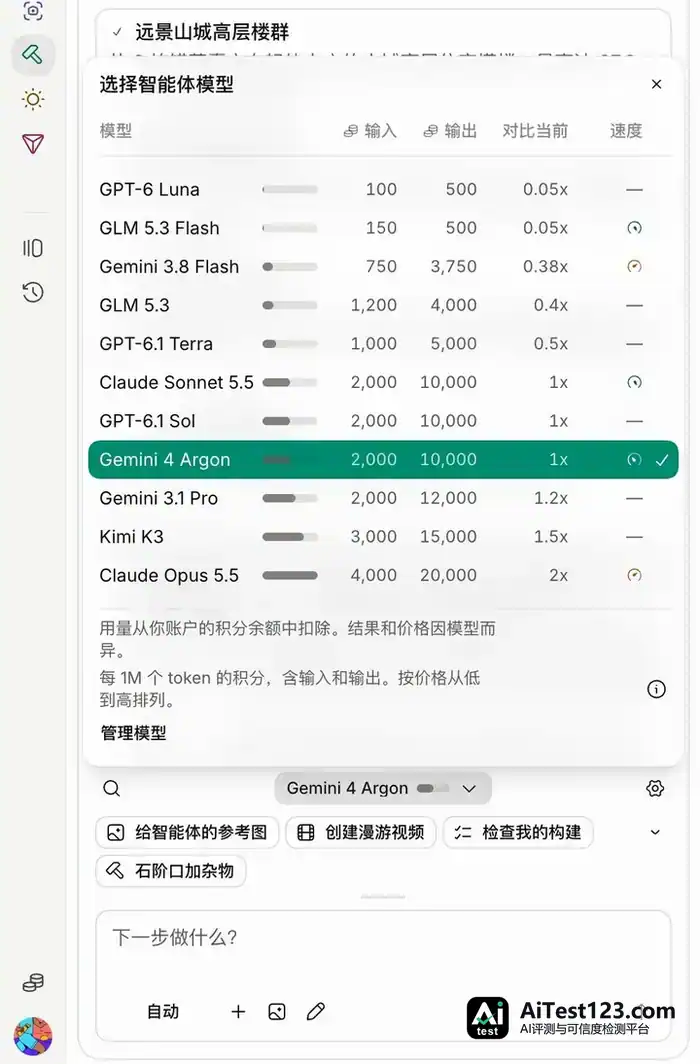
平台目前采用积分制:Viewfinder 渲染一帧 50 积分,Chisel 智能体按 token 计费(Gemini 4 Argon,每 1M 输出 token 10000 积分),Chisel 整组渲染 160 积分,生成完整 Splat 则要 5000 积分。
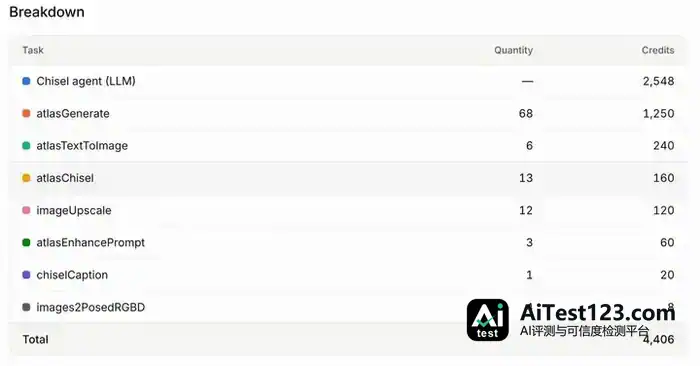
我们在 Viewfinder 内每生成一张图片消耗 50 积分,大额消耗主要在渲染和视频生成上。免费计划领的 10000 积分,拿来做一次简单体验、试试 Atlas 这个新模型的各项功能,还是够用的。
实测 Atlas,重建一座重庆山城
官方演示里传播最广的一个案例,是把笔记本上的随手涂鸦变成能走进去的 3D 场景。

我们也让 AI 画了一张草图:小房子、大树、微笑的太阳、蜿蜒小路,然后传进 Chisel 初始化整个场景。
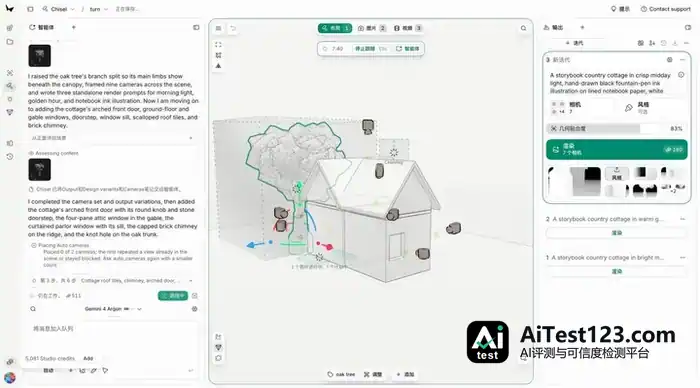
点下「在 Chisel 中构建」,系统先出一张参考图,接着内置智能体自动搭 3D 白模。建筑体量怎么拆、门窗怎么开、招牌怎么挂、机位怎么摆,全过程实时可见;悬空、穿插这类几何错误,它也会自己检查并修掉。
左侧的智能体对话框还能接着调搭建流程。搭完之后,智能体交付场景、多个零遮挡机位和几套渲染方案,时间、天气、氛围各不相同。
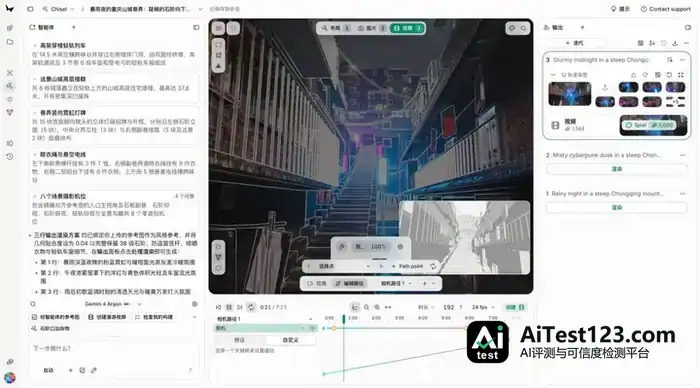
右侧输出面板里挑一套方案,点「渲染」(约 160 积分),全部机位的成片一次生成。
想继续加工也行:给智能体追加指令,比如「加个夜宵小摊」;或者点「创建视频」生成漫游视频;也可以生成完整 Splat,在视口里 360° 漫游。
收尾环节,用 Relight 调光照氛围,或者走 Splat to mesh 转成 GLB 导出。
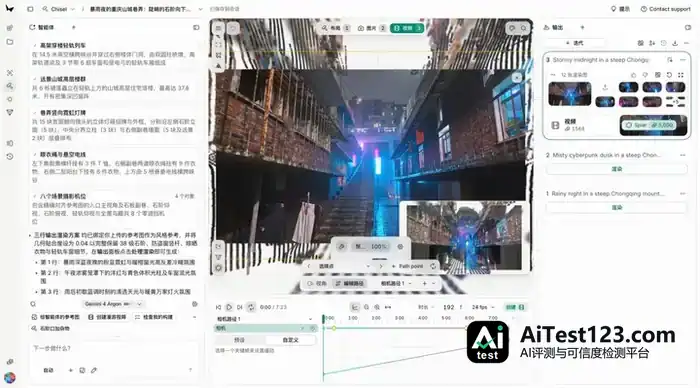
提示词还有一条,是这么写的:「暴雨夜的重庆山城巷弄:陡峭的石阶向下延伸,两侧是层层叠叠的老式居民楼,挂满了霓虹灯招牌和晾衣绳,湿漉漉的石板路反射着粉蓝色灯光,远处一列轻轨正从楼体中间穿过。」
大约 1 分钟,Atlas 先给出一张参考图,石阶、筒子楼、霓虹、晾衣绳、湿路面反光、穿楼轻轨都在里面。
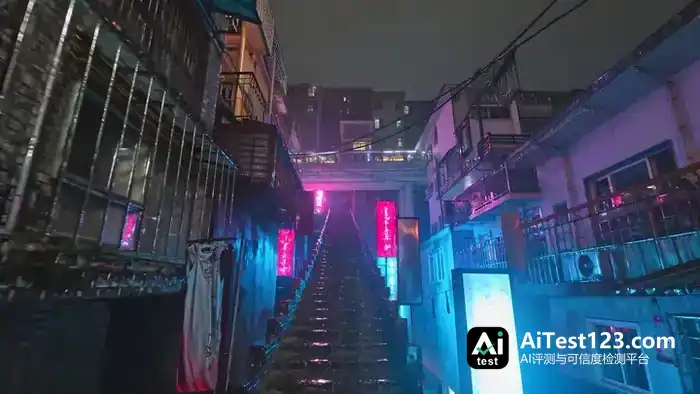
后面的搭建由 Chisel 内置智能体(Gemini 4 Argon)接手,它自己制定并执行了 6 步计划,全程约 30 分钟。
整个流程分 6 步走:先把建筑体量拆开,再摆下 9 个机位,接着把穿楼轻轨和远景楼群搭起来,阳台、防盗网、波纹雨棚一并补上,随后放好 15 块霓虹灯箱和晾衣绳,最后逐个镜头核对视线有没有被挡住。
「悬空」「穿插」「镜头遮挡」这些几何错误,系统一直在自动查,碰到「轻轨桥墩悬空 8.25 米」这种问题当场就修。智能体的思考过程也能看出这套工具的专业度,它会说「缩短近景与中景建筑的檐口高度,以露出开阔的轻轨穿楼视野」。
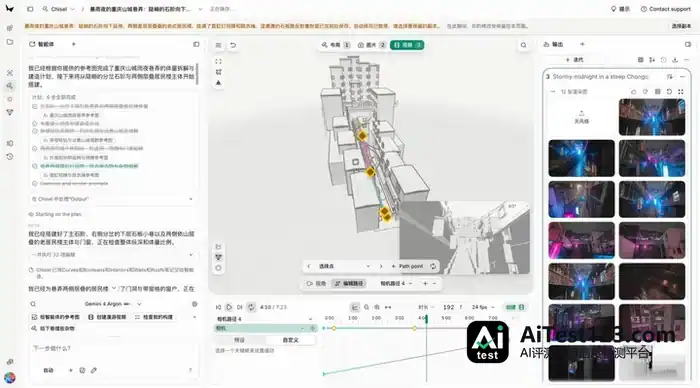
最终场景里有 38 级石阶、左右各 5 栋退台居民楼、3 节带受电弓的轻轨车厢、8 个零遮挡机位。
我们选了「暴雨深蓝夜」这套渲染方案(160 积分),12 个机位一次出齐:湿滑石阶上粉蓝霓虹的倒影、砖墙上的防盗窗笼、绳上晾晒的 T 恤,一样不少。
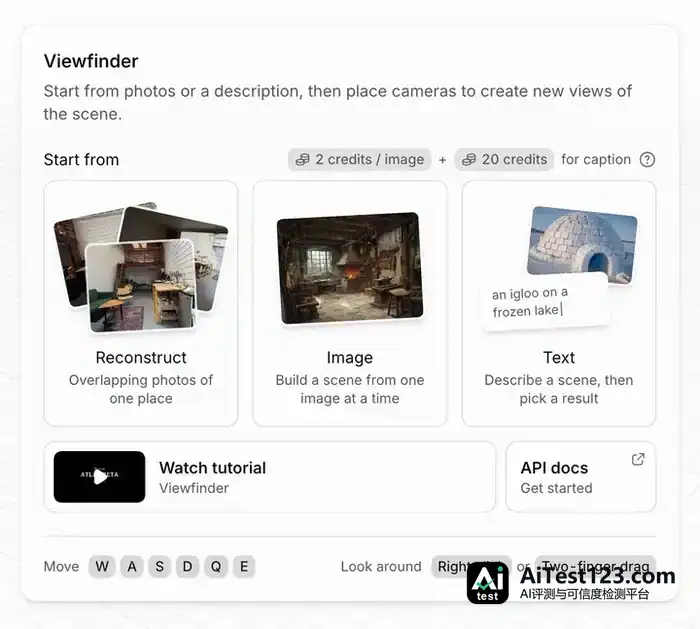
想最快上手 Atlas,还是走 Viewfinder:点「Drop or click」上传图片(支持 JPG/PNG/WEBP/HEIC),选 Image 模式导入。
图片进了 3D 视口会先当一个「画框」,点一下画布完成放置。然后鼠标控制相机:左键拖拽环绕,中键拖拽平移,滚轮缩放。
把相机挪到新位置后点 Render(50 积分),约 1 分钟内生成当前视角的新画面。这里有个要点:必须平移离开原始机位,深度估计要靠视差,原地旋转是渲染不出来的。
多换几个角度重复渲染,底部胶片栏会一帧帧累积。帧数够了,可以选 Splats 模式点「Create splats」生成完整点云(约 15 分钟),也可以在 Video 模式下出视频。
最后从右上角 Export 导出 MP4 / PLY / SPZ 文件。
不想开网页的话,Atlas 还有完整的开发者 API,Chisel 界面里就有「API 文档」入口,世界生成能力可以直接接进自己的产品管线。
会写代码的 AI,也开始搭场景了
Atlas 开放后,World Labs 设计师 Ian Curtis 把世界模型、编程模型和网页三维技术塞进了同一个演示:Fable 5.2 + three.js 搭配 Atlas,搭出一个第一人称实时漫游的 3D 世界。
这个组合也接上了 AI 编程热潮里的另一个问题:代码越来越容易生成之后,场景和视觉资产该由谁来做?
交互作品光把程序跑通还不够,用户最终要看的场景、材质和画面,同样得有人做。
研究者 Ben Mildenhall 在介绍这次发布时把分工说得更细:先用 Agent 把粗略的三维几何结构搭出来,再通过 Atlas 的模型接口去控制最终画面的生成。Chisel,以及这次提供的 Codex、Claude Code 集成,都是照着这个思路设计的。
他提到,纯靠代码程序化地做出精细画面,成本仍然很高,两条技术路线可以搭着用。
编程 Agent 管搭结构、串联操作,世界模型按空间约束生成视觉内容。过去要在不同工具之间来回倒腾的活,现在开始有接上的可能。
Atlas 也在试着把生成结果送进现有的制作流程。官方给了 Blender 集成,还有把 Gaussian splats 转成网格的工具,方便用户接着拿去做游戏、交互环境等项目。
不过导出一个场景,离做完一款游戏、一部影片还差得远。交互规则、角色行为,还有资产的检查和调整,都得接着处理。
世界模型这条赛道的竞争,激烈程度不输通用模型。Viggle 的 Hang Chu 发了 JST-2 与 Atlas 的并排对比,强调自家方案直接生成三维内容,并质疑 Atlas 把视图重建为 Gaussian splats 那一步多出来的工序和耗时。
说到底,Atlas 这次开放的意义可能不在单次生成的画质,而在于它把「世界模型」包装成了一条能用的工作流:从一张图、一句话,到可分镜、可渲染、可漫游、可进引擎的 3D 资产,每个环节都有明确的工具、明确的标价。
以前 AI 编程工具能帮我们写出一个游戏,却很难独立把游戏里的场景和视觉资产做出来。现在编程 Agent 负责搭建结构、编写交互,世界模型负责把这些结构变成可以探索、拍摄和继续加工的三维环境。对独立开发者来说,做游戏、做交互作品,可能不用再从零手工搭每一个场景。
对普通人也是一样,就算不懂三维建模,也终于有机会把脑海里的一个画面,变成能走进去的世界。
AI 已经越来越会写代码,下一步,就是让它把代码里的世界也造出来。