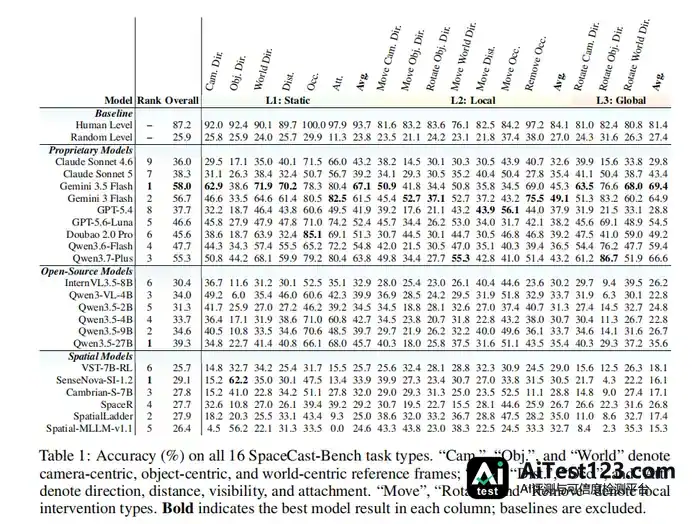
浙大SpaceCast-Bench评测21个VLM:预测性空间推理最高仅58.0%
空间专项模型反而不如通用模型?浙大庄越挺团队提出空间智能新基准
所属频道
模型发布

01
现有空间推理,难在变化之后
02
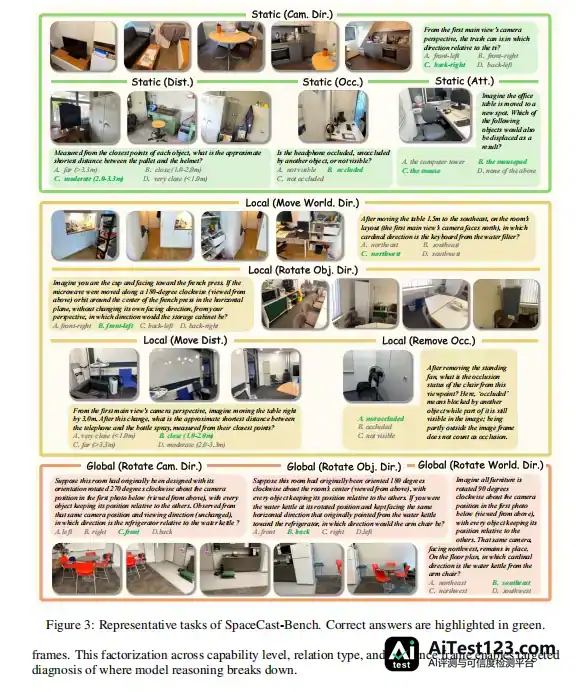
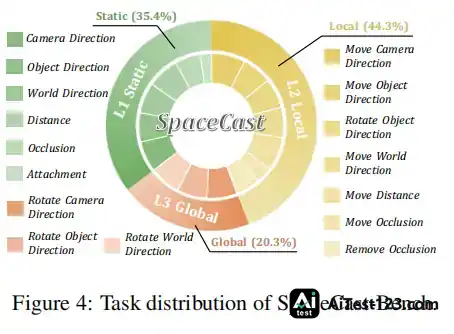
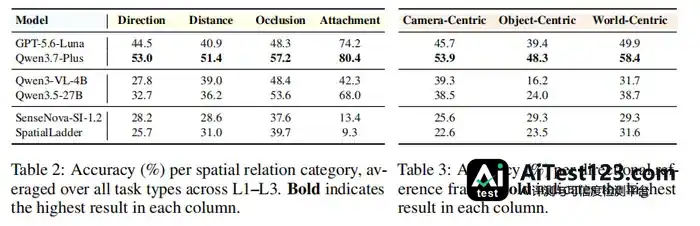
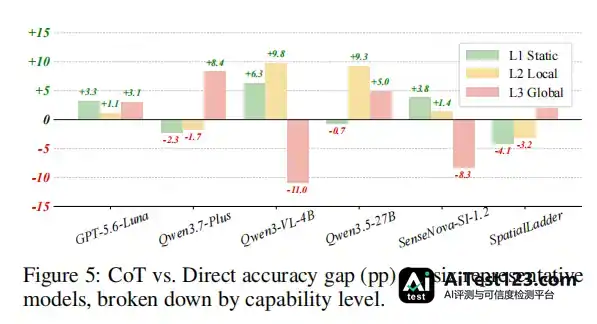
三个层级拆开测,预测性空间推理的短板在哪

03
空间专项模型为何没占到便宜?
04
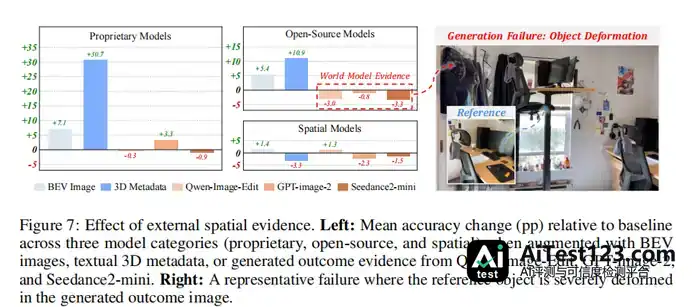
显式 3D 信息,能帮视觉语言模型把空间推理做得更好
05
多视角整合、训练效果与评测边界
06
对话 SpaceCast-Bench 一作李弘幸
▎AI 科技评论:不少空间理解任务盯的是视觉语言模型能不能认出当前场景里的空间关系。团队为何认定只理解当前状态不够?为何要再往前一步,研究“根据场景变化预测新的空间关系”?
▎AI 科技评论:从理解当前空间到预测空间变化,中间最难的地方在哪?
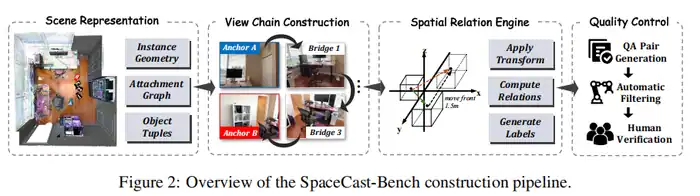
▎AI 科技评论:SpaceCast-Bench 为何采用 observe–transform–infer 这一框架?
▎AI 科技评论:团队此前做过 ViewSpatial-Bench、SpatialLadder、SpatialEvo、GPD 等工作。这几项工作和 SpaceCast-Bench 如何串成一条线?
AI 科技评论问:这次实验里,哪些结果和你们原来的预期不一样?
AI 科技评论问:6 个空间专项模型整体表现偏低,怎么看这个结果?
AI 科技评论问:BEV、3D metadata 等显式 3D 信息都带来了提升,这些结果给你们什么启发?
数据:https://huggingface.co/datasets/hongxingli/SpaceCast-Bench
本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。