547亿元收购后首次同台,李飞飞对话苏姿丰,详解统一世界模型Atlas
无论AI发展得多么先进,人类智能依然非常宝贵。
机器人前瞻11月12日报道,今天,在CoRL 2026上,李飞飞发表演讲《 Atlas:一个用于生成与重建的统一世界模型》,随后与AMD董事长兼CEO苏姿丰进行了一场炉边对话,这是AMD宣布收购World Labs以来,两人首次公开同台。
今年九月,AMD宣布与World Labs达成最终收购协议,交易价值约82亿美元(约合人民币547亿元),预计在2026年底前完成。
李飞飞在演讲中提到以下几个重点:
1、在机器人领域,如何理解和表征环境、预测动作可能产生的后果,以及通过仿真补充真实世界数据,是机器人需要解决的三个核心问题。
2、Atlas的三种模式,分别为多图输入做稠密重建,零像素条件做纯生成,少量视图做稀疏重建。
3、在技术思路上,Atlas采用多模态自回归扩散Transformer架构,核心是通过相机条件控制预测下一个视角。
它既能根据大量图像进行稠密重建,也能仅凭少量图像进行稀疏重建,甚至在没有图像输入、只有文本提示词的情况下生成场景。
4、李飞飞还披露,目前正在测试Atlas在机器人仿真中的实际价值。Atlas不仅可以生成和重建三维环境,还可以用于机器人训练和导航,将真实世界与仿真世界连接起来,再让仿真结果应用于真实机器人。
同时,李飞飞也在演讲中展示了相关探索,机器人可以完全在虚拟仿真环境中训练,再以零样本方式部署到真实世界。
5、最后,李飞飞还强调了Atlas在Rapidata相机运动基准中,排名第一。
在圆桌对谈阶段,刚开始时,苏姿丰便对机器人领域的未来作出预测,称物理AI尤其是机器人,是未来几年数千亿美元的机会,并透露AMD已有规模相当不错的机器人研究团队,不过目前相关布局仍处于早期阶段。
李飞飞提出,“AI就是计算,计算就是AI”的观点,并认为前沿LLM/VLM与专用模型各有所长。
而在这一过程中,双方都呼吁为公共部门研究者提供更多算力,需要借助公共部门的力量,理解和评估AI正在做什么,开展基准测试,并向公众提供信息,帮助其理解。

以下是演讲与圆桌讨论的实录:
今天我想和大家分享的是,World Labs研究团队最近开发的一个模型,名为Atlas。这是一个用于生成与重建的统一世界模型(A Unified World Model for Generation and Reconstruction)。
既然我们今天身处CoRL会议现场,就先从机器人领域的需求谈起。
我知道,机器人领域正在发生很多变化,也取得了很多进展。就在一天前,我们还看到了新的研究成果。无论我们采用什么样的机器人技术路线,无论是否使用策略学习(Policy Learning),无论是否使用智能体(Agent),都有一个机器人领域试图解决的根本问题:
给定世界当前的状态、任务目标以及机器人本身,在每一个时刻,机器人下一步应该做什么?
总体而言,机器人需要解决几个基本问题。
首先,机器人需要具备理解和表征世界状态及周围环境的能力。我们可以讨论这种表征究竟应该是隐式的还是显式的,但对环境的理解本身非常重要。
其次,机器人需要能够预测动作可能带来的后果,并以某种方式对这些动作进行规划。
最后,数据始终是一个问题。机器人领域具有很长的长尾分布,机器人要想成功部署,同样面临大量长尾场景。因此,在很多情况下,如果能够通过仿真尽可能多地生成不同环境和状态,用来补充真实世界数据,就会非常有价值。这既有助于模型训练,也有助于模型评估。
无论我们采用什么方法,这三个问题在机器人领域都依然存在。
这也让我想到世界模型。事实上,上述三个问题分别对应着世界模型试图解决的三个问题。
例如,理解和表征环境,对应世界模型和视觉模型中的渲染问题;预测动作可能产生的后果,对应规划问题;模拟世界中的不同状态,则对应仿真问题。
当然,我不想把这些问题绝对化,也不认为它们是完全相互独立的。实际上,在很多情况下,我们可以将它们统一起来,而且这些问题之间也会相互交织。这些都是当前这一研究领域非常令人兴奋的前沿方向。
01. Atlas试图统一生成与三维重建
今天,我想重点介绍Atlas。这是我们刚刚提出的一款新模型。
总体而言,Atlas主要致力于解决渲染和仿真问题,尤其是世界几何结构以及三维、四维动态过程的模拟。
简单来说,Atlas是一个从零开始训练的自回归基础模型(Autoregressive Foundation Model)。它是一个全模态模型,可以接收多模态输入,包括文本、图像、视频、深度信号、灰盒(Grayboxing)以及三维结构信号。
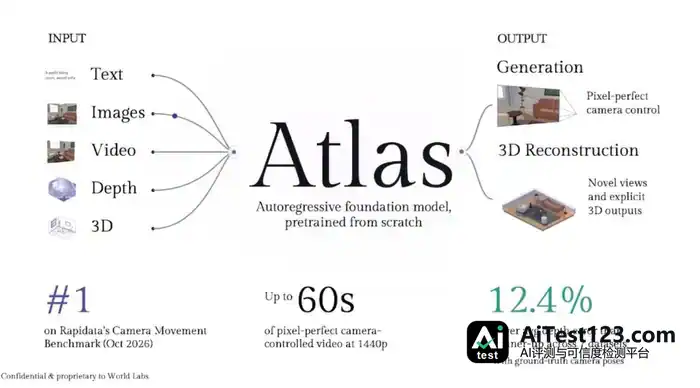
它的输出是像素帧。但Atlas不仅能够以具有时空一致性的方式生成高质量图像帧,还能够合成新的视角,从而实现精确、高保真的三维重建。
接下来,我会展示一些实验结果和具体细节。这里先给大家介绍Atlas的整体能力。
我们先回顾一下相关研究的发展。
计算机视觉领域有两个非常重要的问题。当然,这并不是计算机视觉领域仅有的两个问题,但它们确实非常重要。研究人员已经花了很多年,甚至几代人的时间来研究这些问题。
其中一个就是三维重建问题。我这里展示的研究,既包括经典论文《Building Rome in a Day》,也包括近期最先进的研究,例如NeRF相关论文。

我们试图解决的根本问题是:如何根据从不同相机位置和姿态拍摄的图像,构建一个符合真实世界的三维场景?
大多数传统方法都需要大量具有相机位姿信息的图像。
如果这些相机视角没有覆盖场景的全部表面区域,重建就会变得非常困难,模型也很难准确估计未被覆盖的区域。因此,最终得到的三维重建结果往往存在较大的不确定性。
这就是经典的三维重建问题。
但近年来,生成式人工智能取得了很大进展。现在,我们已经拥有能够直接生成高质量像素内容的纯生成模型。
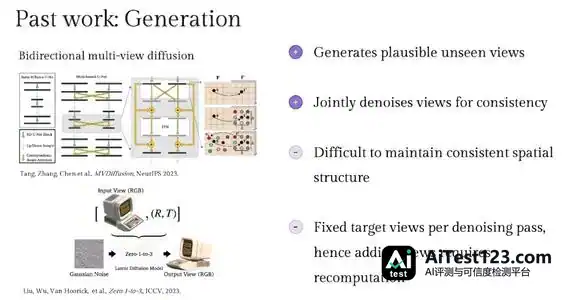
与此同时,基于扩散模型的骨干架构,也为多视角生成研究提供了新的探索方向,进一步缩短生成与重建之间的距离。
沿着这条研究路线,已经出现了一些非常出色的工作。它们尝试生成此前没有观察到的视角,并通过对多个视角联合去噪,保持空间一致性。
不过,总体而言,这些方法的效果仍然有限。它们依然很难维持空间一致性,而且每一次去噪过程通常只能针对一个固定的目标视角。如果希望改变视角,或者实现实时生成,计算成本就会非常高。
Atlas沿着过去几年一系列研究的方向继续探索,尝试将生成与重建统一起来。
我们的目标是使用同一种模型架构和同一套训练方案,同时解决这两个问题。
具体来说,Atlas可以在生成和重建这两个方向之间实现切换。
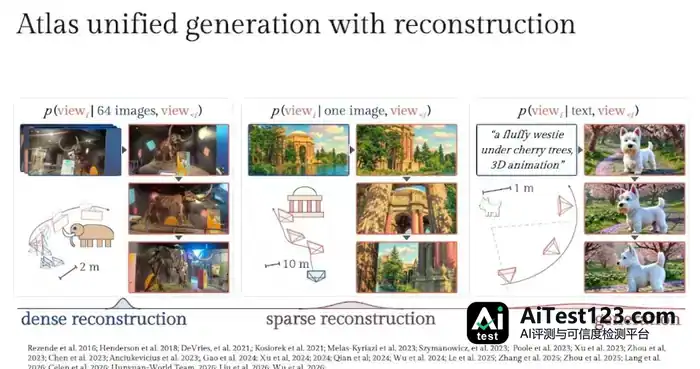
在一个极端情况下,如果Atlas获得多张输入图像,并且图像数量足够多,它就可以执行重建任务。模型能够进行稠密重建,输出质量较高的场景和世界结构。
在另一个极端情况下,如果没有任何像素条件输入,只提供一段文本提示词,Atlas就可以执行纯生成任务。它还能够生成多个具有视角一致性的连续画面。
更有意思的是,Atlas还能够完成一种连接生成与重建的任务,我们称之为稀疏重建(Sparse Reconstruction)。
在这种情况下,Atlas获得的视角数量非常有限。极端情况下,输入甚至只有一张图像。
Atlas可以估计相机位姿,然后进一步生成模型能力范围内的多个视角,最终重建并生成一个完整的世界。
因此,Atlas能够在同一个模型框架下,实现从稠密重建到稀疏重建,再到纯生成的切换。
02.只给少量图像,也能重建一个完整世界
在介绍技术细节之前,我先给大家看一个例子。在座的一些朋友应该能认出这是斯坦福大学校园。
斯坦福有一个非常著名的主广场(Main Quad)。
如果只给模型两张有限的输入图像,它就会生成,或者说补全出一个主广场。
如果你熟悉斯坦福大学,就会发现这并不是我们真正的主广场。它看起来有主广场的感觉,但实际上并不是真实的主广场。
模型根据输入图像中的长廊等特征进行了条件生成,因此生成的场景保留了一些长廊的特点,也出现了拱门,但整体上仍然是根据输入生成的一个广场。
如果给模型八张图像,效果就会好很多。
考虑到这个空间本身非常大,八张图像所提供的信息仍然非常稀疏。但如果仔细观察,模型基本上已经重建出了整个广场。
乍一看,它几乎是完美的。不过,熟悉斯坦福大学的人会发现,著名的纪念教堂(Memorial Church)不见了。这是因为输入图像中没有包含纪念教堂。
最后,如果输入33张图像,虽然从整个空间的规模来看,这些图像仍然非常稀疏,很多区域都没有被覆盖,但其中一张图像确实包含了纪念教堂。
因此,Atlas基本上已经能够重建出斯坦福大学美丽的主广场。
我还想特别强调一点:这33张图像全部是在地面高度拍摄的,也就是说,只是一个人手持相机拍摄的普通图像。
但模型能够生成不同的观察视角,包括我现在展示的这个航拍视角。
那么,Atlas能够做到这一点,背后的技术关键是什么?
03.视角预测是Atlas的核心技术
对于大型语言模型(LLM),我们已经很熟悉下一词元预测(Next Token Prediction)这一目标函数。
而对于Atlas来说,我们的核心理念是:视角就是一切(Viewpoint Is All You Need)。
我们通过精确的相机位姿条件控制,让模型预测下一个视角。
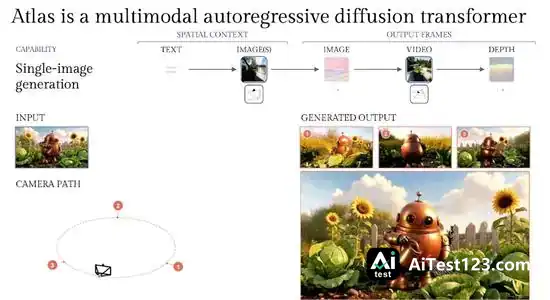
具体来说,Atlas采用了一种多模态自回归扩散Transformer架构。
正如前面提到的,Atlas可以接收文本输入,并根据相机位姿生成图像。
它也可以接收一张图像,估计对应的相机位姿,然后以这张输入图像为条件,生成更多图像以及更多新的相机视角。
这里展示的是一个非常可爱的小机器人,它位于花园中。我们可以看到,模型能够沿着环绕相机的运动路径生成不同视角的画面。
此外,正如刚才斯坦福主广场的例子所展示的,Atlas还可以接收多个视角的图像,并沿着不同的相机运动路径进行插值和外推,从而恢复一个三维场景。
它还可以接收深度图像或者灰盒输入,并输出RGB像素图像。这项能力在很多机器人和游戏应用场景中都非常有用。
接下来,我们用一些定量结果来看看Atlas的表现。我想分别展示它在生成和重建方面的结果。
首先是相机控制生成。
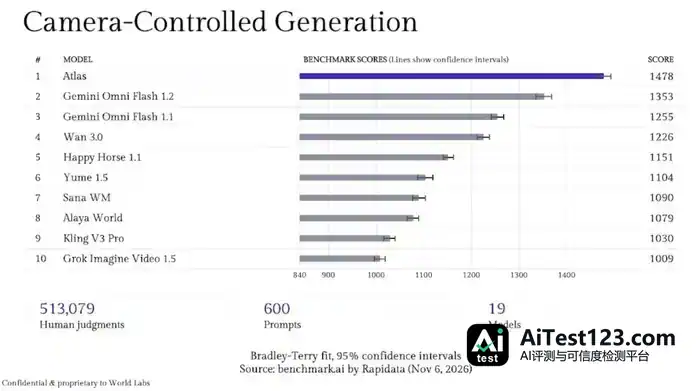
这里的结果实际上是我们几天前刚刚从一家独立第三方机构RapidData获得的。
他们在没有提前告知我们的情况下,对多个最先进的视频模型进行了基准测试,评估的是相机控制生成能力,测试中包含了大约50万次人工判断。
最终,Atlas在这项测试中排名第一,超过了多个当前最先进的视频模型。
从图中可以看到,Atlas与排名第二的模型之间存在相当明显的差距。
Atlas能够生成超过60秒的连贯视频。事实上,它现在能够生成的时长已经远远超过60秒。
这里展示的是我们2026年最新的结果。我特别想将它与大约一年半前尝试的早期模型进行对比。
大家可以看到,早期模型能够生成的范围非常有限,几何一致性也比较差。当时我们甚至收到过这样的批评:你们做的不是世界模型,而是“壁橱模型”(Closet Models)。
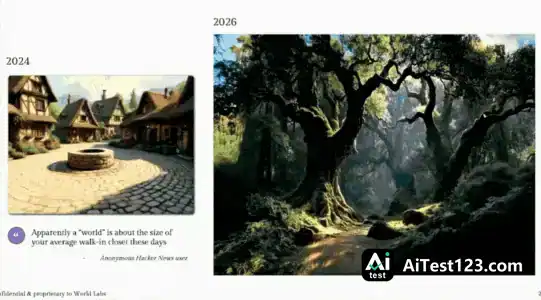
而现在,我们已经从一个壁橱走向了一个大得多的世界。
这里还有一个很有趣的生成案例。
Atlas可以接收两个完全不同、彼此毫无关联的事物,然后估计一个合理的相机位姿,进一步补全场景中的其他部分,最终生成一个将这两个事物结合起来的幻想世界。
这项能力非常适合用于各种创意应用。
最后一个例子是灰盒输入。
Atlas能够接收这些灰盒结构,并将其生成一个完整、精美的世界。
这项能力不仅对机器人领域有用,也适用于设计和创意应用场景。
04. 从深度预测到三维场景重建
接下来,我们来看重建方面的结果。
我们将Atlas与一些专门用于三维重建的模型进行了比较。
首先,我们在七个不同的数据集上测试了深度预测任务。这里的指标越低越好,因为它衡量的是误差率。
Atlas的表现超过了近期一些最先进的三维重建和深度预测模型。
另外,Atlas本身并不需要使用高斯泼溅(Gaussian Splatting)作为场景表征方式。
但如果我们在后续处理中使用这种表示方式,就可以在六个不同的数据集上,将Atlas的高斯泼溅重建误差与专门的重建模型进行比较。
这里我们采用了两种不同的误差衡量指标。结果显示,Atlas表现非常突出,超过了大多数专用模型。
此外,我们还逐步调整提供给Atlas的视角数量,观察模型如何从稀疏重建过渡到更稠密的重建。
在这项实验中,我们同样将Atlas与多个先进方法进行了比较,并在两个不同的数据集上进行测试。
从误差率来看,Atlas再次取得了很好的表现。
这里展示了一些具体案例。
这是三维重建领域一个非常著名的公寓场景。给定八张输入图像,Atlas就能够重建出这套面积相当大的公寓。
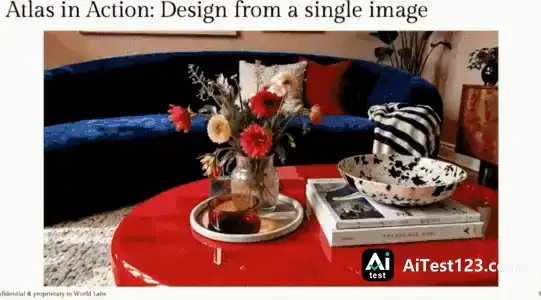
现在,我们可以从各种不同的视角对场景进行采样,人们能够完全控制这些相机视角,从而观察整个场景。
这里还有一个例子,展示了如何将Atlas根据单张输入图像生成的内容,进一步转换到高斯泼溅表示空间中。
大家可以看到,仅凭一张输入图像,模型就生成了一个非常漂亮的幻想空间。
类似地,在下面这个例子中,我们不仅能够生成场景内容,还能够生成深度信息,让艺术家精确控制相机的位置,并生成符合预期效果的视频。
熟悉视觉特效的朋友可能知道一种非常流行的特效,叫作子弹时间(Bullet Time)。
这种效果最早在电影《黑客帝国》(The Matrix)中得到展示。它通过数百台摄像机同时捕捉一个具有时空动态变化的场景,再将这些画面组合起来,形成非常漂亮的子弹时间效果。
现在,我们只使用办公室里临时搭建的三台iPhone摄像机,就能够借助Atlas重建这个时空动态场景,并呈现出漂亮的子弹时间效果。
这里还有另一个例子。设计师将Atlas与LLM结合起来,展示场景中的语义信息。
在Atlas构建的世界中,我们既可以开展各种设计工作,也有望进行机器人仿真。
Atlas最近取得的另一项进展,是我们已经对模型进行了蒸馏,使其能够以每秒15帧的速度实时运行。
最后,我想谈谈Atlas在机器人仿真方面的潜在应用。
我们正在测试Atlas在机器人仿真中的实际价值,包括用于机器人训练和导航,以及将真实世界与仿真世界连接起来,再将仿真结果应用于真实机器人的操作任务。
大家可以看到,其中一些近期研究成果展示出,机器人可以在模拟的虚拟世界中接受训练,随后以零样本方式直接部署到真实世界中。
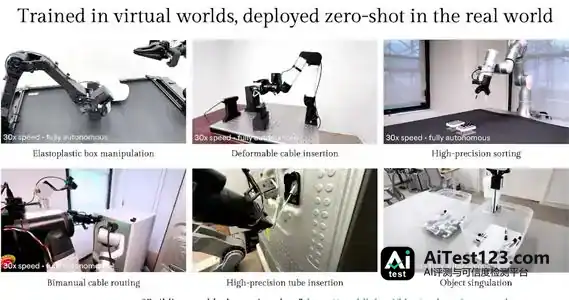
我们正在通过结合Atlas,进一步深化这方面的研究。我们很快就会发布Atlas,请大家保持关注。
最后,我还想邀请大家关注我的学生们所做的出色工作。
其中一项是斯坦福大学Behavior团队举办的Behavior Challenge。今年已经是这项挑战赛举办的第二年,我们将在明天公布获奖者。
今年的比赛非常令人兴奋。挑战赛本身也在不断发展,我们现在看到了许多新的方法,包括生成式AI。
我还会在明天的研讨会上介绍生成式AI驱动的机器人能够做什么、不能做什么。所以,也欢迎大家明天来参加研讨会。
此外,我还有很多学生为了参加CoRL付出了大量努力。
我们有六篇论文入选,欢迎大家在本届CoRL会议期间或者会后了解我们的论文。World Labs团队和斯坦福学生团队都为这些研究付出了大量努力。非常感谢大家!
以下为第二场李飞飞与苏姿丰的圆桌讨论实录。
05.李飞飞对话苏姿丰,谈论机器人发展机遇、AI算力需求与未来人才培养
1、机器人领域,未来几年市场规模可能达到数千亿美元
Peter Stone:首先,我想从Lisa和飞飞开始。今天在座的各位都是机器人领域的研究者。
我们已经听说AMD正在推进对World Labs的收购,刚才飞飞也分享了她对世界模型以及未来发展机会的看法。
我先问问Lisa。AMD一直在人工智能技术栈的各个层面进行投资,从数据中心到边缘计算和嵌入式系统。展望机器人和物理AI领域,你认为AMD面临的最大机会是什么?World Labs又将如何融入AMD更广泛的战略?
苏姿丰:谢谢Peter,也感谢大家邀请我来到这里。
我认为,现在是人工智能发展过程中一个极其令人兴奋的时期。回顾我们迄今为止取得的所有进展,就会发现,我们实际上仍处于未来发展可能性的非常早期阶段。
我认为,物理AI,尤其是机器人领域,是一个巨大的机会,未来几年,这个市场的规模可能达到数千亿美元。
这里的关键在于,我们必须真正理解物理规律、模型以及整个环境。因此,我们非常高兴飞飞和World Labs团队能够加入AMD。
除了飞飞本身就是一位超级明星之外,我们还可以从另一个角度来看待这件事。
在我们的业务中,如果考虑到硬件优化需要持续很多年,那么你对工作负载了解得越深入,对未来发展方向的理解就越充分。
我认为,硬件、软件和系统之间进行协同优化的理念,同样适用于机器人领域。
未来五到十年,这将成为一个极其重要的领域。因此,我真的非常期待World Labs加入AMD。
更重要的是,对于AMD的生态系统而言,我也非常期待能够借此进一步扩大AMD生态系统,让这里整个机器人社区都参与进来。
2、AI是计算,计算也是AI
Peter Stone:飞飞,接下来我想问你。从你的角度来看,加入AMD会如何拓展World Labs的能力?
你已经阐述了自己对于世界模型的愿景。那么,双方的结合能够让你们接下来构建什么?这又会给机器人领域带来什么?
李飞飞:实际上,我认识Lisa已经很多年了。回顾过去十年,从AMD到整个计算领域,再到如今人工智能爆发的时代,Lisa所做的一切都非常了不起,令人惊叹。
在人工智能领域,模型与计算之间的关系已经发生了根本性的变化。
现在,我们走到世界各地,经常有人问我,人工智能究竟是什么?我的回答是:AI就是计算,计算就是AI。
无论是世界模型还是语言模型,都是如此。
坦率地说,我们正在看到许多不同模型之间的融合,包括单模态模型和多模态模型。正如Lisa刚才所说,这需要硬件和软件之间共同演进、协同设计。
因此,这是一个非常有意思的机会。
我还想谈谈在座的博士生、硕士生和本科生。
我认为,随着AI成为一种工具,科学研究本身的开展方式也正在发生变化。AI不仅是我们需要研究和解决的问题,也可以成为我们开展研究的工具。
我们正在进入一个非常令人兴奋的团队科学(Team Science)时代。
将四个实验室各自的优势与AMD的优势结合起来,通过团队科学的方式,为计算和人工智能的发展作出贡献,这对我们所有人来说都非常令人兴奋。
Peter Stone:你们刚才谈到了AI和计算之间密不可分的关系,也谈到了机器人领域正在发生的变化。
接下来这个问题想请两位一起回答。我们看到,大语言模型以及其他基础模型正在机器人领域发挥作用,与此同时,视频生成模型也开始被应用于机器人领域。
你们认为,未来的机器人将由什么技术驱动?我们是否仍然需要分别开发不同层级的模块?还是说,基础模型最终能够通过端到端的方式解决机器人问题?
它们能否独立完成所有事情,真正解决机器人领域的问题?
李飞飞:我先回答吧。我们还是要保持理性和诚实。
前沿实验室最近公布的研究成果,以及本次会议上展示的一些成果,都确实令人惊叹。
我们正处于一个非常早期的阶段,同时也正在看到一个明显的转折点。因此,还有大量问题需要继续探索。
我认为,由视觉语言模型(VLM)或大语言模型(LLM)驱动的机器人,将发挥越来越重要的作用。
但我不认为我们已经完全解决了系统层面的问题。
在机器人和物理AI领域,仍然存在很多问题,我们还不清楚是否已经找到了从根本上解决它们的方法。
所以,未来我们还会继续看到各种变化。
明年的CoRL会议将会非常不同。过去两周,我们一直在评审Behavior Challenge的比赛结果。看到技术进步的速度,真的令人难以置信。
我认为,这种变化还远没有结束。
作为一名研究人员,我个人一直保持着高度警觉。因为我有时会感到有些紧张:我们究竟应该押注哪些研究方向?
但与此同时,这又令人无比兴奋。因为现在,我们已经从多个不同方向看到了新的信号,也有机会将这些潜在的方法结合起来。
苏姿丰:我想补充一点。在很多垂直应用领域,我们看到的情况是,不存在一个模型或者一个唯一的发展方向,能够解决所有问题。
面对现实中的各种应用场景,我们实际上需要覆盖非常广泛的用例,并使用不同类型的模型。
飞飞,我认同你刚才的观点。在某些场景中,我们所说的前沿大语言模型会表现得非常出色。但我也可以想象,在另一些场景中,更加专用的模型会更具优势。
3、机器人将大规模推动各种形态的计算需求增长
Peter Stone:Lisa,机器人已经成为推动芯片、计算资源和Token需求增长的重要因素之一。
今天在座的有很多学生和学术研究人员,他们都非常希望能够获得更多计算资源。正如飞飞刚才所说,这些资源非常重要。
那么,AMD如何看待机器人领域未来对芯片和计算资源的需求?
训练模型需要巨大的计算资源。当然,一旦机器人真正部署到现实环境中,它还需要实时完成感知、推理和行动,而且往往受到严格的功耗限制。
这是否意味着,机器人本质上是一个系统工程问题?
对于这些工作负载,AMD如何考虑将计算、内存、软件以及系统中的其他部分放在一起进行设计?
苏姿丰:我最想说的是,在座各位有没有人需要计算资源?
我们现在所处的时代,计算是基础,而且在很多方面,计算确实与智能直接相关。
如果回顾我们目前所处的发展阶段,我可以说,我们需要各种不同类型的计算能力。这也是我对整个计算生态系统感到非常兴奋的原因。
我已经在计算领域工作了30年。相比在座的各位,这让我显得有些年纪大了。
但事实是,现在从来没有过比这更好的时期,也从来没有过比现在更重要的时期。
我们在每一个层面都需要计算能力。我们需要云端计算资源,用来训练这些规模庞大的模型。
我们也需要企业内部的计算资源,需要边缘环境中的计算能力。随着机器人变得越来越重要,这些资源也会变得非常关键。
此外,我们还需要计算能力进入现实物理环境。
我的看法是,我们需要不同规模、不同形态的计算能力,但它们都需要遵循一些基本原则。
如果模型有不同的规模,那么我们的计算能力也需要有不同的规模。
从根本上来说,这是一个解决方案问题。
我们需要将硬件、软件和系统放在一起进行协同优化,让它们尽可能高效地解决具体问题。
李飞飞:我还想补充一点。今天我们是在机器人会议上讨论这个问题,我并不是因为身处CoRL才这样说,我是真心认为:机器人将推动计算能力进入下一个发展阶段。
我很喜欢这个判断,这是一件好事。
如果回顾机器人的发展历程,就会发现,过去它的发展缺少大语言模型所带来的推动力,因为机器人本身就是一个非常困难的问题,而且它还需要与物理世界发生交互。
但我们现在看到的这个转折点是真实存在的。
我无法准确预测未来的发展斜率,但可以肯定的是,我们已经进入了一个上升趋势。
机器人将大规模推动各种形态的计算需求增长,不仅包括训练端,也包括边缘端。
Peter Stone:飞飞,你从多个不同角度经历过这个问题。
你曾经是一名教授,也一直在为学术界争取资源;你创办过一家获得融资的初创公司;很快,你还将担任AMD的首席科学家。
我们刚才已经谈到,前沿研究面临的一个挑战,就是研究人员很难获得所需的计算资源。
你认为,要让更先进的机器人研发对研究人员、初创公司和学生更加开放,需要做些什么?
像AMD这样的企业又能发挥什么作用?
李飞飞:这个问题,我还是交给Lisa来回答。
不过,Peter,你和我一直是同事,也是合作伙伴。我们过去一直在推动公共部门获得计算资源。
早在2019年,我们中的一些人就推动过一项法案,也就是《国家人工智能研究资源法案》(National AI Research Resource Bill,NAIRR)。
我想说的是,在AI历史上最重要的时刻之一,如果我们没有为公共部门提供足够的资源,这将是一个巨大的失误。
换句话说,我们必须为公共部门提供资源。
公共部门包括大学里的研究人员,也包括非营利组织,因为这里是创新的第一阶段。
这个国家的创新引擎始于公共部门的基础研究,始于那些开放式的、由好奇心驱动的研究。
与此同时,我们还在培养下一代发明者和未来的劳动力。
但现在,AI领域的公共部门正面临严重的资源短缺。我认为,我们必须解决这个问题,因为我们需要投资未来。
此外,我们现在也越来越需要负责任的AI,无论是安全还是安保问题,都需要得到重视。
公共部门必须在其中发挥关键作用。
我们需要公共部门帮助理解和评估AI正在做什么,开展基准测试,并向公众提供信息,同时为政府提供建议,让大家了解这些AI模型好的一面、不好的一面,以及存在的问题。
因此,公共部门发挥着至关重要的作用。
Peter Stone:我完全赞同你的观点,那么AMD可以发挥什么作用?你们能够怎样帮助实现这一目标?
苏姿丰:我想,一个很好的办法是,大家应该去问问AMD的首席科学家,究竟应该怎么做。
首先,我百分之百赞同飞飞刚才所说的一切。
对我们来说,机会在于,我们正在建设规模非常庞大的计算能力,达到数千兆瓦级别。
坦率地说,我们确实处于需求远远超过供应的阶段。
但是,将其中一部分资源专门用于长期研究,提供给大学,确保下一代创新者能够获得计算资源,这绝对是我们作为行业领导者应该承担的责任。
我们非常希望能够花时间与这个社区交流,并确保这件事真正发生。
我刚才并不是完全在开玩笑。
我之所以如此期待飞飞加入AMD并担任首席科学家,是有原因的。
我认为,AI已经取得了非常大的进展。我们一路走来,已经看到了AI的发展,以及大语言模型所带来的变化。
但这一切仍然处于非常早期的阶段。
现在,我们需要思考的是:如何确保这些技术真正让世界变得更好?
机器人就是其中一个重要领域。
我认为,我们已经非常接近目标,但还没有真正展示出机器人能够带来的实际价值。
我希望AMD能够参与其中。当然,我相信行业里的其他企业也有同样的动力,共同帮助我们将这一愿景变成现实。
4、AMD是否会建立机器人研究团队?
Peter Stone:接下来,我想转到Slido上的问题。
这里有几个得分非常高的问题,而且它们的排名一直在变化。我现在先选排名最高的一个。
大家对这个问题非常感兴趣:AMD会不会建立一个机器人团队?
苏姿丰:你们这是默认我们现在还没有机器人团队。
事实上,我们已经有了一支规模相当不错的物理AI和机器人研究团队,只不过目前还处于非常早期的阶段。
如果大家从计算技术栈的角度来看,就会发现,机器人所需要的很多组件,我们其实已经具备了。
例如,我们拥有嵌入式FPGA、处理器以及AI引擎。这些组件已经能够控制很多机器人,尤其是大家在工业环境中看到的那些机器人。
但如果要进一步进入大家正在研究的机器人领域,我认为我们还处于非常早期的阶段。
我非常希望飞飞在加入AMD之后,能够将大量精力投入机器人研究,同时加强我们与整个生态系统之间的联系。
因为我一直坚信,没有任何一家公司能够独自完成整个技术栈中的所有工作。
归根结底,这也是为什么如今初创公司能够发挥如此重要的作用。
我们有工业实验室,有大学,还有大型企业。
我们真正需要的是将这些不同领域的优势结合起来。
在这样的发展环境中,建立开放的生态系统,提供能力强大的硬件,让不同层级的软件能够相互协作,并让不同实验室分别开展各自的研究,这些都是我认为能够加速机器人发展速度和进程的重要方式。
我们也需要将机器人真正带入制造业和工业化应用。
5、无论AI发展得多么先进,人类智能依然非常宝贵
Peter Stone:我想,在座有很多人正处于职业生涯的起点,他们正在认真思考,自己作为博士生应该研究哪些最重要、最有意思的问题。
反过来说,有没有一些研究方向是你们不建议大家选择的,不适合作为博士论文的研究主题?
我想同时听听这两个方面的看法。
哪些领域非常值得作为博士研究或本科研究的主题?哪些方向应该谨慎选择?
此外,在这次会议上,很多人也问过我一个问题,我想大家可能也很感兴趣:未来几年,博士学位究竟意味着什么?攻读博士学位是否仍然是进入研究领域的正确道路?
我想,飞飞,你给出的答案可能不是所有人都喜欢听到的,但我还是想把这个问题交给你。
李飞飞:首先,我认为这是一个正在发生巨大变化的时代。
说实话,站在台上的我们三个人,可能都有些羡慕在座的各位,因为你们还很年轻,而且恰好出生在AI革命的时代。
而我们是在成年之后才进入这个时代的。
关于是否应该攻读博士学位,以及博士期间应该做什么,我自己的答案也在发生变化。我想坦率地告诉大家我的看法。
我不认为博士学位适合所有人。
尤其是在AI时代,学习工具和软件工程已经发生了如此巨大的变化。
现在,人们可以通过更多不同的路径成为研究人员、成为创新者,并产生实际影响。
这并不意味着博士学位不再有价值。
我认为它依然非常好。我自己很喜欢读博士的经历,我相信Peter和Lisa也很喜欢。
但现在已经出现了更多不同的道路,你们需要主动去寻找适合自己的方向。
那么,博士学位究竟意味着什么?
我依然坚信,博士学位的核心在于好奇心。
这是你人生黄金时期中一段受到充分保护的时间。在这段时间里,你可以追求那些最具挑战性、最能激发好奇心、最有意思,并且有望产生重要影响的问题。
我始终相信,无论AI发展得多么先进,人类智能依然非常宝贵。
它可能甚至正在变得更加稀缺,但它依然珍贵。
现在,我们有大量Token在与人类的大脑活动竞争。
但我认为,我们正在建设的文明仍然需要人类智能,也需要人类大胆的好奇心。
因此,对于那些内心拥有强烈渴望和好奇心的人,我确实认为,博士学位仍然是一条非常好的道路。
但你必须拥有这样的信念,并且无所畏惧地去追求那些重要的问题。
苏姿丰:我想从自己的经历谈谈。
当年我读博士的时候,其实并没有真正想过自己一定要获得博士学位。
我的父母当时对我说:“来吧,你还太年轻了,接下来准备做什么?还是继续留在学校吧。”
结果,那真的是我人生中最美好的四年。
原因正如飞飞刚才所说。
重要的并不是你具体研究哪个问题,因为具体问题会发生变化。
今天我们研究的具体问题,变化速度非常快。
但读博士真正重要的是,你有机会成为所在领域最优秀的人之一,或者成为这个领域中最优秀的研究人员之一,因为你拥有探索的机会。
所以,出于这个原因,我认为读博士是一件非常美好的事情。
如果你有机会,我会鼓励你去尝试。
因为人生很长,没有人能够拿走你的博士学位。
而且,你会始终拥有那段经历和知识:你曾经选择一个问题,并将它研究到所在领域的前沿。
至于Peter刚才问到的,大家应该研究什么,我还有一个非常强烈的看法。
现在,整个行业都在讨论通用人工智能(AGI),以及我们距离AGI究竟还有多远。
有时候,我会听到一些同行和行业人士说,我们已经非常接近AGI了,似乎马上就能实现。
但我实际上并不认同这种说法。
我不认为我们已经如此接近AGI。
回顾人工智能取得的巨大进步,我们确实已经实现了很多令人难以置信的成果。
但AI的表现,很大程度上仍然取决于我们让它解决什么问题,以及我们如何引导它。
因此,当你把AI看作一种工具时,你当然希望能够使用最好的工具。
但归根结底,你仍然需要发挥自己的专业知识和直觉。
我经常说,在招聘人才时,你能够分辨出哪些人真正对自己的领域拥有直觉,哪些人只是所谓的书本知识丰富。
在现在这个时代,也可以说是AI知识丰富。
你需要找到自己真正感兴趣的问题,并在这个领域培养自己的直觉。
这样一来,无论工具如何变化,都不会影响你继续推动所在领域的发展。
因为你已经拥有了这个领域的专业直觉。
这也是在工业界比较难做到的一件事。
因为工业界缺乏耐心。
我们所有人都缺乏耐心。我们希望产品尽快推出,希望下一个模型尽快发布。
而这恰恰是大学环境与工业界之间的区别。
Peter Stone:飞飞,你刚才提到,人类智能依然非常特殊,也非常重要。
目前AI模型的训练方式,与我们已经知道的可能实现方式之间,仍然存在一些差距。
我经常给出的一个研究方向是:如何在保持相同性能的情况下,使用更少的资源和更少的能量。
我认为,这是一个非常重要的研究方向。
当然,这可能与销售更多芯片的商业目标存在一定冲突。
我想听听你们两位怎么看待这个问题。你们是否认为,降低能耗、提高效率应该成为当代学生的重要研究方向?
苏姿丰:当然。这绝对是一个非常重要的方向。
这又回到了我们刚才讨论的问题:计算没有一种适用于所有场景的统一方案。
物理世界也不是只有一种固定的规模,而是存在各种不同的规模。
我认为,这也是为什么我们仍然处于非常早期的阶段。
你说得没错,现在我们拥有大型数据中心,也有各种规模定律(Scaling Laws)。
但归根结底,我们需要让计算能力出现在所有地方。
因此,更低的功耗、更高的效率、更长的使用寿命以及更低的延迟,所有这些指标都需要得到优化。
此外,我认为我们还需要注意一点:不要将人类大脑的20瓦功耗,与训练AI模型所需要的巨大能量简单地混为一谈。
李飞飞:进化本身也是非常昂贵的。
没错,人类大脑的确非常高效,但它是数十亿年进化的结果。我现在还不知道,应该如何计算整个动物界在漫长进化过程中累计消耗的能量。
因此,我们不应该将这两个因素混为一谈。
此外,我始终坚信,脑科学本身是一门独立的科学。无论是理解大脑、记录和复制大脑,还是帮助解决脑部疾病,这些都是脑科学需要研究的问题。
但与此同时,AI本身也是一门独立的科学。AI并不一定只是为了复制人类大脑。
因为我们试图解决的计算问题,已经超出了人类能力的某些范围。例如,编写代码、生成模拟环境,以及为机器人提供计算能力。
因此,脑科学与AI科学是两个相互正交的研究问题。
Peter Stone:Slido上还有一个问题,考虑到你们目前正处于宣布合作后的蜜月期,有人问:你们之间是否有不同意见?有没有什么事情,是你们不同意对方看法的?
李飞飞:认真来说,我们有没有什么意见不一致的地方?
我不知道。大家也看到了,我们还没有发现这一点。我们还没有发生过这样的情况。
如果你们以后再邀请我们回来,就可以再问一次。
6、在变化的时代,寻找不变的价值
Peter Stone:从刚才大家提出的问题可以看出,现在的学生面对AI,既感到焦虑,也感到兴奋。
如果结合你们自己的经历,假设现在你们正处于在座这些学生的位置,你们会如何看待当下这个时代?
最后,你们有什么建议想送给在座的每一位?现在对于很多学生来说,确实是一个充满动荡的时期,因为整个时代都在发生变化。
李飞飞:你们自己的生活正在经历变化,因为你们正处于学生阶段,而你们所在的领域也正在发生变化。
从整个人类文明的角度来看,我们也正处于一个非常特殊的时刻,因为我们正在经历一项具有文明变革意义的技术。
我实际上想邀请所有学生,在一个不断变化的时代里,去寻找那些永恒不变的价值。
正如Lisa刚才所说,人生很长。很多事情都会发生变化。研究问题会变化,挑战会变化,机会也会变化。
但如何过上自己真正希望拥有的生活,很大程度上取决于那些不随变化而改变的东西,也就是那些永恒的价值。
对我个人而言,这段经历让我认识到,永恒的价值包括好奇心、正直,以及无所畏惧地追求真理、探索真理的勇气,同时还要敢于在思想上大胆探索,并保持诚实。
苏姿丰:我想,我会鼓励大家保持远大的志向,并且真正乐观地看待未来。
因为你们正处于一个最好的时代。你们拥有非常出色的工具,面前也有大量机会。
很多人会向我寻求建议,询问职业发展方面的问题,例如应该做什么、应该选择什么方向。
我通常会告诉他们一段我年轻时得到的建议。
当时,我还是IBM的一名年轻工程师,刚刚工作了大约两年。
有一天,有人问我:“Lisa,你长大以后想成为什么样的人?”
当时,IBM有一个职位叫作IBM Fellow,这是一个专注于深度研究的职位;还有一个职位是IBM副总裁。
我当时实际上想的是,我可能没有足够的聪明才智成为IBM Fellow,但也许有机会成为IBM副总裁。
于是,我决定朝着这个方向努力。
当时,有人给了我一条建议:永远朝着最困难的问题前进。
那时候,我其实并没有真正理解这句话的含义。但这条建议一直伴随了我很多年。现在,我也会把这句话告诉其他人。
因为归根结底,作为工程师、科学家和研究人员,我们的工作就是解决问题。
我们要解决非常有意思的问题、非常重要的问题,以及令人兴奋的问题。
我们能够从解决这些问题的过程中获得快乐,也能够从中取得成功,并通过这些工作推动世界向前发展。
因此,如果你准备投入一项工作,就去解决那些最困难的问题,并且要相信自己能够产生巨大的影响。
我认为,这也是为什么当下这个时代如此有意思。
你们现在拥有的工具,已经能够帮助解决那些最有意思的问题,其中有些问题甚至几十年来都没有得到解决。
这是一件多么有趣的事情!
所以,我想说,现在对于开始职业生涯的学生来说,是一个非常了不起的时代。我也希望大家未来能够考虑加入AMD。
李飞飞:顺便说一句,她将担任我们的招聘经理。