豆包工作接入Kimi、GLM、DeepSeek:模型额度倍率同步公开
国产大模型开始组团办公
企业客户先一步用上第三方模型之后, 豆包工作又把可选范围铺到了更多用户面前。平台今日正式宣布,Kimi 3.1 Pro、GLM 5.3、DeepSeek V4.1 Flash 等多款第三方模型已接入,限时优惠活动也一并上线。用户做不同任务时,可以自行挑选对应的模型来干活。
大模型进入实际办公场景的越来越多,编程、文档写作、数据分析这些活儿,对模型能力、响应速度、使用成本的要求本来就不一样。
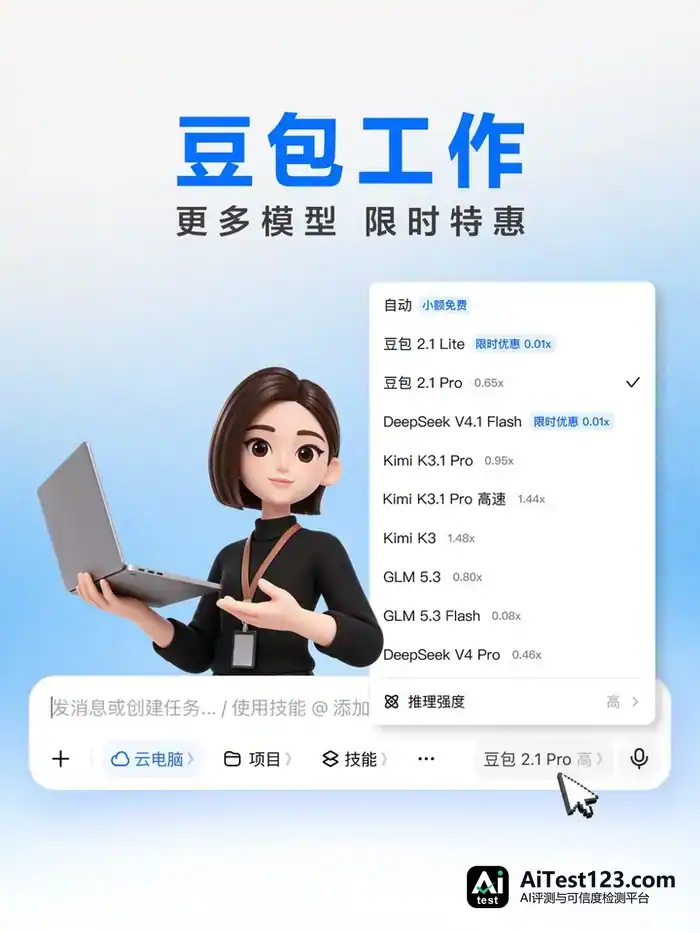
这次更新让平台内的模型选择更丰富,用户在同一款工作平台上就能调用不同厂商的 AI 模型,不必来回切换工具。另外,豆包工作还改了模型额度消耗的展示方式。
其实此前豆包工作就已向企业客户开放第三方模型。这一回,模型选择页面上进一步标出了各款模型的额度消耗倍率,用户能直观看到不同模型的使用成本。官方说明称,倍率越低,通常代表该模型的调用成本越低;任务复杂程度、模型能力、额度消耗情况,用户可结合起来挑合适的模型。
价格上,豆包工作还推出了全新的限时优惠计划。工作日及节假日的指定优惠时段内,用户使用参与活动的模型,能额外享受额度消耗优惠。
豆包 2.1 Lite 和  DeepSeek V4.1 Flash 的额度消耗倍率也已下调。同样一项任务,这两款模型要消耗的额度会进一步减少,现有额度能完成更多任务。
开放第三方模型、标注额度消耗倍率、用限时优惠压低成本,豆包工作正试着把模型选择做成办公产品里的常规功能。
同一款产品里能调用的 AI 模型越来越多,单看某一款模型的能力就不够了。平台能给出多少种选择,用户又能否以合理成本用上这些能力,同样会影响使用体验。
本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。