豆包工作接入 DeepSeek V4.1 Flash、Kimi K3.1 Pro 等第三方模型,同步上线额度消耗倍率与限时优惠
IT之家 11 月 12 日消息,豆包官方今日宣布,豆包工作完成了一次产品更新,拓展更多可调用的模型,并同步引入了一套按实际消耗计价的额度调节机制。 此前,豆包工作在模型侧仅提供豆包 2.1 Lite 与豆包 2.1 Pro 两款自研模型。此次更新后,Kimi K3.1 Pro、GLM 5.3、DeepSeek V4.
11 月 12 日, 豆包官方宣布豆包工作完成产品更新:可调用的模型范围扩大,同时上线一套按实际消耗计价的额度调节机制。
过去,豆包工作在模型侧只提供豆包 2.1 Lite 和豆包 2.1 Pro 两款自研模型。这次更新后,Kimi K3.1 Pro、GLM 5.3、 DeepSeek V4.1 Flash 成为首批进入可选列表的第三方模型,用户可按任务需要在自研与三方模型之间自行切换。其实早在 10 月 29 日,豆包工作就向团队订阅版和企业订阅版客户开放了三方模型配置,企业不用另找模型厂商采购或额外申请,用量直接从已有 AI 点数里扣。11 月 12 日的更新把这项能力推到更大用户范围,并给所有用户配上了限时优惠计划。
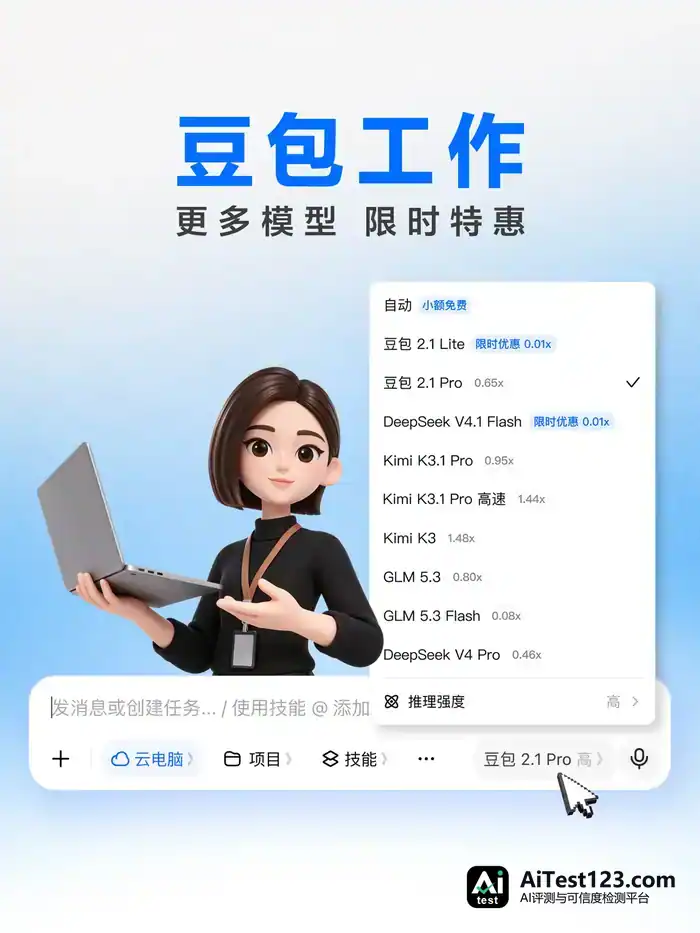
模型一多,成本差异就绕不开。同一个任务,不同模型烧掉的资源并不一样。豆包工作的办法是在模型选择页面直接标出每款模型的额度消耗倍率——系数越低,干完同一件事扣的额度越少。这个倍率可以理解成不同模型完成同一任务时的“计价系数”:任务本身的复杂度不变,变的是账户里的可用额度被吃掉的速度,用户由此能在效果、速度和成本之间做看得见的取舍。说白了,哪款模型“更划算”不用再凭感觉猜,判断依据直接摆在了操作界面上。
限时优惠分两块。一块是工作日和节假日的指定优惠时段内,用参与活动的模型能拿到额度消耗折扣;另一块是豆包 2.1 Lite 与 DeepSeek V4.1 Flash 的额度消耗倍率被直接下调,这两款本就偏高频轻量任务,倍率降下来后同样任务扣得更少,额度更经用。
小额简单任务依旧免费。官方图里,模型选择列表第一项是“自动(小额免费)”,系统按任务规模自动匹配模型;任务变复杂时,用户可以手动切到豆包 2.1 Pro 或第三方模型,按对应倍率计费。