清华曹婷谈具身智能:数采工厂冷下来了,自进化才是出路
这三个问题不解决,数据终究会成为具身最大卡点,一位前微软亚研科学家的“提前量”。
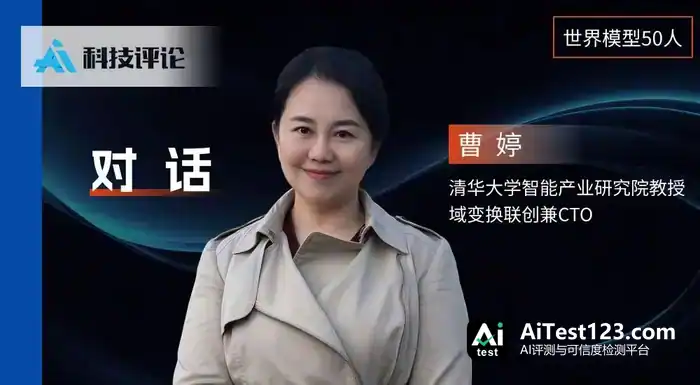
 微软亚洲研究院的科学家,早就把答案押在了前面。
曹婷 2009 年去澳洲攻读博士,导师是编程语言与系统领域两位顶尖学者,研究方向是非对称多核处理器与 Java 这类托管语言在功耗和性能上的取舍。读博期间的论文入选 CACM 研究亮点,图灵奖得主大卫·帕特森还专门写文章推荐,并将其收进自己的经典教材《计算机体系结构:量化研究方法》。
其中一篇发在 ISCA 的论文 The Yin and Yang of Power and Performance for Asymmetric Hardware and Managed Software 讲得颇有诗意:虚拟机垃圾回收、即时编译带来的额外开销,正好属于可以甩给小核去跑的差异负载,以小核之“阳”补虚拟机开销之“阴”;而换个方向看,托管语言的抽象又把非对称硬件那些复杂之处消化掉了。
在我们看来,这段经历给曹婷的学术生涯埋下了一样东西:一种阴阳式的直觉——约束从来不只是限制,它也可能成为逼出系统生机的起点。
博士读完,曹婷进了华为编译器与编程语言实验室,管方舟编译器的内存管理,目标是在内存有限的前提下让程序跑得更快、更省。2018 年她转投微软亚洲研究院(MSRA)异构计算组,一待七年,做的是端侧 AI 推理,把几十亿参数的神经网络塞进手机、PC 和 IoT 设备,让它们脱离云端,在本地的算力、功耗和存储条件下运转。低比特量化、LUT 查表推理、存算一体加速器,这些技术后来进了微软 Office、Windows、Bing,服务百万级用户。
2025 年夏天,曹婷加入清华 AIR。这一回摆在面前的约束更凶险:训练数据极度匮乏,物理环境又千变万化。她很快注意到,机器人在固定设置下能把动作做对,环境一变就失败,而失败里那些宝贵信息,传统系统往往随手就丢了。具身智能 Demo 已经能做了,真正部署却始终落不了地。
曹婷给出的答案仍是“阴阳”:约束既然穷举不完,那就把它变成养分。当年 10 月,她与 MSRA 时期的老搭档、清华 AIR 副院长刘云新教授一起发起域变换(Z-Trans),押注具身自进化,随后陆续发布 Z0、Zeva、Zeva Ego、Zetta、Z-infra 等工作。
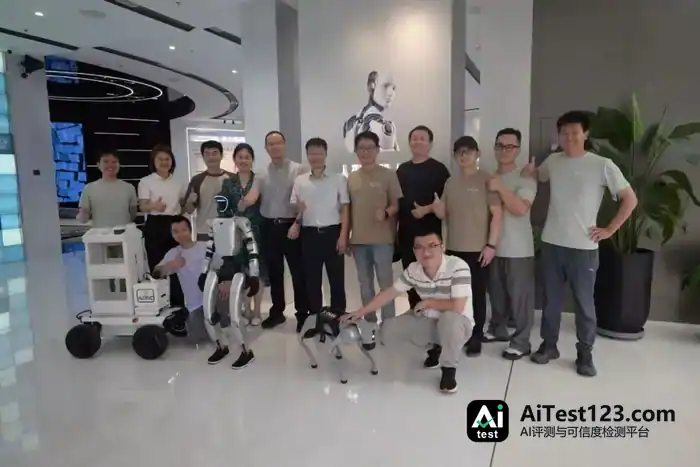
让软件在异构硬件上省功耗,让模型在边缘设备上省算力,再让智能在物理世界里学会自进化——曹婷这十几年做的其实是同一件事:条件不充分的时候,也要让智能好好工作。
以下是AI科技评论与曹婷的对话,在不改变原意的基础上有所编辑。
01
机器人工厂为何慢慢冷下来
“整体的技术范式没有收敛,而且变化特别快,基本每个月都不一样,但一个离线、一个在线这套学习范式,应该是大家统一认可的。”
▎AI科技评论:上半年,全行业都在抢着盖机器人数采工厂,想靠堆数据硬砸出效果。可到了下半年,具身上下文学习的工作一个接一个冒出来。这是前面的研究已经证明了什么吗?
曹婷:我自己的感受特别明显。5 月份以前,大家还认“离线训一个模型,它在线就能干活”这个理,现在再看,这些数采工厂差不多都凉了。
大家发现,离线数据采得再多,机器人在线依然干不成活,因为离线数据永远涵盖不到真实世界的全部情况。
看到之前的路走不通,大家才开始思考怎样让机器人不只依赖离线训练,还能在部署后利用新的示范和反馈进行在线的上下文学习。
▎AI科技评论:大家在技术上达成共识了吗?
曹婷:整体上学习范式分两种:一种 offline,一种 online。
上下文学习这个概念,最早是从大语言模型(LLM)那边来的,GPT 证明了给上下文示例就能泛化。落到具身这边,大家也想在上下文阶段给机器人演示一遍,它就能泛化到各种情形。眼下整体技术范式还没收敛,变起来还特别快,基本每个月都换一拨,但离线、在线这套学习范式,应该是大家都认的。
▎AI科技评论:大语言模型的 ICL 是靠涌现出来的,给几个文本例子它就学会了。具身的 ICL 有什么不一样?能不能帮大家梳理一下,目前具身 ICL 的工作都有哪些路线?
曹婷:具身领域的 ICL 远比语言模型复杂,目前行业里有三条不同的路线。
第一种期待是像 LLM 那样,能力自己就涌现出来。Generalist 就说他们的能力是涌现出来的:训练时看过大量人类视频、大量 ego 数据,之后给一段视频,它就能自己去干活。不过我觉得这条路比较难走,背后恐怕有不少限制条件。
第二种是显式训练,类似Skild,给它一段视频,让它去预测下一条 action。这不是模型自己涌现的,而是训练时就这么训的。就跟之前的 VLA 一样,之前是 language 做 prompt、action 做输出,现在是 video 做 prompt、action 做输出。
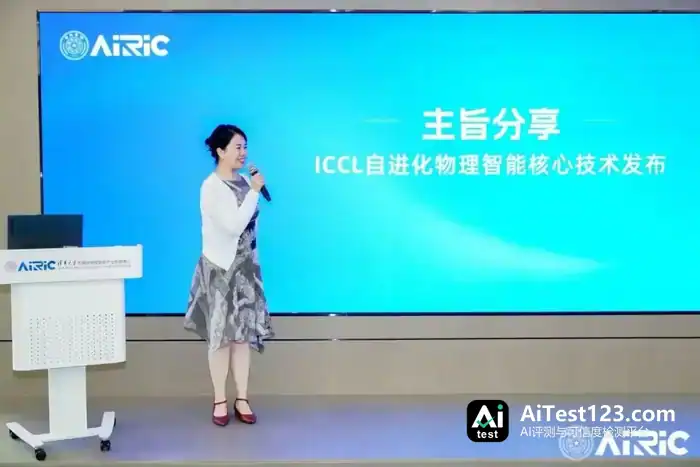
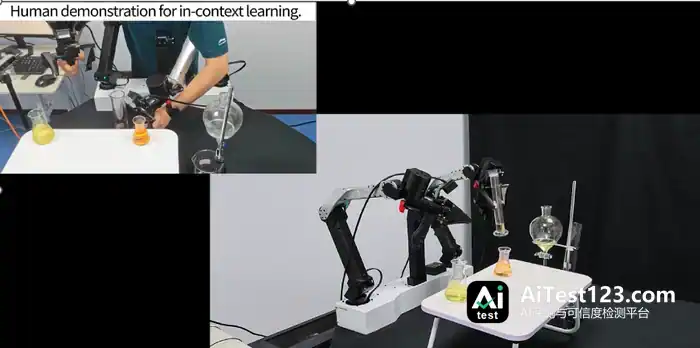
我们走的是第三条路,叫 ICCL(in-context causal learning,上下文因果学习)。直接把 video 交给模型去生成 action,我们觉得太难了——视频里可能有走动的人、有无关物体、有反光,要从这堆噪声里提炼出有效动作信息,并不容易。
▎AI科技评论:你们是把这些噪声全部丢掉吗?
曹婷:是的。我们增加了一个动作-效果提取模块,把无关视觉变化带来的干扰压下去,上下文里只保留动作以及它产生的效果。从我们自己的观察看,眼下这个方法的泛化性比其他模型都好,背景特别复杂时尤其明显。
▎AI科技评论:假如ICL这条路真能跑通,后训练的工作是不是就没太大意义了?
曹婷:得拆成两件事说。泛化能力极强是ICL的长处,碰上没见过的任务,人示范一遍它就明白怎么干,家庭场景对泛化性要求很高,这类场景它更合适。
可到了工厂生产线上,工厂在乎的是精度和延迟,客户要求99%甚至更高的精度,目前ICL还远达不到这个水平。比如Skild的报告显示,在未见过的任务里,ICL步骤成功率也就60%多。所以在变化没那么频繁的柔性工业生产场景,稍微采几百条数据做后训练,依然是保证精度最经济、最可靠的方法。
家庭靠ICL泛化,工厂靠后训练求稳,这是完全不同的两条逻辑。
02
何谓因果
“模型是data-driven的,是从大量数据里学会规律,涌现出能力。”
▎AI科技评论:前面提到你们路线里有一个提取动作和效果的技术,这是你们的技术核心吗?
曹婷:对的。我们最开始做的是Zeva,当时基于Cosmos。但我们的技术其实不挑基模,World Model、VLA都能用。后面又发了Zeva-Ego,就是基于VLA用Ego数据做的中训练。
这两个工作一脉相承:Zeva强调上下文因果学习,它有一个动作提取器,可以在线地提炼出动作和效果,加到上下文里;Zeva Ego从ego数据里提炼动作和效果,去做中训练,让泛化性有显著提升。
最本质的都是因果提取器,这是我们的核心技术。
▎AI科技评论:Zeva-Ego用到的数据,是你们自己采的吗?
曹婷:用的是开源的数据,但我们要清洗,因为大部分不适合直接用于动作学习,最后大概只留十分之一。
因果提取器的训练分两步走。第一步,重点是学动作之外环境发生了什么变化,有个专门的网络把跟动作无关的部分挑出来。第二步,用第一步得到的环境表征,让因果提取器只去抓和动作有关的信息。训完之后,再喂给它那些没有动作标注的ego数据,把动作因果提取出来,供后面的中训练用。
▎AI科技评论:直接用无标注数据,那可免去不少标注的工作,能更高效地使用数据。
曹婷:是的,我们用了10K小时没有标注的ego数据,通过我们的编码器转化为动作相关的监督信号来训练模型。
▎AI科技评论:聊到因果,早前世界模型热起来那阵,不少人都宣称自己做的是因果世界模型。也有人提出疑问:眼下还没有过硬的证据能说明机器人真的学会了物理规律。这一点你们打算怎么向外界证明?
曹婷:这个领域里谈“因果”的很多。我们说的因果,就是action和effect——因是动作,果是它带来的效果,是很直接的因果关系。举个例子,机械臂用多大劲去推瓶子,瓶子最后挪了多远。
怎么判断它管用?先看公开评测集,Zeva的表现更好。落到实际效果上,背景乱糟糟的时候,跟业内其他模型比,我们这个学得更省劲,试的次数也更少。像拿咖啡杯,有的模型要试五六次才拿得起来,我们一般一两次就成了。
▎AI科技评论:“理解物理规律”这种说法,容易让人联想到按科学原理去理性地理解,可它实际上更像人类那种模糊的、靠经验的理解?
曹婷:对,模型是data-driven的,规律是从海量数据里学出来的,能力也随之涌现。你当然可以直接把重力原理讲给它听,但它非得自己去试不可。这跟小孩差不多,没学过物理,也说不出个所以然,可就是知道该怎么做,这些经验都是从大量尝试里攒出来的。
在我们看来,最合理的一条路是:做大量预训练,再加上大量在线学习,让机器人自己把规律摸透。我画过一张roadmap,机器人到最后会学成一个物理学家,能自己想出新的定律。
▎AI科技评论:AI for Science?
曹婷:对,未来会走到那一步。但现在它能把眼下这些事情干好,就挺不错了。
03
学习与记忆构成闭环
曹婷说,记忆和学习分不开:经验攒得够多,就能泛化到没做过的新任务,这就是学习。
AI科技评论:说到 ICL,长记忆和 RSI(recursive self-improvement,递归自进化)就绕不开,这三者之间是什么关系?
曹婷:记忆和学习的关系,我之前在 AIR 内部做过分享。记忆是分层的。
最短的一层是 working memory,也就是机器人做当前任务时的上下文。再往上是跨任务的长期记忆:一个任务做完,经验存下来成为长期记忆,下次碰上类似任务,就去检索历史经验,塞进当前上下文里帮着做决策。
记忆和学习分不开:经验记得足够多,能泛化去做没见过的新任务,这就是学习。
具身 RSI,也就是我们定义并打通的物理世界自进化(PSI,Physical Self-improvement),是更大的闭环。在线学习让机器人攒下成功和失败的数据,这些数据再拿去训模型本身,基模能力就上去了;基模强了,新任务做得更快,数据又能攒得更多。这个飞轮就是 PSI 的核心逻辑。
▎AI科技评论:现在还做不到不试就直接完成新任务,但长远看,人们肯定希望机器人一击即中。未来当前上下文这一块的工作,会不会让位给巩固长期记忆的工作?
曹婷:你说得很对。我们的数据现在全部回流,近期会发布一项新工作,把机器人自己尝试的数据训回模型,效果提升非常明显。人也是这样,试很多次之后,这些经验转成大脑皮层,成了长期记忆。
▎AI科技评论:GPT-6 出来以后,有人担心具身基模被“吃掉”,这个问题怎么看?
曹婷:GPT-6 能力很强,可它能理解任务、规划步骤、调用工具,不等于它自己就有可靠的物理执行能力。时延是个现实问题,尤其在需要快速响应的操作里,等模型返回结果,现场状态可能已经变了。
▎AI科技评论:延迟这个问题,有希望解决吗?
曹婷:只靠 GPT 自身优化就满足机器人实时控制的要求,不太现实。GPT 这类大模型一定奔着智能上限去,要的是 AGI,一个模型什么都能干,参数越来越大。做复杂任务它还要有思考过程,还要算上网络传输,这些开销都很难压下来。
▎AI科技评论:GPT 像一个综合图书馆,具身基模则是一个专业的小库。
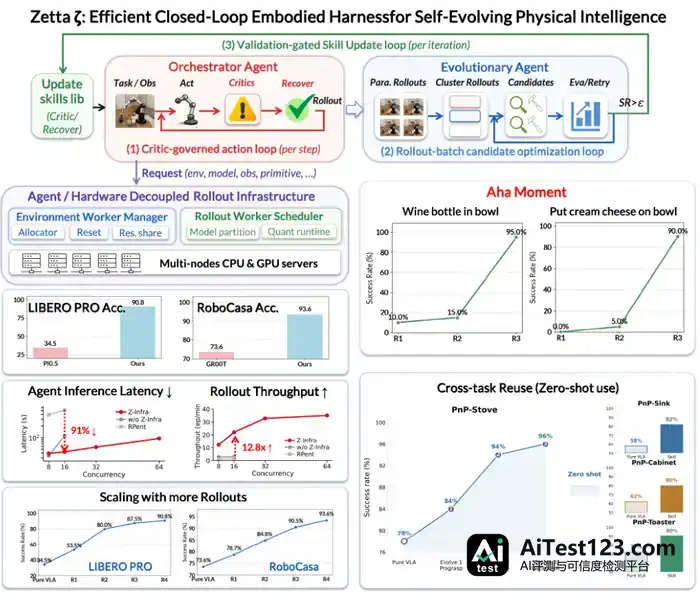
曹婷:对。我们很早就判断,World Model、VLA 这类中小脑,上面一定得有一个类似 GPT 的大脑,所以我们一直是 agent 加模型一起往前推,模型是 Zeva 和 Zeva Ego,agent(或者说 harness)是 Zetta。
具体做法是把具身的部分能力抽出来,训到一个小 VLM 模型上,可以理解成端侧的 GPT 模型。现在训到几十 B 参数,效果上基本没有区别。这个模型当大脑用,负责理解用户指令、拆解长程任务、监控执行、生成恢复动作,再调下层的工具和模型。

04
赋能产业是最终目标
曹婷说,(最近)投资市场有点冷,但实际的产业需求特别大。
▎AI科技评论:你是清华 AIR 教授,也是域变换的联创兼 CTO。院里这两年孵化出不少创业公司,在产业上有什么优势?
说到 AIR 的来历,曹婷提到这是张亚勤老师一手创办的。张亚勤早年在微软做到了全球副总裁,之后回国在百度当过总裁。院里的人大多有产业背景:她自己是去年从微软研究院过来的;周谷越老师是大疆早期核心成员之一,他创办的求之科技最近拿到了十几亿融资;它石智航的创立者陈亦伦老师,此前担任华为智驾 CTO。
研究院的全称是智能产业研究院。曹婷说,“产业”这两个字是张亚勤老师坚持要加上的,他的意思是必须赋能产业。院里的老师大多会去办创业公司,方向集中在两块:生物医药和具身智能。
▎AI科技评论:这是不是意味着,相比叉院或者自动化所,AIR 跟产业结合更近,对怎么落地也更有经验?
曹婷:叉院的创业公司也不少。AIR 相对突出的一点在于,张亚勤老师本人在产业界影响力很大,国内国际都是如此,这给院里从产业界拿资源帮了不少忙。
▎AI科技评论:除了之前提到的 11 月即将发布的工作,域变换近期还在做什么?
曹婷说,团队现在更看重产业化。模型从不会干到能干成,这条 pipeline 搭好之后,还得放到真实场景里去验证。
这几个月他们跑了不少工厂。投资市场有点冷,可产业端的实际需求特别大。需求多集中在流水线上的活,比如拧螺丝钉,还有化工厂这类有风险的行业,很需要用机器人替人进去,避免人待在那样的环境里。
家庭是具身的上限,也最能说明模型的泛化性,团队正在做一台能全屋操作的机器人。雄安研究院里已经把卧室、卫生间、客厅整个搭了进去,机器人可以在里面完成全屋任务。
▎AI科技评论:团队目前是以博士生为主力军吗?
曹婷:产业线上也有工程师,不过主力还是博士生,我们的博士生非常强。
这些人想法活跃,动手也快,有了点子很快就能落地。对外面的技术变化,他们盯得很紧,随时留意。大家会互相分享今天又出了什么新工作,觉得某个技术特别有潜力,立马就去试。
有一天,一位同学特别兴奋地跑来跟她说,只要调 GPT,就能让整个机械臂从什么都不会做到完成一个任务。曹婷回他,那必须得做这个自进化的闭环。后来团队做了 Zetta,一个月就做完了,现在才发布两个月,引用量已经非常大。
这个方向的影响力他们看在眼里,未来这可能是条正确的路。之后不少公司看了这项工作找上门,都觉得很奇怪——他们才刚意识到这个问题重要,我们论文已经发出去了。曹婷觉得,这还是同学们的功劳。
▎AI科技评论:现在有多少人?
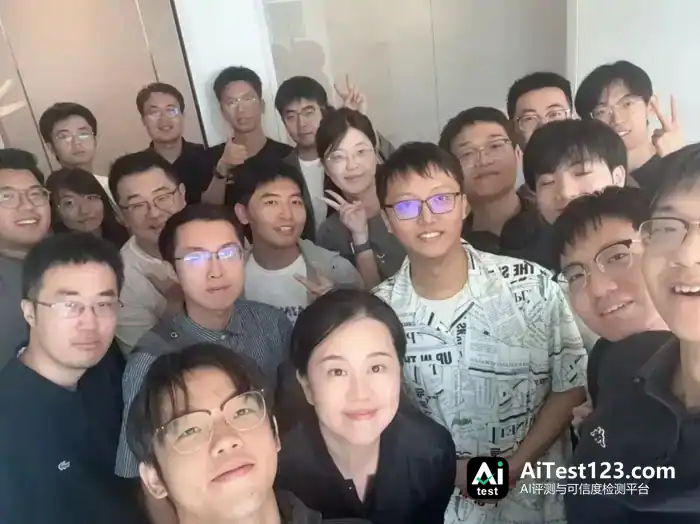
曹婷:差不多 20 人。只要他们觉得这事有意思、有分量,根本不用我催,自己就往前跑,热情很高。倒是我常问他们累不累、要不要歇一会儿。
05
写在最后
交流中曹婷曾有些得意地说:“当行业突然意识到具身自进化非常重要的时候,我们已经有连续不断的成果发出来了。”事实也确实如此,域变换近期发的几项工作,和行业的热点方向几乎逐一对应。
6月,Z0 打出“做持续自主进化的物理智能体”的口号,那会儿 RSI 还没成为显学,它率先从整体技术框架上考虑,把数据回流和模型自迭代的闭环内置其中。8 月 18 日,承担 Harness 功能的 Zetta ζ 发布;9 月 1 日,实现具身上下文学习的 Zeva 发出,和同样做 ICL 的 Skild、Generalist 等几乎同期;一个月内,Zeva-Ego 正式亮相,进入了关于 ego 数据价值的主流讨论。
清华 AIR 的定位从来不是传统高校实验室那种路子,一直走产学研一体。有院士资源撑腰,团队很早便与英伟达等机构搭上合作,把前沿技术放到更大的场景里去验证。曹婷则带来七年产业研究院的工程化直觉,还带来一种习惯——技术路线从一开始就按最终要部署来设计。出身顶尖院校的博士生们离学术前沿最近,科研热情高,吸收快,出手也快,不会被路径依赖拴住。
热点是阳面,热闹、喧嚣、人人可见;问题是阴面,冷清、难啃、人迹罕至。
跟雷峰网聊的时候,曹婷始终带着笑,没什么距离感。不工作时她爬山、跑步,整个人的状态很好。眼前这位温和优雅的人,很难让人想到是十几年来在暗处较劲的硬核研究者。能在阴处沉下心打磨,也敢在阳处亮出真章,这大概就是她好几次提前踩中热点的原因。