

李彦宏抛出智能组织命题:AI投入为何没换来增长
人工智能是新电能,智能组织就是AI时代的新厂房,是生产力真正发生的地方。
AI芯片、大模型、AI应用,这届百度世界大会都摆了出来,李彦宏偏偏挑了个“不性感”的话题来讲——智能组织。
过去两年,企业几乎都在干同一件事:把AI塞到员工手里。方案写得快了,报表出得也快了,可翻翻公司账本,增长就是不见影子。
员工越来越快,公司还是老样子。这个落差,成了全球企业绕不开的一道题。
11月12日,百度世界大会2026在北京国家会议中心二期开幕。百度创始人李彦宏在演讲里把原因说得很直白:“AI没有产生预期的经济效益,是因为我们只是更换了电机,却还没有重新设计工厂”。

跟模型、芯片、应用的发布比起来,这个话题显得太朴素了。岗位怎么分工,知识怎么共享,流程怎么调,听着像在上一堂管理学课。
可对百度以及所有AI企业来说,这是一个必须认认真真讲清楚的AI故事:砸下去的海量AI投入,换回来的到底是企业未来虚无缥缈的“鬼故事”,还是确定赢在AI时代的好故事。
百度是个典型样本。它一直在投芯片、云、模型和智能体,客户最后买到的不能只是一项新技术。AI进了公司以后,产品能不能交付得更快,服务能不能做得更好,成本能不能压下来,这些决定了企业还愿意继续掏多少钱。
智能组织就是李彦宏给当下AI行业开的方子:人工智能是新电能,智能组织就是AI时代的新厂房,生产力真正发生的地方就在这儿。
个人高效,组织低效
企业做AI转型,容易犯一种误判:让员工把AI用起来,Token消耗一再刷新纪录,就认定公司AI转型形势大好。可这些成果越是集中在个人和单个岗位上,越可能把流程没变这件事盖住。
真正难动的是部门之间的权责和利益,靠员工自发很难完成。局部试点成了,管理者要是就此停手,结果可能是每个人都被催得更忙、跑得更快,公司却没看出什么变化。
这也就解释了AI组织转型里的那道落差:个人提效和组织增效,从来就是两码事。
微软《2026年工作趋势指数年度报告》讲的是同一种现象,还给它起了个名字叫企业AI转型悖论——员工已经用AI提升个人效率,业务流程和评价机制却还停在过去,组织没怎么变。
BCG也发过一篇文章,标题就很直白:《为AI重新设计公司,而不是让AI适应公司》。研究里有一家欧洲能源企业,部署了大量AI试点却没拿到整体收益,后来转向重构端到端客户流程,才有了实质性改善。
落差的根子,藏在公司的出厂设置里:现代公司的组织形态,本来就是为清一色的人类员工队伍设计的。
世界上第一张组织结构图出自一家铁路公司。1855年,纽约与伊利铁路公司画出一张外形像树的图,分支上标着各职能部门和人员分工,职责划分加分级管理,撑起了工业时代的规模,韦伯后来把这套体系总结成科层制理论。它管住了规模,代价是僵化。
到了互联网时代,贝佐斯提出两块披萨团队——规模小到两块披萨能喂饱,决策权往下放,层级往低压。可不管层级怎么压,一百多年来组织的参与者始终只有一种:人。
AI把这个前提打破了。
组织里第一次冒出了没编制、照样能出活的成员。流程和岗位那套东西,原本是照着纯人类团队搭的,如今就像新电机响起来时旁边那间一直没动过的老厂房。个人效率是在旧流程的空当里往上走的,可空当里攒下的效率,并不会自己变成组织的生产力。
百度选在这个时候讨论智能组织,就是把问题推到了这一层:员工已经拿到了新的工作能力,公司打算怎么用这些能力?
百度的回答
AI芯片、大模型、智能体,花钱都买得到,智能组织能力却得企业自己长出来。著名科幻作家威廉·吉布森有句流传很广的名言,“未来已来,只是分布不均”,说的正是眼下。
同一个模型可以卖给同行业的不同公司,可它进了企业之后,能调用哪些数据、按什么规则作判断、结果由谁负责,各家条件并不一样。企业多年攒下的经验能不能被AI用起来,比采购时挑中哪款模型更吃长期经营。
讨论智能组织的意义,也就在这里。
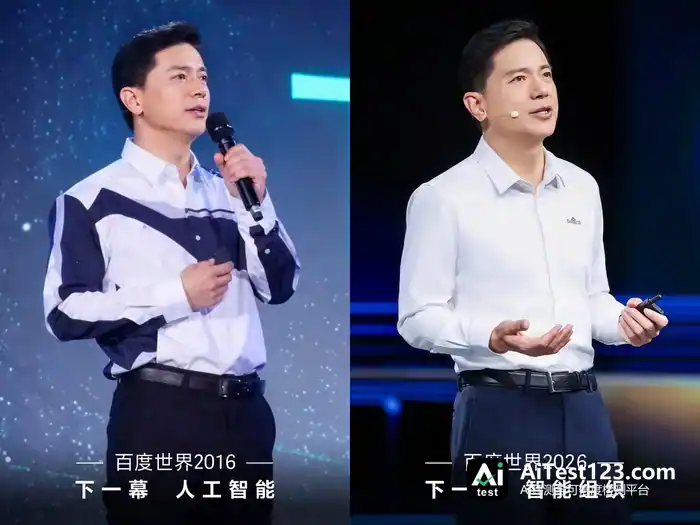
时间回到2016年的百度世界大会,那届主题是AI is the New Electricity,李彦宏当时就提出AI是新的电力,并判断移动互联网之后的下一幕是人工智能。
十年过去,AI早已成了共识。可企业眼下追问的是另一件事:投入不小,增长为什么没跟上。李彦宏给出的答案落在组织上——AI的上游是能源,下游是组织能力。

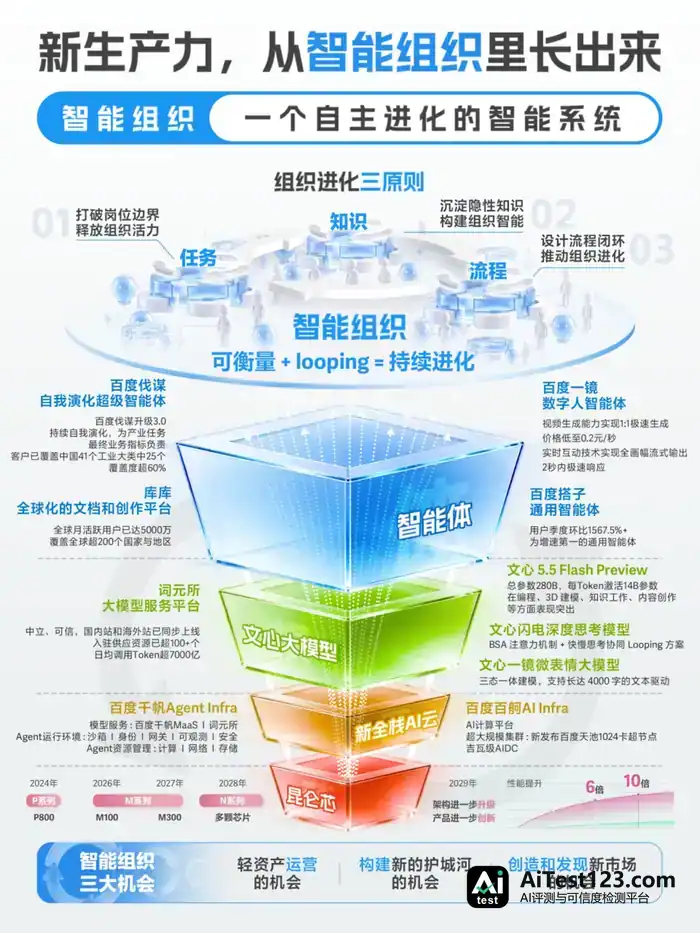
2026百度世界大会上,李彦宏把智能组织拆成三条原则:打破岗位边界,释放组织活力;沉淀隐性知识,构建组织智能;设计流程闭环,推动组织进化。说白了,这三条分别对应活怎么分、经验怎么存、结果怎么改。
先说分工。过去组织围着岗位转,AI时代要改成围着任务转,人怎么配,得看交付结果来定。专业岗位依然要把关,但哪些活必须交给专人,哪些能让业务人员带着智能体干完,不必照搬老一套划分。
再说知识。百度的说法是,组织智能要真正做到,就得把知识显性化,放到公司平台上,能不断累积、随时取用、谁都能用。
“沉淀隐性知识”针对的,大多是那些不好传的经验。把判断依据、处理过程、实际结果整理出来,智能体能调用,别的员工也能复用。企业攒下的应该是做成一件事的办法,光存历次文档不够。
最后一条,智能组织得是能自主进化的智能系统。怎么进化?李彦宏给了个公式——可衡量+Looping=持续进化。
任务干完要验结果,按反馈改方法,再投到下一次。这里面最难的,通常是定清楚什么算干得好。
按他的设想,将来的公司会是由无数Loops拼起来的高度自动化运营组织,一个组织最终就变成一个不断学习、不断进化的系统。
三条原则看下来,百度是想把企业对AI的用法推进到日常管理里。配套的是芯片、云、模型和智能体这套布局:模型管理解和推理,云平台撑任务运行,智能体接工具和业务系统,组织给出目标、知识和权限。
芯云模体四层,百度全部自研。自家芯片跑自家云,云上跑自家模型,模型再长出智能体应用。几层互相加强、循环优化,整个架构本身就是一个Looping。
第一批智能组织的探索
目前智能组织最完整的样本之一,就是百度自己,使用规模和深度已经同时显现。
会上披露的数据是:过去一年,内部日活智能体从0.5万涨到3.7万;每周有效任务完成数从8.4万增到超过100万;组织Skill累计沉淀超2万个,Workspace建了4300个。
具体例子是dodo。这个AI助手出自百度内部一个十来人的小团队,上线7个月覆盖99%的正式员工,推动300多个企业平台完成AI友好化改造,今年拿下百度最高奖和百万美金奖励。
百度数字人创新业务部又是另一种情形:产品、研发、设计、测试之间的固定分工被整体打破,全员转向Builder,仅Q3就完成564次产研迭代,沉淀130个Skills和729篇组织资产,人均吞吐提升125.3%,交付周期缩短28.8%。
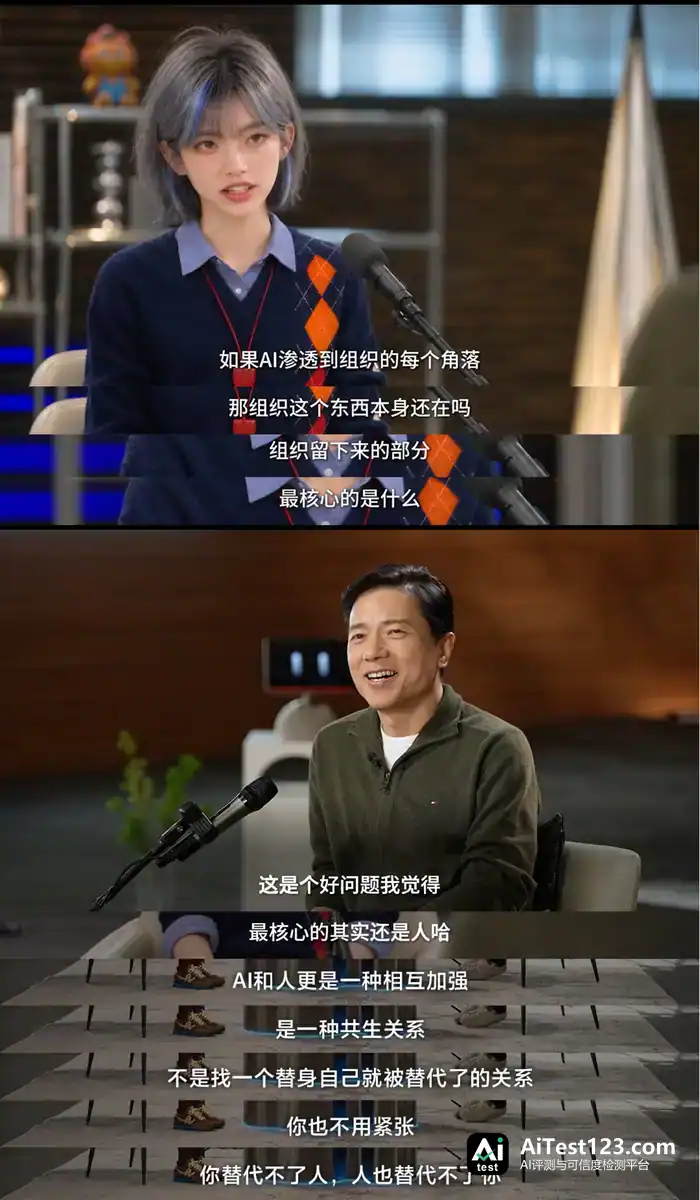
百度内部为什么最先出现这种变化?认知之外,芯片、云、模型、智能体的全栈布局是关键原因。
百度集团执行副总裁、百度智能云事业群沈抖提到,新的AI云会前所未有地穿透企业的底层资源系统、IT系统,甚至经营系统。原因在于,这套基础设施服务的对象不再只是人、工具、流程中的某一个,而是它们共同构成的一个个任务。
同时,智能体把企业任务内化,推着智能组织往前走。AI不再是单独摆着的可选工具,而是被重构进业务流和任务的loop里,企业经营效率才真能提上去。面向智能体、支撑大规模智能体负载的AI云基础设施,需要新的一套。底层百舸AI Infra提供更强、性价比更高的算力;上层千帆Agent Infra提供智能体规模化运行的环境和模型服务。两层合起来,大规模、长周期的任务才能真跑完一个闭环。
沈抖表示:“未来智能组织这件事,没有哪家企业能单枪匹马做成。我们想把基础设施打扎实,让各行各业的智能组织都能在云上扎根、壮大。”
另外,百度还推出了大模型交易平台词元所,这个动作挺有意思。
词元所要答的不是“哪里能买到模型”,而是“买到的模型是不是它自称的那个模型”。模型供给每天以数款的速度往上加,选择成本就落到了采购方头上——企业缺的是能复用的准入规则和持续监测机制,不是再一个模型目录。
这事和智能组织的关联在于:AI一旦进了日常业务,服务质量就得持续判断,采购时测一次不够。模型身份、响应速度、可用性能查得着,任务出了岔子才好找原因。词元所给的是模型供应端的判断依据;这些投入最后能挣回多少,还得回企业自己的业务结果里算。
平台主打“验真”和“征信”两项能力,靠模型指纹比对、能力测试、性能与可用性测试等技术核验资源,再用定期抽检拨测、全链路实时监测调用等办法,给模型提供商建信用评级,向客户提供中立可信、公开透明的模型交易服务。试运营一个月,入驻供应资源已超100个,日均调用次数突破5000万,日均调用Token超7000亿。
有了芯片、云、模型、智能体这套完整技术栈,智能组织的形态也在往百度外面走。南方电网就是个够硬的样本:百度搭子落地南方电网总调,成为天璇伙伴,服务南方五省两亿多人的用电保障。
拿配电网故障研判来说。广西电网2025年永久性故障发生8215次,以往靠人工研判,一次要花60分钟以上,还得看专家经验,误判并不少见。
南方总调与百度基于百度搭子合作搭起天璇伙伴:它学过上万条历史故障处理数据,把资深专家的经验变成可复用的知识;故障记录、开关信号、线路拓扑被串成一条完整证据链,从故障到分析的研判由此闭环。准确率做到70%以上,故障分析效率提升12倍,目前已在广西14个地市和112个县全面推广。
百度搭子的生态合作伙伴已超过160家,接入生态能力1800多项,覆盖30多个专业领域。对更多企业来说,接进智能组织,比自建一套能力门槛低得多。
组织形态的更替从来是慢变量。科层制从韦伯的理论变成全球公司的默认设置,用了半个世纪。智能组织改造企业形态会有多快,或许就是AI兑现价值时间线的标准答案。














