浙大联想联手推EM²Mem:让AI以事件为单位记住长视频
现在的AI看视频往往只存碎片,问它“谁说要种花”容易答错。浙大和联想团队提出的EM²Mem不再孤立存储画面和文字,而是把人物、动作、时间打包成“事件档案”。这种先对齐再检索的思路,不仅让长视频问答更准,还因为减少了临时拼凑证据的过程,让推理速度提升了近5倍。对于需要长期陪伴的智能体来说,这才是真正能沉淀下来的记忆。
为什么AI总是“脸盲”又“健忘”?
设想一下:你刚跟朋友聊完天,对方问你“刚才谁说打算种花来着?”
对人是小菜一碟。脑子里过一遍刚才的画面和对话,答案自然就出来了。可要是换成一个看过好几小时视频的AI助手,这事就麻烦大了。
它也许能翻出“花”的图片,找到几个人的名字,甚至定位到聊“种植”的那段内容。可到底是谁提的这个计划,它还是说不准。线索凑齐了,关系却没接上。

说白了,现在多模态智能体在长期记忆上就卡在这儿:数据存了一大堆,经历没记住。真想当个长期陪伴的AI,光搬信息远远不够。它得弄明白用户是谁、做过什么、在意什么,还得把每次交互里的新经历跟旧记忆接上。记忆只有从孤立的碎片变成有脉络的经历,智能体才算得上持续学习。

浙江大学和联想集团的研究团队盯上了这个难题,联合提出一种新记忆架构——EM²Mem(Event-Centric Multimodal Memory)。说白了,就是让AI照着人的样子,按“事件”来整理记忆。
从“先搜后拼”到“先整后查”
眼下不少方法处理长视频时,都是先切出描述、转写文本、关键帧或知识图谱,分头塞进数据库,等用户提问了再去检索。问题很明显,论文里管这叫retrieve-then-align(先检索,再对齐)。

举个例子,你问“这件事后来怎么样了”,系统可能搜出几个相关片段。可模型得在回答的那一刻临时琢磨:这些片段讲的是同一件事吗?谁跟谁有关?谁先谁后?要是某条关键证据单看相关性不高,检索阶段就被滤掉了,模型自然永远拼不出完整的真相。
EM²Mem把顺序调了个个儿:align-then-retrieve(先对齐,再检索)。功夫下在记忆构建那一步。视频进来时,系统不是简单切片了事,而是主动把同一事件里的人物、物体、行为和时间线索串起来。后面的问答就能直接围着完整的“事件”转,不用模型一边回答一边手忙脚乱地拼线索。
给经历建一份“事件档案”
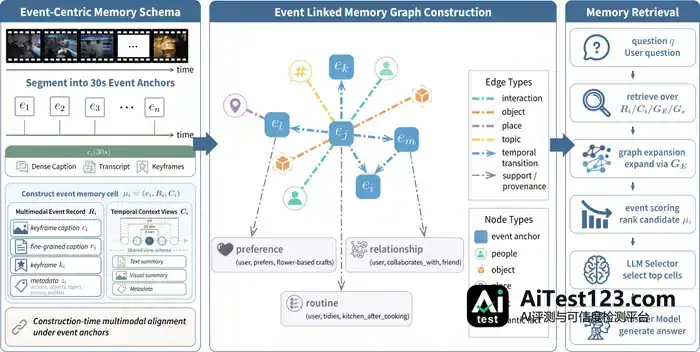
可以把EM²Mem里的记忆单元看成一份带时间戳的事件档案。系统先把长视频切成较短的基础片段,典型粒度是30秒。每个片段充当一个“事件锚点”,记下身份和起止时间。画面也好,声音也罢,相关证据全挂在这个锚点下。
档案分三层。第一层记清当下:每个事件单元保留关键帧、视觉描述、对话转写,还有动作、物体、话题等结构化字段。拿一段花艺讨论来说,谁说了什么要记,画面里的花和花瓶也留着。这层解决的是“当时发生了什么”。
第二层保留前因后果。30秒常常讲不清一件事。EM²Mem会搭出3分钟、10分钟乃至1小时的多尺度上下文,把更长范围的文本和视觉摘要挂回基础事件。局部细节就能嵌进较长的叙事里,这层答的是“前后发生了什么”。
第三层连接长期规律。情节图和语义图负责把不同事件里的人物、物体、地点、话题连起来,更高阶的语义图则用来组织习惯、偏好和稳定关系。这些信息照样链到底层事件,随时能回溯依据。
问题一来,系统先定位相关事件,再顺着时间或实体关系补线索,最后由选择器留下必要证据。碰上需要视觉核验的问题,还能调取少量关键帧。模型回答时,发生了什么、跟谁有关、证据从哪来,能一并握在手里。
案例复盘:到底是谁要种花?
论文里用了一个多人讨论的案例,把这种差别摆得很直观。问题是:Who plans to grow flowers?(谁打算种花?)
那场讨论里提到了花、花瓶、手工制作,还有几位参与者各自说的话。WorldMM 这个传统模型捞出了好几段跟花沾边的内容,可人物和计划之间没对上号,结果被局部的字面意思带偏了。Tasha 的片段里冒出了“planning”,跟提问中的“plans”意思很近,模型就认定是她提的计划。
EM²Mem 这边不一样,搭记忆的时候就把 Katrina 跟对应的计划、物品和时间背景牢牢绑在一起了。读到相关事件后,系统结合她聊种植周期的那段话,还有后面那句“我们也可以种”,把别人插进来的发言分了出去,答出了正确的人:Katrina。
这个例子摆出来,说明多人、多物体、跨多个时间段的场面里,光靠内容相关还不够,记忆怎么组织,得把事件内部的关系留下来。
准头上去了,速度也快了
准确率之外,效率同样是长期记忆系统绕不开的指标。试想每回答一个问题都要把海量数据重新捋一遍,用起来体验肯定糟糕。
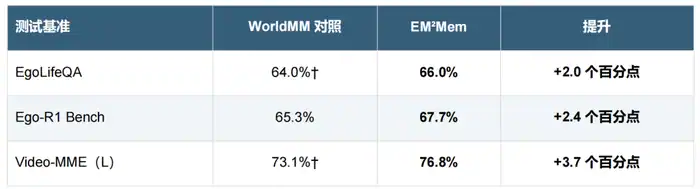
EgoLifeQA 基准测试里,EM²Mem 交出的成绩挺扎眼:
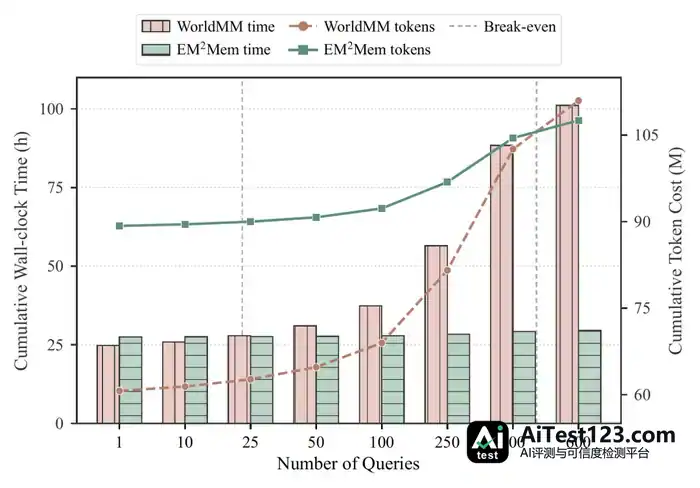
- 一次问答平均花的时间,从 459.00 秒掉到 98.21 秒,快了约 4.67 倍。
- 推理阶段用的 Token 总量,从 42.03M 降到 15.27M,少了 63.66%。
这些好处,说到底来自“提前整理”。记忆在构建阶段就已经理好结构,提问时只要读取、筛选相关证据,不必临时再去收拾那一堆多模态线索。
更关键的一点,记忆建一次,后面的查询能反复用。问得越多,构建那笔开销就被摊得越薄。论文估算,大约 24 次查询就能把多出来的构建时间抹平;查询到约 536 次之后,算上构建阶段的总 Token 用量也开始低于传统做法。
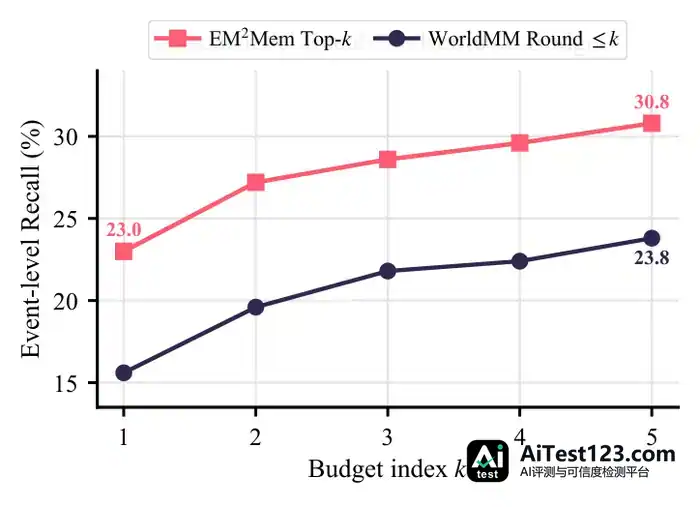
在要求严格的 30 秒事件级证据召回评估里,EM²Mem 的 Top-5 召回率为 30.8%,WorldMM 五轮迭代检索是 23.8%,前者高出 7.0 个百分点。也就是说,它不光答得对,还能更准地找到撑住答案的那几段证据。
从实验室走到生活:LightMem-Ego
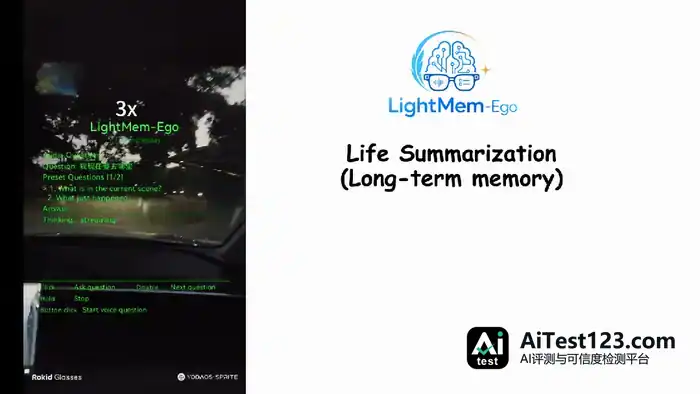
团队在 EM²Mem 的基础上又搭了多模态智能体记忆系统 LightMem-Ego,并试了两个落地方向。
头一个是个人生活助手。用手机和智能眼镜记下日常,AI 能帮你找回随手搁下的东西、翻出以前的对话、把生活笔记理一理。它不再是冷冰冰的搜索框,而是记得你生活里那些零碎的个性化助理。
另一个是科学实验室助手。科研人员把实验过程中的视频、操作和对话持续录下来,AI 就能帮着回溯步骤、找出关键操作和现象,还能自动整理实验记录。对讲究严谨、要求可追溯的科研工作来说,这个价值不小。
眼下相关代码已经并进 LightMem-Ego 项目,论文也发在 EMNLP 2026 Findings 上。这项研究其实在提醒一件事:AI 的记忆不该只是把数据堆起来,而得是对经历的理解。等它学会像人那样“记事”,才谈得上真正融进我们长期的生活。