

OpenAI高管讨论重设2027年数据中心预期:全美项目停摆将冻结多少算力
在极端情景下,美国数据中心总容量会在 2028 年前后停在约 120 到 150GW,大约是今天的 2 到 2.5 倍,此后不再增长。两三百 GW 的规划被冻结,相当于数千万块最先进的 AI 芯片失去了机房。
2026年11月4日,美国中期选举结果出炉的次日清晨,OpenAI的高管们聚到了一起。
据外媒引述知情人士的说法,这场碰头要商量的,是2027年的数据中心容量预期要不要推倒重来。事情还没定下来,但不安的情绪已经藏不住了。
最近几个月,美国各地的大型数据中心项目一个接一个停摆。得州前任州长Abbott自8月起就冻住了数据中心的并网和空气许可,要求审计做到年底;新当选的州长Gina Hinojosa则承诺,在州议会通过立法保护居民之前,所有新数据中心审批一律暂停,而议会会期要到2027年5月才收尾。
俄亥俄新州长Amy Acton拿出的方案是有条件暂停:新项目得自己扛下全部电力成本,选址也只能落在旧工业用地上;佐治亚新州长Keisha Lance Bottoms的打算更直接,上任后就签行政令,全州新建项目先停。
Tokenpost的统计显示,今年7月到11月4日,美国至少有21个大型数据中心项目被取消,已经逼近2025年全年的23个。Anthropic在10月26日提交的招股书里同样把暂停令列入了风险因素:部分辖区正在考虑或已经批准暂停令,这或许会让它所依赖的算力设施延期甚至落空,况且反对数据中心的声浪正在不同辖区之间变得更有组织。
把这种势头推到极致,设想这样一个局面:美国所有规划中的数据中心全都建不成,眼下的AI和将来的AI会遭遇什么?
01 潜在算力增长被砍掉50%
为了把推演的边界划清楚,我们设定这样一个极端场景,它建立在三条假设上:
1,全美所有尚未开工的规划项目全部冻结,相当于把目前约41%的暂停范围推向全国;
2,已经在建的项目全部按期完工,这和德州等地暂停令只针对新审批的做法一致;
3,芯片照常供应,唯一的硬约束是电和地。我们只推演美国本土,暂不讨论算力外迁。
这个场景下,被卡住的算力规模有多大?据Newmark估计,美国数据中心当前用电约60GW,这里包含所有数据中心,并非全是AI。在建容量各家口径不同:Cleanview约57GW,Wood Mackenzie约80GW,DCMap 8月的统计约90GW。这部分项目在情景里会照常完工,构成未来几年美国算力的全部增量。
真正庞大的是「规划中、未开工」的部分,DCMap 8月统计为228GW,Wood Mackenzie披露的累计管线超过430GW,取一个约230到340GW的区间比较稳妥。
按这个口径大致一算,若真走到极端情景,美国数据中心总容量到2028年前后会卡在120至150GW左右,相当于眼下的2到2.5倍,之后便不再往上走。Synergy早先的预测是美国容量2029年翻番;要是管线里的规划全部建成,本该达到今天的5倍以上。极端场景削去的,正是翻番之后那一大截增量。
折成芯片来看会更清楚。1GW电力大致能撑起数十万块Blackwell级GPU:按单卡全口径功耗1.8到2.3kW理论计算,约43万到55万块;Abilene这样的实际园区,约每GW 27万块。两三百GW的规划被冻结,等于数千万块最先进的AI芯片没了机房可放。

亚马逊为Anthropic建设的Project Rainier园区内部|图片来源:Amazon
这个情景很极端,但不荒谬。据Cleanview测算,新州长承诺暂停的州里,规划容量合计158.6GW,约占全国的41%,其中德州88.4GW、俄亥俄21.9GW、佐治亚20.2GW、新墨西哥11GW、纽约9.9GW。也就是说,情景A里接近一半的冻结,在现实中已经有了对应的政策承诺。2024年以来被取消的69个大型项目里,有33个主要因为当地反对。参议员桑德斯还提出了全国性暂停法案,虽然通过的可能性很小。
得实话实说,眼下规划里的数字虚得很。ERCOT这家德州电网的大负荷排队规模约474GW、项目约1800个,差不多是该电网峰值负荷的五倍,其中多数属于占位性质的投机申报。因此极端场景真正砍掉的有效算力,会低于账面数字。可就算挤掉水分,这仍然是对算力供给的一次猛踩刹车。
这样一脚「算力刹车」踩下去后,会对AI产生怎样的影响?
02 当下照常,下一代AI受阻
假设极端情景明天就落地,用户在一两年内其实察觉不到什么变化。2027年之前的前沿模型,照旧训练、照旧升级。
原因在于,撑起这一代模型的训练基地,不是已经建成就是快要完工。Epoch AI的数据库显示,目前已知最大的AI园区是Anthropic与亚马逊在印第安纳州的New Carlisle,容量1037MW;排在其后的是xAI的Colossus 2,946MW。OpenAI在德州Abilene的园区规划1.2GW,8栋楼里有6栋截至9月已经交付,预计年底收工。
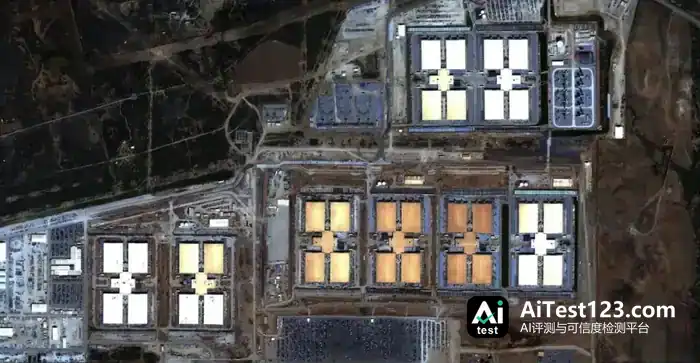
OpenAI位于德州Abilene的Stargate园区卫星图|图片来源:Epoch AI
被卡住的,是计划在2028到2030年登场、需要数个GW才能喂饱的下一代模型。
Epoch AI 的统计摆出一个趋势:前沿训练的耗电量正以每年 2.2 到 2.9 倍的速度往上走,眼下单个前沿训练项目已经吃掉超过 100MW。按这家机构的预计,一年之内会有若干园区跨过 1GW 的门槛;大约两年后,规模最大的训练或将动用约 250 万块 H100 等效算力;顺着这条曲线看,到 2030 年,单次最大训练需要 4 到 16GW。
拿今天的现实比一比:目前最大的园区才刚过 1GW。Epoch 同时点明了一层关系——数据中心的容量其实就是训练规模的天花板,园区能建多大,模型就最多能训多大。
那些盯着 2028 年以后的超级工程,已经有不少在现实里碰了壁。
OpenAI 的 Stargate 打算到 2029 年做到 9GW 以上,美国 7 个站点里多数原本安排在 2027 到 2028 年大规模上线,而这些站点扎堆在得州、新墨西哥和俄亥俄——正好是这轮暂停涉及的几个州。
具体看:Abilene 附近原定的扩建已经作罢;新墨西哥州 Doña Ana 那个规划 2.45GW 的 Project Jupiter,今年 3 月被州土地办公室挡回了供气管道;俄亥俄州 Lordstown 站点,4 月的卫星图像里仍看不到成规模的施工迹象。
Meta 那边,约 1GW 的 Prometheus 园区同样落在俄亥俄,只有路易斯安那州目标 5GW 的 Hyperion 没被这轮暂停波及。
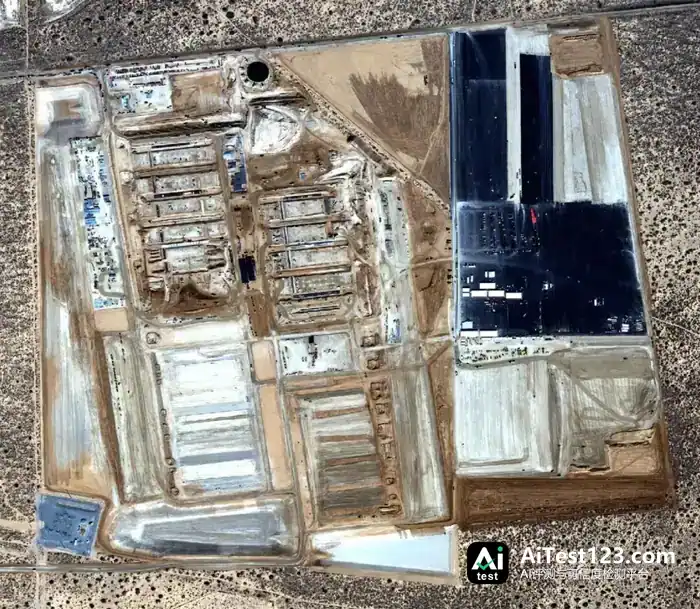
新墨西哥州 Doña Ana 的 Project Jupiter 工地卫星图|图片来源:Epoch AI
于是问题就来了:下一代训练的算力基地一旦搁浅,AI 的进步要慢多少?
03 降速,但不会停摆
想回答这个问题,得把算力增长拆成几块分别看。
Epoch AI 的统计显示,2020 年以来前沿语言模型的训练算力每年涨约 4 到 5 倍,同期训练用电每年涨 2.2 到 2.9 倍。中间那约 2 倍的差距,大头来自芯片能效的进步——同样的每瓦电,能换回更多算力。
算法这一侧也在出力。通行的口径是算法效率一年提升约 3 倍(Ho 等人 2024 年的研究给出约 2.7 倍)。Epoch 后来把后训练也纳入计算,估到约每年 10 倍,但区间在 2 倍到 50 倍之间浮动,这里取更保守的 3 倍。
有了这些数,就能做个粗略推演。
按正常节奏,AI 每年拿到的「有效算力」增幅,是物理算力增长(4 到 5 倍)乘上算法提升(约 3 倍),算下来一年约 12 到 15 倍。
换成情景 A:2028 年之后新增电力归零,物理算力增长最大的那根支柱被抽掉,只剩下芯片换代带来的能效提升,每年约 2 倍。再乘算法的 3 倍,「有效算力」的年增速就从 12 到 15 倍滑到约 6 倍。
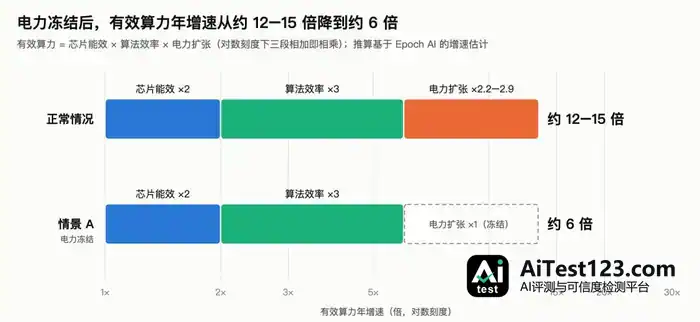
有效算力年增速拆解:正常情况与极端情景 A 对比(推算)|图片来源:极客公园
若采用 Epoch 更乐观的算法口径(每年约 10 倍),正常情况下的有效算力增速是每年 40 到 50 倍,情景 A 下约 20 倍。两种口径都指向同一件事:电力一冻结,有效算力的增速就掉到原来的四成到一半上下。算法跑得再快,也填不上电力扩张留下的窟窿。
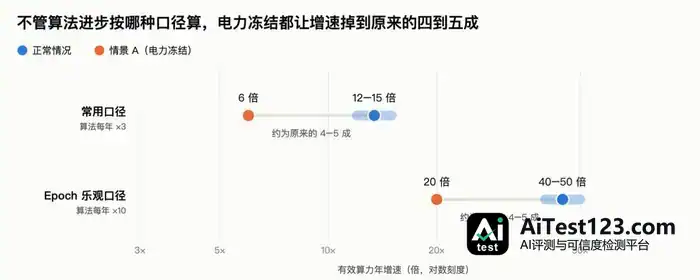
两种算法口径下,电力冻结前后的有效算力年增速(推算)|图片来源:极客公园
这里还埋着一个变数。芯片能效的红利,得先有新芯片顺利进机房才能兑现。机房总电量一旦锁死,供电和散热改造的难度,可能让这 2 倍也缩水。
可就算这样,每年约 6 倍仍是个不小的数目。推下来,结论并不含糊:
极端场景下,AI会明显减速,但不会停摆。
不过这笔账只算了训练那部分算力。把镜头拉到整个 AI 的运转上,电量锁死之后,另一场争夺马上就会开打。
04 Token 限额时代来了
以前算力不够,办法是去圈地建新机房。极端场景下,锅里就这么多电,分给训练的每一度,都得从推理、智能体和后训练那里抠出来。
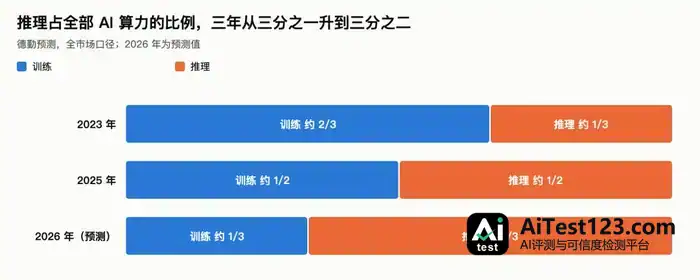
全市场的算力盘子,其实早就往推理那头偏了。德勤给出的预测是:推理在全部 AI 算力中的占比,2023 年大约三分之一,2025 年约一半,2026 年预计能到约三分之二。
推理与训练在全部 AI 算力中的占比变化|图片来源:极客公园
AI 实验室内部的算力结构同样在挪。SemiAnalysis 把 OpenAI 和 Anthropic 的算力合在一起估算:2024 年初,预训练占 67%,后训练和强化学习只有约 5%,推理约 29%。之后预训练占比一季比一季低,二季度 63%,三季度 57%,2025 年落到五成多;后训练那头则一路往上,最新估计两者已经不相上下。也有研究者提醒一句:这说的是占比,实验室的总算力翻了很多倍,预训练的绝对量未必就少了。
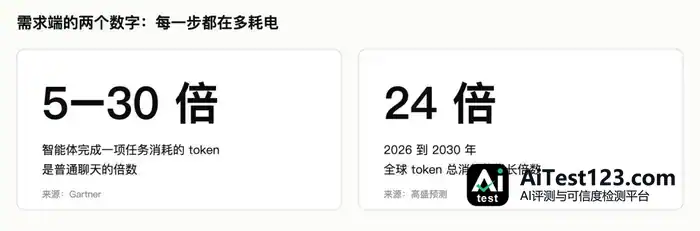
压力更大的一头来自产品形态。推理模型开口之前要先铺一长串思维链,用户看不见,可每一步都在耗电。Gartner 的数据是:智能体做完一项任务烧掉的 token,是普通聊天的 5 到 30 倍。
高盛则预测,2026 到 2030 年,全球 token 的总消耗量会涨 24 倍。
智能体与 token 消耗的增长|图片来源:极客公园
把这些数字塞进极端情况下那份固定的电量里,每家实验室面前都是同一道选择题:每一兆瓦,是拿去训下一代更大的模型,还是拿去服务眼下这批用户和智能体。
想凑几十万块卡训一个更大的基座模型,就得压住现有用户的调用量;反过来优先保推理、保用户,下一代模型的进度就得往后拖。
加电这条路一旦被堵死,接下来要问的就是:电和算力都定死的情况下,AI 还想往前走,还能往哪儿走。
05 四条「补充路线」
极端场景一压上来,那些过去因为「反正能加卡」而没人搭理省电技术,会翻身变成主流方案:
硬件的考核指标,换成「每瓦电能产出多少 token」。
电量固定的机房里,想扩容只剩一条路:把旧芯片换成能效更高的新芯片。
英伟达眼下主推的指标,就是「每个全口径电力兆瓦每秒输出的 token」,分母把园区全部用电都算了进去,散热和网络也在里头。这个指标能流行起来,本身就说明芯片厂商已经默认客户的瓶颈在电,卡多卡少反倒次要。
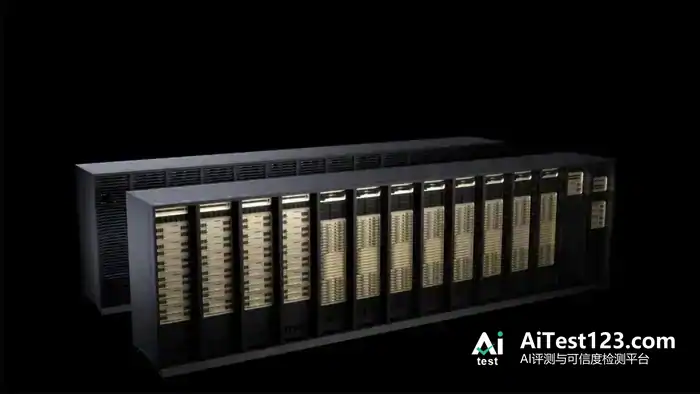
按英伟达的说法,Vera Rubin 的每瓦性能是 Blackwell 的 10 倍,智能体场景下对比 GB300 最高能到 30 倍。独立测试的结果也差不多:CoreWeave 实测,在同一 DeepSeek R1 负荷、相同交互速度下,Vera Rubin NVL72 每兆瓦的 token 产出是 GB200 NVL72 的 10 倍。不过 Rubin 下半年才量产,多数客户要等到 2027 年才能普遍用上。
英伟达 Vera Rubin NVL72 机柜|图片来源:NVIDIA
跨机房分布式训练。
暂停令普遍盯上的是动辄数百兆瓦的大型数据中心。于是一个很自然的绕法就出来了:把训练任务拆开,分到不同地区的中小机房里去。政策压力会直接转化成对分布式训练的技术需求。
这条路巨头们已经在试。谷歌讲过,Gemini 是在多个地点的集群上同步训练的;微软把威斯康星和佐治亚的机房连到了一起;CoreWeave 与谷歌云也宣布了跨云训练。谷歌的 DiLoCo 研究显示,训练可以放在普通网络连接的远程设施之间跑,还能扛住硬件故障。
难度也不小。DiLoCo 的作者自己承认,这项技术眼下只能给超大集群打补丁,替代不了。2026 年的一项仿真研究发现,机房之间相距几十到几百公里时,网络延迟会明显削弱计算与通信的重叠,大量算力就在等数据的过程中空转。
研发重心从预训练,转向后训练和强化学习。
预训练对单一超大集群的依赖最重,极端情况下也最先被卡。数个 GW 的集群建不起来,工程师的精力就会挪到对集群规模没那么挑剔的后训练、强化学习,以及混合专家模型、低精度计算这类架构改进上。Cursor 就公开说过,其 Composer 1.5 模型在后训练上投入的算力,已经超过了预训练。
端侧和小模型给云端分流。
2026 年做小模型,蒸馏已是最普遍的路子。小模型量化后能在手机 NPU 上直接跑结构化任务,参数量不到 10 亿的,速度大概每秒 12 到 15 个 token。混合模式的应用也在变多:大部分请求先由本地小模型接住,只有少数难处理的才交给云端大模型。
06 约束之下,机会在哪
卡住的是美国本土的电力供应,这是极端场景下的症结。可对另外两类玩家而言,这道约束反倒开了一扇窗:一类是多年在效率路线上深耕的模型公司,另一类是想进场的 AI 创业者。
先看前沿模型和追赶者差多远。Epoch AI 今年 5 月的测算显示,最强开源模型平均比闭源前沿落后约 4 个月,差距大致相当于 GPT-5 和 GPT-5.5 之间。以往前沿实验室每年靠十几倍的有效算力增长,把代差越拉越大;到了极端情景,这一增速降到约 6 倍,新代差更难拉开,追赶者要跑的距离也就短了。
效率路线上的先行者同样值得看。DeepSeek、Qwen、Kimi、GLM、MiniMax 这些中国模型公司,一向以开源、低成本、混合专家架构打底,这条路线的成效已经体现在使用数据里。
OpenRouter 与 a16z 的联合研究显示,中国开源模型在该平台上的 token 占比,2024 年底还在约 1.2%,2025 年已逼近 30%;到 2026 年,多家统计给出的数字落在五到六成之间。
a16z 合伙人 Martin Casado 还估算过,用开源技术栈的创业公司中,约八成在跑中国模型。OpenRouter 终究只是一个平台,ChatGPT 自家流量和企业私有部署都不在其中,可趋势摆在那里:
整个行业都得回答「每度电能产出多少智能」,长期钻研这道题的团队,积累下的经验会更吃香。















