

MolRSI双循环改写分子发现:抗菌筛选命中率15.9%
MolRSI通过递归自我改进机制,自动搜索并优化分子发现的工作流。在抗菌药物筛选中,其湿实验命中率较人类专家设计流程提升82%;在pMHC结合蛋白设计中,实现了从0到8个特异性命中的突破。该系统利用跨任务经验积累,显著提升了新任务的起点表现,展示了AI在复杂科学决策中的潜力。
当AI开始决定“怎么找”分子
药物研发的早期阶段,摆在研究人员面前的从来不是单一问题,而是一连串选择题。化合物库动辄数以千万计,活性预测该挑哪个模型?抑菌效果和细胞毒性怎么权衡?哪些结构能算“新颖”,哪些又跟已知抗生素太像?最后,哪几十个分子值得花钱送进湿实验?

过去,这套筛选规则(也就是工作流)靠人类专家凭经验来定。可人的精力终究有限,把所有模型组合和参数配置的可能都试一遍,几乎做不到。新近发布的 MolRSI 系统想换个思路,把这道“元问题”交给 AI 自己:不光让 AI 去找分子,还要让它学会“怎样找分子”。
研究得出的核心结果很显眼:训练数据和筛选库都不变,MolRSI 自主优化出的工作流在针对甲氧西林敏感金黄色葡萄球菌(MSSA)的筛选中,湿实验命中率达到 15.9%。此前由人类专家精心设计的非智能体工作流,命中率只有 8.7%。两者一比,相对效率提升约 82%。
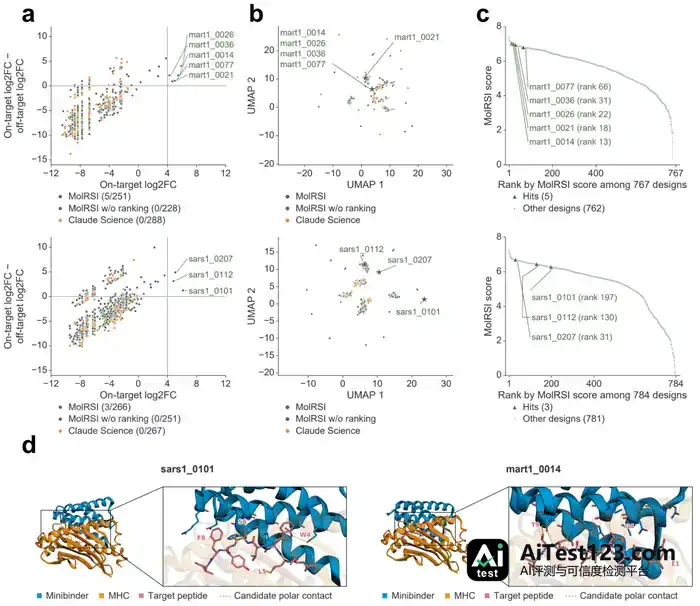
更难的一项任务也给出了验证:从头设计能特异性识别 pMHC(肽-主要组织相容性复合体)的结合蛋白。在这个方向上,MolRSI 拿到 8 个满足严格实验特异性判据的命中分子;作为对照,Claude Science 系统的结果是 0。
递归自我改进:双循环机制
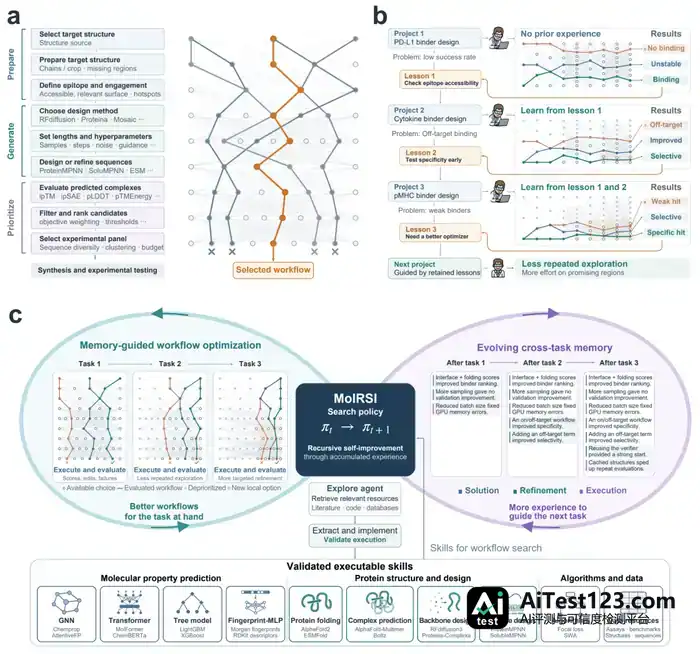
MolRSI 全称是 Recursive Self-Improving AI agent for Molecular Discovery。它把“科研工作流的搜索”本身当成一个可以优化的过程,这是整套逻辑的核心。

系统内部跑着两个循环:
- 内循环:围绕当前这个具体的分子发现任务,去搜索并优化工作流。比如调整模型权重、改变过滤顺序,或者替换评分函数。
- 外循环:把内循环里攒下的经验存下来——哪些修改管用、哪些流程稳、碰到错误怎么修——再用这些经验去指导之后全新任务的搜索策略。
这套机制靠的是经验引导的蒙特卡洛树搜索(MCTS)。每一套候选工作流就是搜索树上的一个节点,对它做的修改(更换预测模型、调整阈值等)长出新分支。下一步往哪走,由当前任务的评价反馈、历史任务的表现,以及探索新方案的需要共同决定。
为支撑这个过程,MolRSI 维护了三类记忆:
- 方案记忆:记录不同流程在特定条件下的表现。
- 改进记忆:记录哪些修改操作带来了性能提升。
- 执行记忆:记录运行过程中的错误及修复方法。
搜索产出经验,经验反过来改变后续的搜索策略(search policy),新的搜索又带来新的经验。科研自动化里的“递归自我改进”,说的就是这个具体过程。
经验的价值:从冷启动到快速收敛
让 AI 从零开始摸索,效率未必高。MolRSI 的长处在于它能“带着经验出发”。
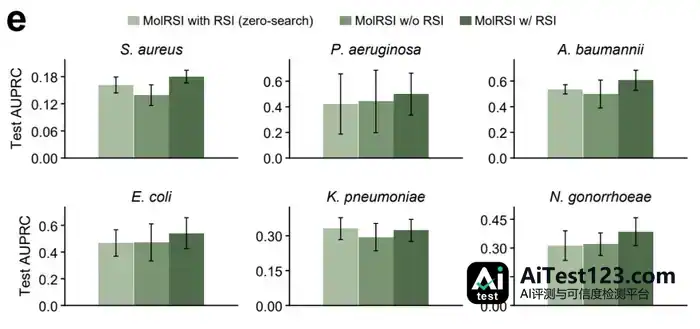
研究团队先让系统在 25 个分子性质预测和细胞毒性任务上攒经验,再把这些经验用到 6 个全新的抗菌预测任务上。对照组继承不了这些跨任务经验,虽然它们的初始技能库和计算预算与前者相同。
结果,有了跨任务经验之后,6 项新任务的平均测试 AUPRC(曲线下面积,衡量模型排序能力的指标)全部提高。更直观的一点是:在大肠杆菌和淋病奈瑟菌任务上,MolRSI 首次评估的工作流,表现已经超过 Biomni、STELLA、Codex 等主流系统搜了 20 轮才选出的最佳流程。
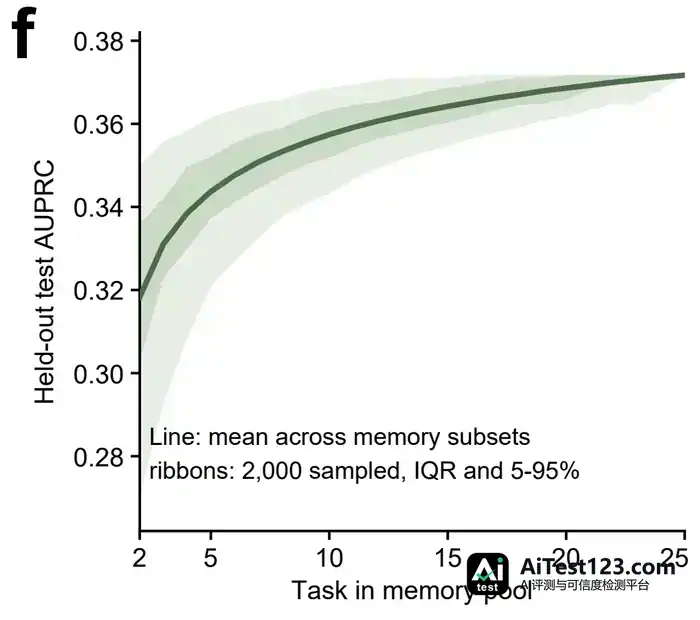
来源任务池从 2 个扩到 25 个,可迁移的高质量工作流随之变多。回顾性分析显示,6 项抗菌任务上的平均测试 AUPRC 从约 0.32 升到约 0.37,甚至高过没有先前经验的系统搜索 20 轮后的水平(0.361)。
对 AI 科学家来说,过去的失败和成功一样值钱。它们堆成一个越滚越大的“方法库”,新任务不必再从零冷启动,而是在前人基础上迭代。
实战一:抗菌分子的精准筛选
抗菌药物发现任务里,MolRSI 面对的是约 1210 万个化合物组成的筛选库。它最终优化出的工作流包含以下几个关键步骤:
- 系统会先做结构新颖性筛查,把带有常见抗生素骨架、或与已知抗生素相似度太高的分子剔出去,以保证筛到的是新结构;随后再针对三类人体细胞做毒性预测,把后续开发的风险压下来。
- 活性预测这一步用了集成思路:两套 MiniMol 方案加上 LANTERN–RADR 模型,按 55%、30%、15% 的权重把结果合起来,以此提高准确率。
- 预测得分高的分子还要过一道多样性关——按结构相似性做聚类,再从各个簇里挑代表,让化学多样性得以保留。
整套流程跑下来,系统从千万级化合物库中挑出 107 个分子送去做湿实验,其中 17 个命中(命中定义为对 MSSA 的最低抑菌浓度 MIC ≤ 32 μg/mL)。人类专家设计的流程则测试了 241 个分子,命中 21 个。绝对命中数看着接近,可 MolRSI 动用的实验资源不到对方一半,命中率相当于翻了一倍。
在另一个由 271 个化合物组成的独立测试集上,MolRSI 优化出的预测器在 AUROC 和 AUPRC 两项指标上都压过专家流程里的预测器,AUPRC 从 0.090 升到 0.300,说明它的筛选逻辑不只是在统计上好看,对实际实验的指导性也更强。
部分命中分子还被拿去做进一步测试。分子 C3 和 C32 对耐甲氧西林金黄色葡萄球菌(MRSA)表现出强效抑菌活性,MIC 分别为 1 和 8 μg/mL,并且在人体细胞毒性测试中显示出不错的 selectivity window(选择性窗口)。
实战二:pMHC 结合蛋白的特异性设计
抗菌筛选像是在现有库里“大海捞针”,pMHC 结合蛋白的设计却是“无中生有”,精度要求还极高。
pMHC 由细胞表面的 MHC 分子和它呈递的短肽构成,是免疫细胞识别肿瘤抗原的关键靶点。麻烦在于,不同的 pMHC 可能共用同一套 MHC 框架,差别只在少数几个肽残基上。设计出的结合蛋白若特异性不够,就可能把目标和别的一起认出来,造成脱靶。
面对这个任务,MolRSI 走的路线是先把评价标准定下来,再去优化生成:
- 第一步是搭一套特异性评价流程。系统经过搜索,确定了一个组合:ESMFold2-Fast 结构预测加上八项等权评分,八项指标覆盖界面接触、复合物可信度、单体折叠质量等。要点在于,候选分子在目标 pMHC 上的评分必须明显高于它在非目标 pMHC 上的评分。
- 评价流程一旦定下就固定住,系统转而去找最好的生成办法,比如骨架生成、序列设计算法。搜了 30 轮之后,得分最高的那套工作流被用来大规模生成候选分子。
团队把它和 Claude Science 做了头对头比较,双方的设计条件、目标/非目标设定和计算预算完全相同。两轮噬菌体展示筛选之后:
- MolRSI 在 MART-1 靶标上拿到 5 个特异性命中,在 SARS-CoV-1 靶标上拿到 3 个,合计 8 个。
- Claude Science 在两个靶标上都没能得到满足特异性判据的命中,分别是 0/288 和 0/267。
特异性判据卡得很严:目标富集 log₂FC > 4,同时还要高于该设计在所有可测非目标中的最高富集值。这个结果直接说明候选排序和特异性评估在流程里起了关键作用——把 MolRSI 的排序环节拿掉,479 个可评估设计里一个都没命中。
结构分析也印证了设计预期:这些命中分子确实落在暴露肽的上方,并与多个肽残基形成接触。
结语:从单次任务到持续进化
MolRSI 这项研究呈现的是一种新的科研范式——AI 不再只是执行既定指令的工具,而是能反思自己的工作流程、积累经验、实现自我进化的代理。
眼下策略上的改进主要还发生在计算搜索这一层。研究团队认为,未来若能把湿实验的真实反馈也纳入进来,潜力可能更大。放到药物研发里看,这意味着每次实验不管成败,都能变成下一次探索的起点。这种“越用越聪明”的特性,或许才是 AI 加速科学发现最本质的动力。
研究团队自己说得很清楚:让一次研究为下一次研究提供更好的搜索起点,正是这项工作的出发点。面对海量数据和复杂决策,这种递归自我改进的能力,可能比单纯把模型精度往上提更重要。














