

中大梁小丹团队,GeoThinker 两项研究成果,破除空间推理「几何信息用不好、计算开销大」难题
不再实时调用外部三维几何编码器,视觉语言模型空间推理提速约 3.6 倍。
作者丨张岂萍
编辑丨幸丽娟
还真不一定。
判断物体的位置、距离和空间关系,是视觉语言模型实现空间推理需要具备的能力。现在一种常见做法,是接入 VGGT 这类三维几何编码器,从多视角图像中提取深度、点云等空间线索,辅助模型判断。
但外部几何信息并不是越多越好。无关的几何特征可能干扰模型判断,每次调用外部三维模型,也会增加推理时间。
围绕这一问题,中山大学梁晓丹团队连续开展了 GeoThinker 系列研究。
第一项工作 GeoThinker 针对无关几何特征干扰判断的问题,让模型根据问题主动挑选有用的几何线索,更好地利用外部三维几何信息。该工作已被 ICML 2026 收录。
不过,这项工作仍需依赖 VGGT 实时提取几何特征,增加了推理阶段的计算开销。
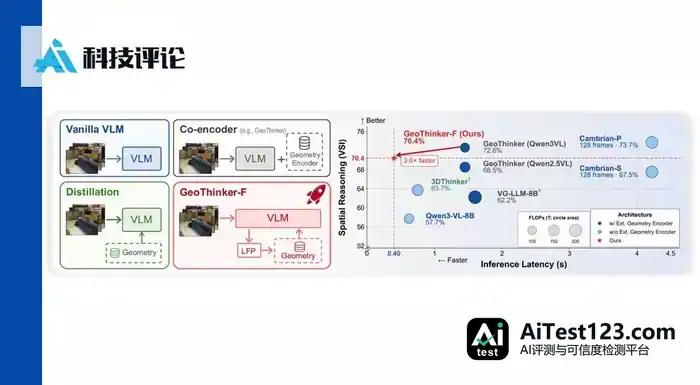
为了减少这部分开销,团队联合小鹏汽车、南洋理工大学和穆罕默德·本·扎耶德人工智能大学(MBZUAI),进一步将研究延伸到模型内部的空间表示学习,让视觉语言模型学会自己生成空间线索,在推理阶段不再依赖外部三维几何模型。模型的空间推理耗时从1.45秒缩短至0.40秒,速度提升约3.6倍,空间推理表现基本保持不变。

论文地址:https://arxiv.org/pdf/2610.20592
两项研究的通讯作者都是中山大学教授梁晓丹。作为 AI 领域青年奖项名单上的“熟面孔”,她是国家“万人计划”青年拔尖人才,曾获达摩院青橙奖、吴文俊人工智能优秀青年奖等多项高含金量青年奖项。她长期研究多模态视觉理解、三维表征与具身智能,GeoThinker 系列工作正是她沿着这一方向持续深耕的成果。
GeoThinker-F 是怎么做到在推理时不依赖外部模型、还能把计算开销降下来的?先从第一项工作 GeoThinker 说起。
01
GeoThinker:几何信息不在多,而在用得准
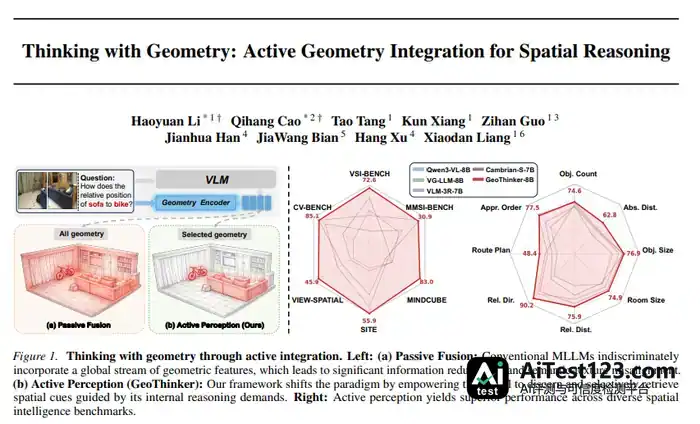
GeoThinker 的核心创新,是让视觉语言模型能够根据推理任务,有选择地利用外部几何特征,减少无关信息的干扰。相关论文《Thinking with Geometry: Active Geometry Integration for Spatial Reasoning》已被 ICML 2026收录 。
论文链接:https://arxiv.org/pdf/2602.06037
视觉语言模型做空间推理,常会用到三维几何编码器 VGGT(Visual Geometry Grounded Transformer)。
VGGT 可以结合多张照片提取场景三维几何信息。例如输入客厅不同角度的照片,它能整合多视角信息,分析沙发、茶几的位置关系,输出几何特征,帮助视觉语言模型解答空间类问题。
但几何信息并非越多越好。判断桌子在沙发的哪个方向,并不需要房间里所有家具和墙壁的信息。
为此,团队设计了空间信息融合机制(Spatial-Grounded Fusion)。它允许模型根据当前问题,主动去几何特征里寻找相关线索,再通过重要性门控(Importance Gating)突出关键区域,减少无关信息的干扰。
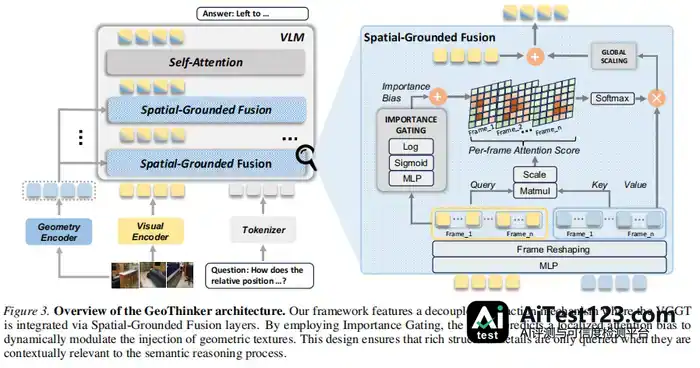
在衡量空间感知能力的综合基准 VSI-Bench( Visual Spatial Intelligence Benchmark )上,GeoThinker 取得 72.6 分,比基础模型提高了 14.7 分。
不过,这份高分背后的代价也很明显:推理慢、算力消耗大。
因为 GeoThinker 每次做空间推理都得额外跑一遍 VGGT 编码器,这就导致它很难满足自动驾驶、机器人等场景对“即时反应”的要求。
能不能连这一步也省掉,让视觉语言模型自己学会生成空间信息?这就引出了 GeoThinker-F 要解决的问题。
02
GeoThinker-F:让视觉语言模型自己生成空间表征
GeoThinker-F 的核心变化,是把 VGGT 从实际推理环节拿掉。训练时,研究人员利用 VGGT 提供的几何特征作为监督信号,让视觉语言模型内部的预测模块学习生成几何信息。到了实际使用时,视觉语言模型不再需要额外调用 VGGT。
整个过程分为两个阶段。
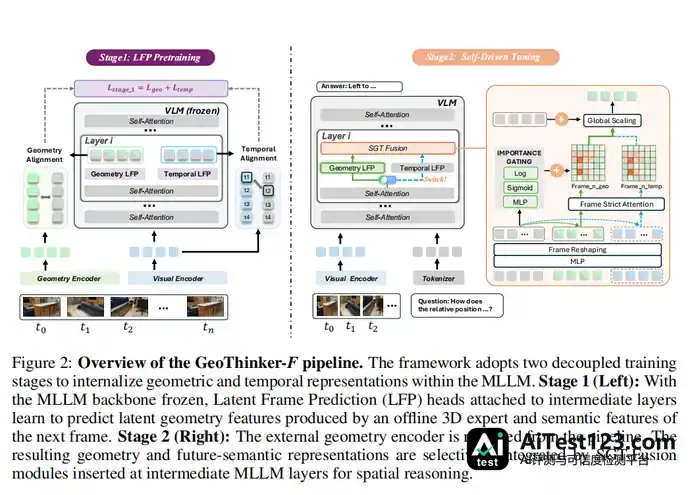
第一步,让视觉语言模型向 VGGT 学习。
训练时,研究人员先用 VGGT 处理多帧画面,提取场景的几何特征,作为学习目标。
怎么让视觉语言模型学会呢?
团队在视觉语言模型的中间层,接入了潜在帧预测(Latent Frame Prediction,LFP)模块。具体来说,它包含两个轻量级预测模块,分别负责几何和时间信息的预测。
这个模块要学两样本事:
第一,学看三维。视觉语言模型在看图时,中间层本来就包含丰富的视觉语义信息。几何预测模块利用这些内部特征,尝试生成当前画面的几何表示,并以 VGGT 提取的几何特征作为训练目标。
这里不要求视觉语言模型精确复现 VGGT 的所有信息,重点是学到有助于空间推理的几何结构特征。
第二,学看未来。时间预测模块根据当前帧的内部特征,预测下一帧的视觉语义特征。它不需要直接生成下一帧图像,而是在特征空间中学习画面随时间变化的信息。
在这个阶段,这两项学习任务是同时进行的。 视觉语言模型的主干参数被冻结,不参与更新。研究人员只训练这两个 LFP 预测模块,让它们在读取同一份内部信息时,同步学习当前几何特征和下一帧语义特征。
第二步,移除 VGGT,让视觉语言模型利用内部特征进行空间推理。
在完成第一阶段训练后,研究人员进入第二阶段。此时,VGGT 被移除,视觉语言模型开始进行面向空间推理任务的指令微调。
在论文最终采用的主要配置中,视觉语言模型主干、LFP 预测模块,以及负责信息整合的 SGT-Fusion 融合模块,是一起参与训练的。
具体来说,研究人员会输入大量的空间推理指令数据(并在扩展配置中加入通用视频数据)。在解答这些任务的过程中,这三个部分会根据反馈一起调整参数、进行联合微调,让视觉语言模型学会真正利用自身预测的几何和时间特征来答题。
经过两个阶段的训练,在实际推理时,视觉语言模型只需要输入的多帧画面和问题,就能通过内部的 LFP 预测模块生成所需特征,无需再运行 VGGT。
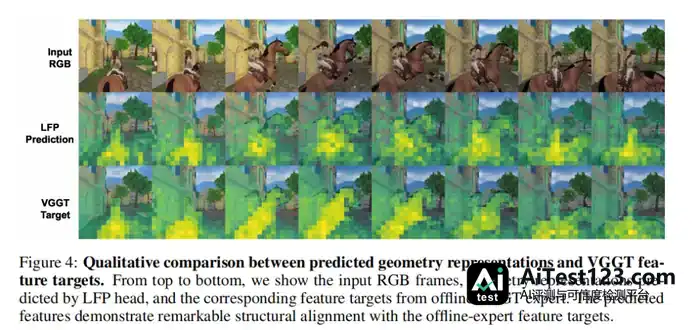
那么,视觉语言模型内部生成的两类特征,分别是什么?
第一类,是当前画面的几何特征。
它们包含与场景空间结构有关的信息,帮助视觉语言模型理解物体的位置、方向和相互关系。
但这些特征并非一张完整的三维地图,也不直接输出物体的精确三维坐标。它们是视觉语言模型内部用于辅助空间推理的几何表示。
第二类,是下一帧的语义预测特征。
视觉语言模型根据当前帧的隐藏状态,预测下一帧可能具有的视觉语义表示,在特征层面引入短期时间变化的信息。
论文将这两类内部预测的特征统称为预测性世界表示(Predictive World Representations),包括当前几何信息和短期未来语义信息。
既然生成了两类特征,怎么让视觉语言模型真正用上呢?
如果在同一个网络层同时融合几何和时间特征,由于这些特征本身存在一定预测误差,可能出现相互干扰和误差累积。
为此,团队设计了 SGT-Fusion 融合机制。
它在第一项工作几何信息融合机制的基础上,增加了专门处理时间预测特征的分支,形成几何、时间两个独立分支。
具体来看:几何分支通过重要性门控和注意力机制,有选择地整合当前画面的几何特征;时间分支负责整合预测得到的下一帧语义特征。
在最后注入视觉语言模型时,团队还采用了分层交错注入的设计。
简单来说,就是将几何和时间特征交替注入不同的网络层,并通过可学习的参数控制注入强度,避免两类特征在同一层直接叠加产生干扰。
由此,视觉语言模型既能利用当前画面的空间结构,也能利用短期未来的语义预测,辅助完成多帧场景下的空间推理。

03
速度提升 3.6 倍,空间推理能力基本保留
GeoThinker-F 最重要的变化,是在推理时不再需要运行外部三维几何编码器。但拿掉 VGGT 后,视觉语言模型还能不能保持原有的空间推理能力?
团队首先使用 Qwen2.5-VL-7B 作为基础模型,在相同训练数据下对 GeoThinker 和 GeoThinker-F 进行对照。
在 VSI-Bench(视觉空间智能测试) 上,GeoThinker 得分为 50.5,GeoThinker-F 得分为 50.7,两者表现基本持平。在相同训练条件下,即使推理时不再调用外部三维几何编码器,GeoThinker-F 仍能保持接近 GeoThinker 的空间推理表现。
消融实验显示,经过第一阶段训练的“几何预测”和“时间预测”都能提升模型表现,两者结合效果最好。相反,如果只加装这两个模块、不让它们提前“学习”,模型的表现并没有提升。这说明,带来增益的是模块学到的空间信息,单纯增加参数量是没有用的。
在此基础上,团队进一步扩大训练规模,增加训练视频帧数,并引入 OmniSpatial-Train 等数据,使用不同基础模型评估六项空间智能基准。
在 Qwen3-VL-8B 底座下,GeoThinker-F 的六项平均得分达到 69.29;使用 Qwen2.5-VL-7B 底座时,平均得分为 66.84。
不过,训练数据本身也会影响结果。为了更准确地比较两种架构,论文还提供了统一训练数据的对照实验。
在同样使用 Qwen3-VL-8B、且不加入额外 OmniSpatial-Train 数据的条件下,GeoThinker-F 的六项平均得分为 62.21,GeoThinker 为 62.23,几乎没有差距。单看 VSI-Bench,两者分别为 70.9 和 72.6。
这组对照进一步表明,在相同训练数据下,GeoThinker-F 即使不再运行外部几何编码器,仍能基本保持原有的综合空间推理表现。
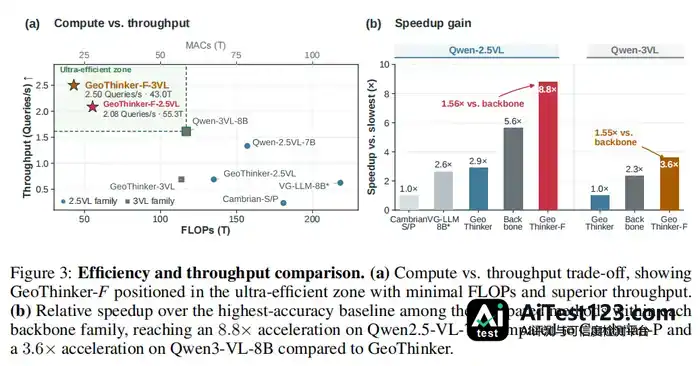
速度方面,完整系统的推理延迟从 1.45 秒降至 0.40 秒,约为 3.6 倍加速。
这项提升来自两方面:一方面,移除推理阶段的外部 VGGT,省去了最大的计算开销;另一方面,团队压缩了空间 Token,减少了信息处理量。正是这两项优化的叠加,才把速度提了上来。
既然视觉语言模型变轻了、变快了,它在需要“即时反应”的下游场景里表现如何? 团队在机器人操作(LIBERO)和自动驾驶(NAVSIM)仿真环境中进行了测试。
在机器人操作仿真环境 LIBERO 中,GeoThinker-F 的任务成功率达到 97.1%,与 GeoThinker(96.7%)基本持平。但更关键的是速度:推理延迟从 254.8 毫秒大幅降至 104.2 毫秒,响应速度提升了一倍多。
在自动驾驶仿真平台 NAVSIM 上,衡量安全性与综合驾驶表现的 PDMS 得分为 83.3 分。虽然略低于 GeoThinker 的 84.4 分,但明显高于专门针对自动驾驶任务的基线模型 ReCogDrive 的 81.9 分。


综合来看,LIBERO 和 NAVSIM 的结果显示,这套方法在具身智能和自动驾驶场景中展现出了极高的应用潜力。不过,这两项实验都在仿真环境中进行,距离真实物理世界中的机器人操作或实际道路驾驶,还需要进一步的验证。

04
从外部几何辅助到模型内部预测,空间智能还要走多远?
GeoThinker 让视觉语言模型学会按需利用几何信息,GeoThinker-F 进一步探索让模型自己生成这些信息。
两项工作把空间推理研究从“几何信息的有效利用”,延伸到了“模型内部的空间表示学习”,也为降低视觉语言模型进行空间推理的成本提供了新的思路。
不过,目前的 GeoThinker-F 依然有它的局限。它生成的空间特征,主要服务于当前场景的几何理解和短期未来视觉信息预测。它还没有建立能够根据动作推演长期场景变化的完整世界模型,也没有证明视觉语言模型已经掌握复杂的物理交互规律。
这意味着,视觉语言模型能自己生成空间信息,并不等于已经理解物理世界。
未来,如何让空间表示进一步支持物理变化预测和动作决策,仍是空间智能需要解决的问题。
GeoThinker:
代码:https://github.com/Li-Hao-yuan/GeoThinker

雷峰网(公众号:雷峰网)
雷峰网














