MiniMax开源图像模型H3-Image:10秒生成4K图,支持CAD与机械拆解
sina qqZone renren ydCloud 0
智东西
编辑 漠影
智东西11月11日消息, MiniMax于前一日深夜推出新一代图像生成模型H3-Image,模型权重同步对外开放。
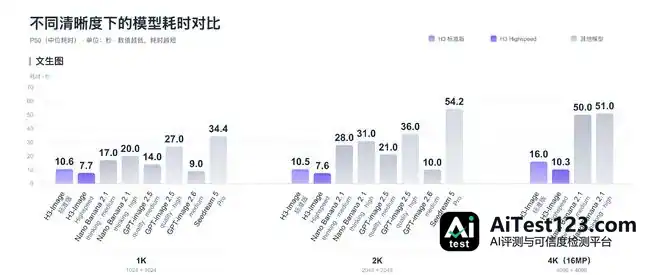
网友实测反馈显示,H3-Image已能与全球顶尖图像生成模型较量,在开源图像模型中处于SOTA水平。速度上,其高速版生成一张4096×4096像素(16MP)的4K高分辨率图像约需10秒,耗时只有市面主流模型的1/5。
H3-Image此次的变化不限于生成速度和画质。模型对复杂指令与视觉信息的理解同样做了加强,最多可融合16张参考图,能处理复杂指令和结构化信息,指令遵循能力在开源模型中居前。
这些能力放到实际任务里能剩多少?我们通过MiniMax海螺和MiniMax Code接入H3-Image,围绕视觉表现、复杂任务理解、多素材参考融合几个方向做了一轮高强度实测。
一、复古漫画到写实摄影,H3-Image视觉表现实测
视觉部分共设五组测试,覆盖真实质感、风格转换、游戏场景复刻、海报文字排版以及16图参考融合能力。
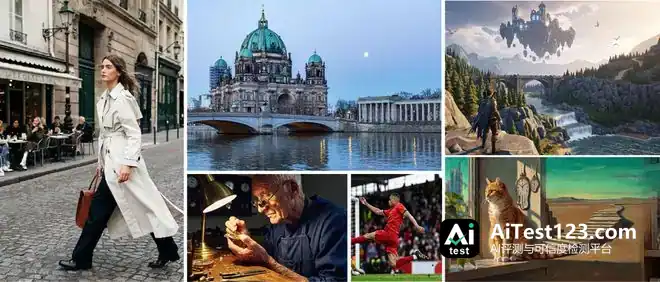
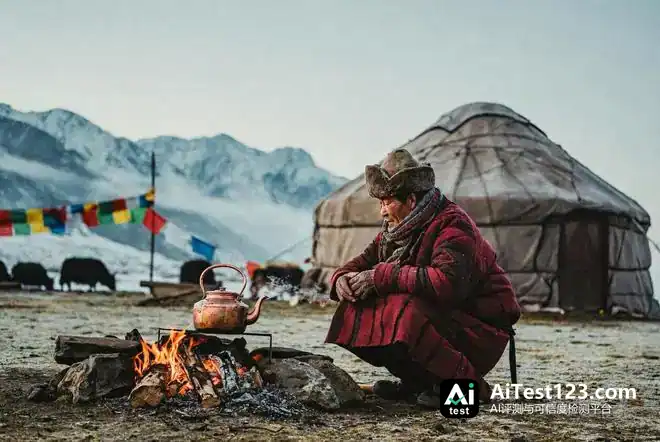
H3-Image能生成带超真实摄影质感的画面。下面几张图若不提前说明,多数人会把它们当作人文纪实的实拍作品:光影质感真实,人物皮肤留着自然纹理和细微瑕疵,环境光落在人物与周围物体上的效果也接近实景,没有常见AI图像那种过度磨皮、锐化和高光堆叠造成的塑料感。
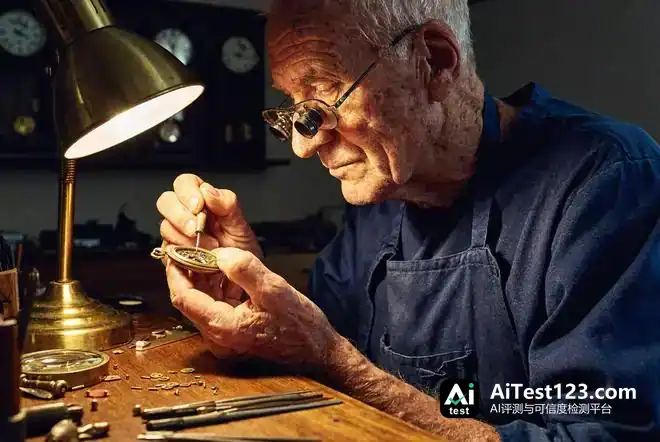
再看这张“自然摄影”。自然摄影在AI图像生成里难度不小,物体运动违背物理规律、动物姿态失真、自然环境细节过于规整,都会露出AI生成的马脚。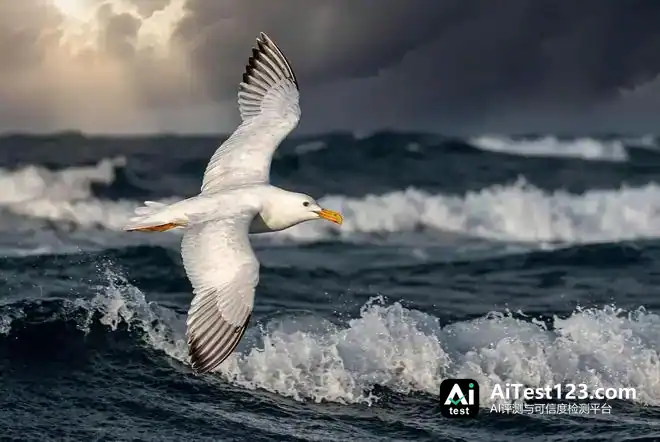
H3-Image生成的画面没有把每个元素都处理得格外清晰,光线、色彩与动态细节一起撑起整体氛围,还带出一点故事感。海鸥掠过浪花的姿态、浪花的层次、整体光影关系都较为协调,看不出明显的结构错乱或AI渲染痕迹,真实度很高。 建筑图像对AI同样不好对付:线条要横平竖直、不能漂移,玻璃幕墙的反射得符合镜面成像规律,不同材质还要呈现对应的质感和反射特性。H3-Image在这几项上都达到一流水平。画面中室内顶灯的透射与室外反射同时存在又互不冲突,模型对光影的理解力在这里体现得比较清楚。
 体育场景里,H3-Image生成的“运动员”身体重心和发力姿态符合真实运动力学,双臂为保持平衡自然张开,大腿因发力而紧绷;背景中身穿黄色球衣的门将侧身飞扑、身体舒展,草皮飞溅。运动题材最考验物理与人体真实性,H3-Image的结果仍达到专业摄影水准。
 下一组测试用同一张橘猫照片,让H3-Image分别转换为毛毡定格动画和超现实主义油画两种艺术风格,考察其风格化能力。
 这组测试还附带了具体制作要求。毛毡风格一项,我们要求模型呈现纤维交织的质感,而非简单加一层模糊。H3-Image把画面中所有元素都做了风格转换,细看连树叶也有纤维毡化后的质感,对提示词的还原相当到位。

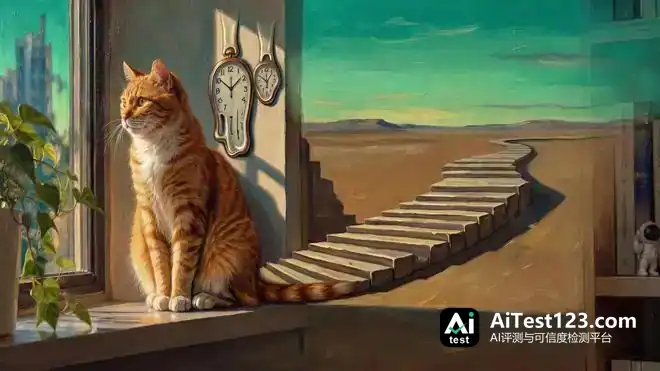
超现实主义风格同样表现不错。提示词里只提到达利式风格,H3-Image便主动补进融化的时钟等标志性元素。室内与荒漠、窗台与悬空阶梯在画面中形成不符合现实空间逻辑的组合,原图的橘猫主体得以保留,场景重组又带出超现实氛围。
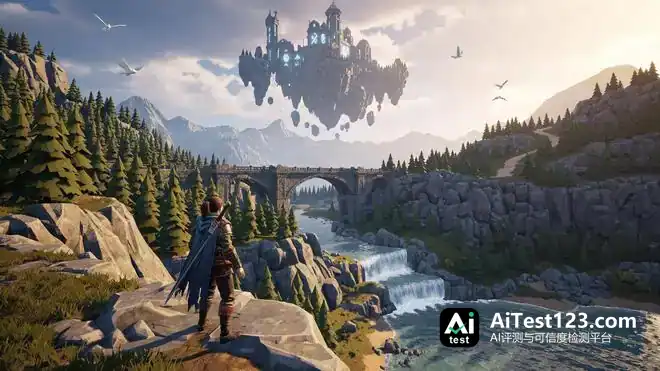
游戏眼下是图像生成模型落地的重要场景,我们也在这一方向上做了几组实测。先看下面这张以《塞尔达传说:旷野之息》为灵感的开放世界游戏画面:原作标志性的低多边形美术风格被还原出来,光影和色彩整体协调,观感接近真实的游戏截图。
让H3-Image做游戏UI的参考设计,它同样能给出像样的结果。我们假想了一款奇幻RPG的需求,要它生成一套完整HUD界面,涵盖血条、技能栏、背包格、小地图和任务追踪面板。生成图里各功能模块的布局符合主流游戏UI的交互逻辑,风格也统一,后续开发可以拿它当参考。 我们还让它设计一把奇幻蒸汽朋克武器,名字叫“蒸汽核心弩炮”,整张图分四个区域:正视图、侧视图、背视图以及局部细节。H3-Image的表现超出预期,四个视图的武器轮廓基本能对上,局部细节图里铆钉和齿轮刻画得很精细。作为概念设计阶段的参考图,这个完成度已经相当高。
 文字生成一直是图像模型容易翻车的环节,中文尤其明显。字数一多,笔画粘连、错字、漏字就跟着来。这个场景里我们先试了难度偏低的海报,要求模型做一张题为「来喝咖啡」的海报,结果所有文字都正确生成,提示词里“少即是多”的设计逻辑也准确执行了。
 接着把难度往上提:画面里要有一个标题、六个编号步骤,以及约100个汉字,还涉及15g、92°C、30秒、2分30秒、1:15等数字和单位。H3-Image交出的结果超出我们预期,标题、六个步骤的文字,连同全部数字和单位都准确生成,文字清晰,图标与对应文字也没有错位。16图参考融合能力有人物、服装、发色和动作的参考图,也有材质图片、配色方案、字体样式、Logo位置示意和排版线框——16张各不相同的素材一次性传上去,就为了出一张乐队巡演海报。
二、复杂任务实测:能拆机械、画CAD,还能解答逻辑题?
前面的测试主要看H3-Image的视觉表现力,可一张好看的图片,并不代表模型真的读懂了图片背后的信息。任务再复杂一些,它还能不能准确完成?
下面就看H3-Image在空间关系、逻辑推理这些方面能给出怎样的答案。
复杂任务测试中,我们把H3-Image接进MiniMax Code这类Harness里使用,由推理能力更强的Agent负责任务拆解与编排,H3-Image只管最终出图。这样搭配,更能发挥它在知识理解和复杂多模态信息输入上的长处。
第一项测试是机械爆炸图。难点在于模型要完成从二维图像到三维空间的转换。MiniMax Code能借助视觉模型定位画面中的错误,最后给出更精准的修改指令。
迭代几次之后,H3-Image生成的爆炸图效果不错:一台吹风机产品的外壳与内部组件被拆成多个独立层次,各部件沿装配方向展开,整体结构关系一目了然,文字与零件的对应关系也明显更清晰了。
第二组测试难度再上一档,直接给模型派了一项完整的工业设计任务。提示词里同时塞进了产品尺寸、外壳材质、显示屏大小、接口位置以及内部模块布局等多项要求,模型要把这些要求落成具体的产品形态。
接到任务后,MiniMax Code没有直接调用H3-Image的出图能力,而是先思考,把提示词里的要求进一步细化。
这类任务有个很容易暴露问题的地方:单独生成一张产品效果图并不难,可模型要同时输出多个视角时,尺寸对不上、接口位置变化,甚至不同视图里产品结构不一致,这些毛病就冒出来了。
下方这张三视图里,H3-Image避开了大部分此类问题,只在显示屏的宽度上出了点纰漏,比例和实际情况有偏差。
为了修掉这个问题,MiniMax Code调用模型写了一个像素测量脚本,把需要修改的位置精准定位出来,最终交付的结果更准确。
最后我们测了H3-Image把复杂信息转成可视化内容的能力。发过去的是一道带多项约束条件的逻辑推理题,模型得先理清题目里的人物、位置和限制条件,再以信息图的形式呈现。
可以看到,模型没有把题目和答案简单堆在一张图上,而是主动把内容拆成条件说明、逐步排除和最终答案等几个区域,将整个推理过程串起来,整张图的信息层级比较清晰。
三、生成速度实现突破,MiniMax开源布局延伸至图像
从前面这些实测看,H3-Image的能力已经不止于生成一张好看的图片。从复刻复杂视觉风格、处理大量文字和参考素材,到理解机械结构、梳理空间关系,它在试着把图像生成从单纯的视觉创作,延伸到更复杂的信息处理和专业任务辅助上。
与此同时,H3-Image也在提升高规格图像的生成效率。它能在10s-20s内生成一张4096×4096像素、约1600万像素的4K图像。我们的实测中,在海螺官网上生成4张4K图片,等待时间也只要1分钟左右。对比之下,目前不少同类模型生成单张相近规格的图片仍要数十秒,部分甚至接近一分钟。
分辨率决定画面能装下多少细节,生成速度则影响这些能力能不能融进日常工作流。产品展示、商业视觉和游戏素材这些场景里,设计人员往往要反复调整构图、修改细节、比较不同方案。
高分辨率生成原本要等很久,H3-Image把这段时间压到了十秒上下。换句话说,高规格的AI视觉创作不再只是偶尔做一两个精品的活计,它有条件变成日常高频使用的生产工具。
技术之外,MiniMax一路开源的策略,也在给这些模型打开更大的应用面。
H3开源之后,不同方向的开发者已经参与进来做生态,模型的改进集中在内存优化、硬件适配和推理效率几处。这次H3-Image把权重开放出来,同样让开发者有了基础,可以围绕图像生成、编辑和多素材融合去做新工具。
往后看,H3-Image会陆续接进各类工作流工具,在agent环境里充当harness的基座图片模型,和其他图像、视频模型搭配使用;也能针对电商商品图、游戏美术、工业设计等场景做定制。再把图像理解、局部编辑和视频生成的能力结合起来,开发者就有机会搭出一条覆盖素材分析、内容生成到后期修改的多模态创作流程。
不过对模型厂商来说,怎么把开发者和企业的使用需求变成商业回报,是个绕不开的现实问题。
MiniMax此前围绕H3走过的路子给出了一种答案:用社区许可协议,对达到一定规模的商业使用,以及部分特定地区的使用者,保留进一步授权的要求。
大企业拿到模型权重,不等于所有需求都解决了。商业使用权限、定制开发、技术支持和部署适配,都可能成为继续合作的理由。英伟达、Pika、fal.ai等公司此前已经在H3视频生成模型上和MiniMax达成授权合作,这说明MiniMax开源模型的商业价值还能延伸到授权和技术合作上。
从H3视频到H3-Image,MiniMax持续把多模态模型的权重开放出来,其实是在试着建立一套周期更长的生态关系:开发者拿模型做二次开发,研究团队去优化模型的效率和适配能力,企业围绕具体业务需求谈定制与授权,API和产品服务则接住更广泛的模型使用需求。
结语:图像模型的“全科竞赛”开始了
眼下的AI领域,不同类型模型之间的能力分化还很明显。文本模型擅长逻辑推理、信息组织和复杂任务处理,视觉审美与艺术表现上却还有空间;视觉生成模型画面质感和艺术表现力出色,但在内容准确性和视觉效果之间常常顾此失彼。
这么看,H3-Image的价值在于它想把逻辑理解和视觉生成捏到一起。在我们的实测中,它确实做成了几件过去单一类型模型兼顾不了的任务。
当然,要真正打通专业信息处理与高质量视觉创作,行业还有不少技术难题待解。但有一点可以确定,图像模型的竞争重点已经变成审美、理解、生成与执行能力的综合比拼。这一次,开源阵营没有缺席。